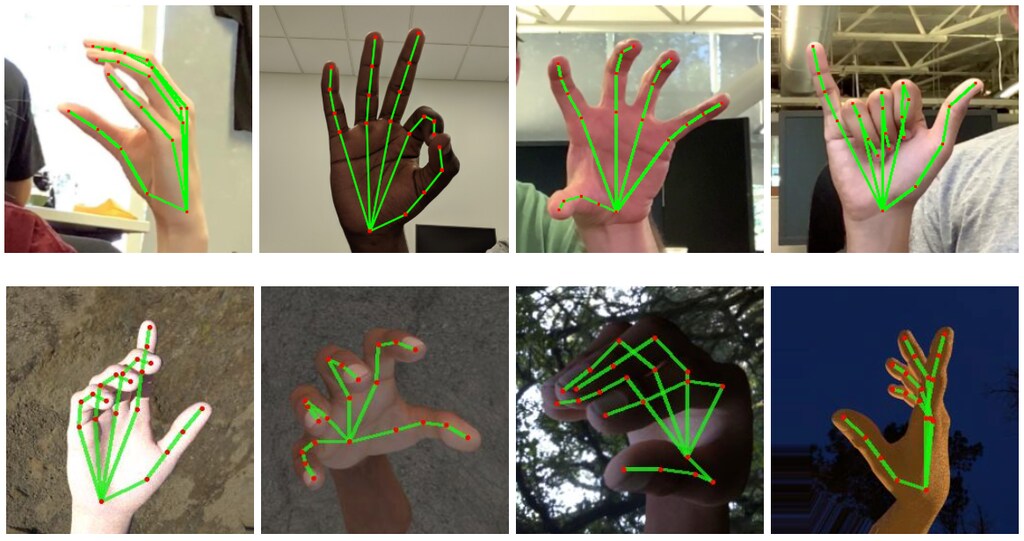
数百万人通过手语交流,但迄今为止,捕捉手语复杂手势并将其转换为口语的项目成效有限。不过,谷歌人工智能实验室在实时手部追踪方面取得的新进展,或许能带来一些人期待已久的突破。
这项新技术运用了一些巧妙的捷径,当然也得益于机器学习系统整体效率的不断提升,只需一部智能手机及其摄像头,就能实时生成手部及所有手指的高精度映射。
谷歌研究人员 Valentin Bazarevsky 和 Fan Zhang 在一篇博客文章中写道:“目前最先进的方法主要依赖强大的桌面环境进行推理,而我们的方法能在手机上实现实时运行,甚至可以扩展到多只手。”他们还写道:“要实现稳健的实时手部感知,计算机视觉面临着相当大的挑战,因为手部经常会遮挡自身或彼此(例如手指与手掌相互遮挡以及双手交叠),而且缺少高对比度的图案。”
此外,手部动作往往速度很快、幅度很细微,或者兼而有之,而这未必是计算机擅长实时捕捉的内容。说到底,要把这件事做好非常困难,而既做好又做快更难。即便使用 SignAll 等机构采用的多摄像头深度感知设备,也难以追踪每一个动作。(但这并没有阻止他们。)
研究人员在此项目中的目标至少部分是减少算法需要筛查的数据量。数据越少,处理速度就越快。
首先,他们放弃了让系统检测整只手的位置和大小的想法。相反,他们只让系统识别手掌。手掌不仅是手部最具辨识度、形状也最稳定的部分,而且近似正方形,因此他们无需担心系统能否处理高瘦的矩形图像、扁短的图像等各种尺寸。
当然,识别出手掌后,手指便从手掌的一端伸出,可以单独分析。另一个算法会查看图像,并为手部标出21个坐标,大致对应关节和指尖,同时估算它们可能离镜头有多远(除其他因素外,还可以根据手掌的大小和角度进行推测)。
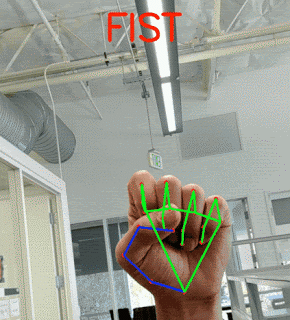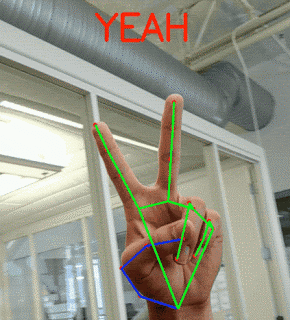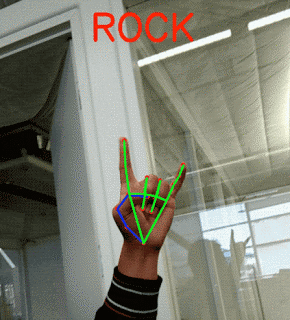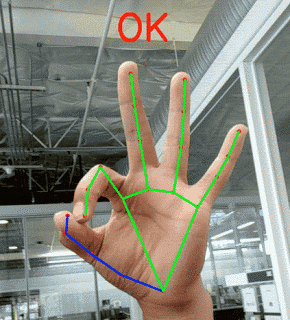
为了完成手指识别这部分工作,他们首先必须在约30,000张不同姿势和光照条件下的手部图像中手动标注这21个点,供机器学习系统读取和学习。一如既往,人工智能要运转起来,离不开人类的辛勤劳动。
确定手部姿势后,系统会将其与一系列已知手势进行比对,从手语中的字母和数字符号,到“和平”和“金属”等手势。
最终得到的手部追踪算法既快速又准确,可在普通智能手机上运行,无需配置强大的桌面电脑或借助云端(也就是别人的高性能桌面电脑)。整套系统运行于 MediaPipe 框架之中,多媒体技术领域的人士或许已经有所了解。
如果一切顺利,其他研究人员就能以此为基础继续开发,或许还能改进现有系统;这些系统需要更强大的硬件,才能完成识别手势所需的手部识别。不过,要真正理解手语,还有很长的路要走。手语会运用双手、面部表情及其他线索,形成一种丰富而独特的交流方式。
这项技术尚未用于任何谷歌产品,因此研究人员可以免费公开他们的成果。任何人都可以在此获取源代码并在此基础上继续开发。
他们写道:“我们希望向更广泛的研究与开发社群提供这项手部感知功能,从而催生富有创意的应用场景,推动新应用和新的研究方向出现。”




