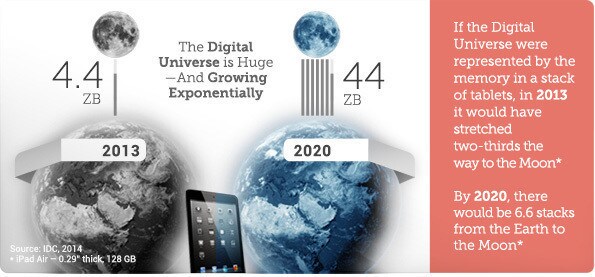
每天,我们都在产生2.5百亿亿字节的数据。经过正确的整理与分析,这些信息有能力为所有人创造更美好的未来。大数据能够准确探测地震、洪水和饥荒,从而在最需要的地方提前调配资源。开放数据有潜力改善教育、医疗保健和金融服务的可及性。
尽管前景可期,数据集仍是人类设计的产物。它反映了其并不完美的创造者的缺陷、偏好与经历。几乎所有数据都由人类定义、解释和处理,而人类常常要就纳入哪些内容作出价值判断。因此,理解数据集中被排除的要素与数据本身同样重要。
作为人类,我们深受确认偏误之害:即倾向于以强化既有观点的方式寻找或解读信息,同时无视任何相悖的证据。一个典型例子是2016年美国总统大选,当时大多数民调机构未能预测唐纳德·特朗普获胜。选举日当天,根据数据,特朗普获胜的几率仅为15%。但专家们忽视了以下诸多因素:投票率模型的不准确性、民调中大学毕业生的比例过高、难以接触人群的影响,以及选民在完全陌生人面前的诚实程度。此类疏漏永远无法通过获取更多数据来避免,而应通过打破过滤气泡来解决,正是这些气泡使我们误以为每个人的想法和行为都与我们一致。
与此同时,更多数据在过去两年中产生的数量,超过了人类历史前5000年的总和。这种加速涌现的新信息,正在加深我们对“可得性启发式”的依赖:即仅依据最近可获取的信息作出决策的倾向。大多数政府、经济学家和记者未能预见2007至2008年的金融危机,因为当时主流的数学模型并未预示经济衰退。要是他们少关注最新数据,多关注金融市场的周期性规律,结果或许会有所不同。
同样,关于某些个人、群体和国家的数据远多于其他对象。这导致了数据鸿沟,在发达国家与发展中国家之间尤为明显。如果我只依赖数据,它会告诉我,我在扎格罗斯山脉的家人并不真实存在。原因很简单:他们无法上网,一生从未填写过任何调查问卷。数据集中语言、文化和地域的代表性不足,会造成叙事失衡,并扭曲对现实的描述。
更糟糕的是,过去往往并不能很好地预示未来。依赖现有体系来在可能毫无信息的地方生成信息,价值甚微,因为这些体系依赖已知变量、稳定性与逻辑。概率学教授纳西姆·塔勒布在其著作《黑天鹅》中探讨了此类不确定性。黑天鹅是一种超出预期范围的异常事件,尽管其发生概率很低,却会从根本上改变历史进程。最耐人寻味的是,一旦有足够的数据可用,人们往往会借助事后诸葛亮的视角为黑天鹅事件找到解释。我们生活在一个充满不确定性、变异与巧合的随机世界中;在这种情况下,数据能够发挥的作用终究有限。
数据只能衡量可以衡量的事物。那些无法衡量的东西又当如何?0和1的二进制数值无法捕捉人类复杂且常常非理性的现实。我们能否可靠地量化爱、善良或幸福?正如社会学家威廉·布鲁斯·卡梅伦所言:“并非所有可以计数的事物都有意义,并非所有有意义的事物都可以计数。”对指标的执念最终演变为量化偏误:即将数字置于一切之上的崇拜。即便数据百分之百准确,它也只能告诉我们正在发生什么,而无法说明原因。缺乏人文层面的理解,数据便失去了背景与细微差别。只有在我们发现潜在的人类情感、行为和动机之后,数字才具有意义。
从纸面上看,数据承诺打造一个信息更充分、联系更紧密、更具包容性的社会。然而,如前所述,我们的思维体系十分脆弱,容易受到偏见的影响。我们往往将数据视为独立于人类影响的客观真理。实际上,数据是人类偏见在算法中的延续。随着我们步入第四次工业革命,信息的激增与人工智能的指数级崛起,让我们有机会设计一个更加平等的社会,因为技术会强化人类的思维。
“为善”的数据需要更新的讨论、全新的思维方式,以及一份新的社会契约,以反映技术的根本性进步。最重要的是,数据需要反映并代表居住在我们星球上的76亿人的多元观点与需求。归根结底,人类文明的未来可能取决于信息的获取是集中在少数人手中,还是向所有人开放。数据并非答案;它只是一种工具,帮助人类发现新问题,创造新可能。




