我们如何确保合成生物学的进步不会以牺牲安全为代价?
DNA计算等新兴产业需要采取积极主动的生物安全与生物安保措施。
具体而言,随着我们创造新的DNA分子,严格筛查高风险序列模式至关重要,但规模问题和缺乏标准化流程构成了重大挑战。
好奇心推动科学家和工程师不断取得进步。随着我们开始构建生物经济(以生物学而非电子技术解决问题,包括构建基于DNA的计算平台),我们必须保持严谨的好奇心——不仅要关注我们能够创造什么,也要关注我们可能无意间释放出什么。
最重要的问题之一是:我们如何确保合成生物学的进步不会以牺牲安全为代价?
我们通常会从生命科学的角度看待生物经济对DNA的运用,例如开发新药或医疗疗法。然而,包括DNA计算在内的新兴产业,在处理某些工作负载方面,相比传统计算机具有巨大优势。DNA计算平台能耗极低,占用空间也小得多。这可能会开启一个新时代:用于计算目的而创造的合成DNA将多于用于生命科学目的的合成DNA。
不妨比较一下:人体基因组中有30亿个DNA碱基对,而我们随身携带的手机里则有数百GB的数字数据。尽管这些新技术带来了机遇,但如果被别有用心者利用,我们仍须警惕其可能造成的意外影响。
负责任的管理要求我们采取积极主动的生物安全与生物安保措施。这包括整个行业采用标准化流程,筛查合成DNA中是否存在已知病原体和毒素,并维护一个动态数据库,以收录新出现和不断演变的公共卫生与安全威胁。
具体而言,随着我们创造新的DNA分子,严格筛查高风险序列模式(即与已知有害序列重叠的特定DNA序列)至关重要。这里的挑战在于我们所处理的信息规模极其庞大。存储在足球场大小的数据中心中的全部信息,都可以转化为一小瓶合成DNA。因此,我们需要制定稳健的策略,确保生成的每一种组合都保持安全。

将数字数据转化为DNA的一种方法是合成,即生成内部存储二进制数据的新DNA链。通过合成,可以创造无限数量的DNA链,将新信息转化为DNA,而每一条DNA链都代表一个潜在的暴露点。
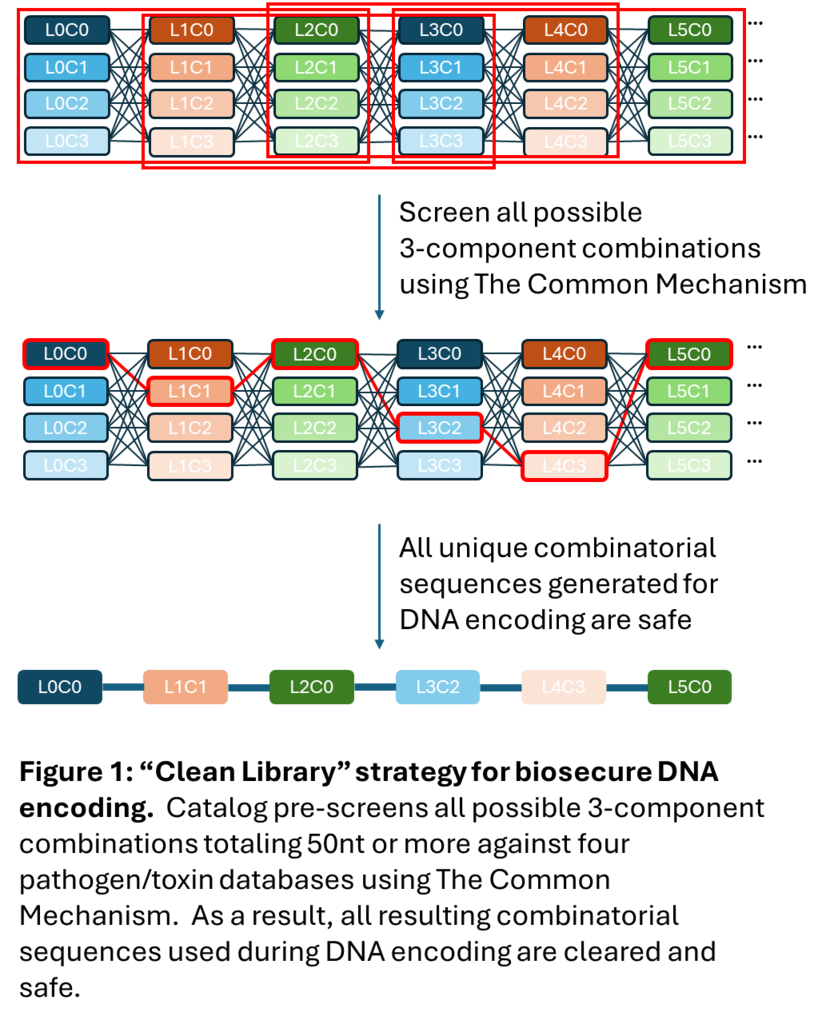
为解决这一问题,我们公司CATALOG率先在所有DNA数据编码中采用“洁净库”。该库包含长度为30–50个碱基对的DNA组件,这些组件以不同方式组合来表示不同的数字信息。可以把这个库想象成字母表中的字母。《牛津英语词典》中的60多万个单词,都是由仅有的26个字母组合而成。
CATALOG这一方法的优势在于,库中每个DNA链的碱基对都经过严格筛查,并已获认证,确认其在生物学上安全。这些碱基对可以用无限种方式组合,无需额外筛查。而采用合成方法时,每次将一条新信息存储在DNA中,都必须筛查其中是否存在生物风险标记。
CATALOG的系统化方法确保我们在扩充库的同时,可以确信不会引入任何危险,并遵循美国卫生与公众服务部制定的筛查建议。
在筛查工作中,我们使用了开源软件套件由国际科学界生物安保与生物安全倡议(IBBIS)开发的Common Mechanism,该软件旨在将DNA序列与一组包含四个风险数据库进行比对。因此,在有新序列加入相应数据库之前,所有使用我们经验证组件集进行的后续DNA编码,均符合IBBIS现行的病原体和毒素筛查标准,被视为安全。必要时会提供更新,且可轻松下载到本地。
展望未来,不应让创造者独自承担持续监测和调整工具的责任,以确保自己的创作安全。事实上,目前主动监测有害序列的合成DNA公司,都是自愿开展这项工作,且没有统一的实践规范。许多公司往往有经济动机,甚至负有信托责任,会选择最直接的盈利途径,而这与社会的长远利益并不一致。
此外,不法分子仍在不断制定新策略,试图绕过现有的生物安全筛查工具,以合成DNA用于不法目的。如何识别这些人员并将其意图告知有关部门,为本行业增添了另一层责任。
今年9月,我们在日内瓦与世界各国领导人举行讨论,活动由世界经济论坛、IBBIS和流行病防范创新联盟(CEPI)共同主办。这些讨论凸显了这一挑战的复杂性及其全球性。生物经济是一项跨越国界与学科的协作事业。然而,在呼吁行业采取行动加强生物安全与生物安保方面,相关激励措施仍落后于创新激励。
我们必须与科学家、政策制定者和行业领袖携手合作,确保建立一套稳健的制衡体系,使其能够持续扩展和演进,与DNA经济中不断涌现的技术能力同步发展。




