在地球上,数字数据总量约为10万亿GB,并且随着人类产生的数据越来越多,这一数字每天都在迅速增长。
EB级数据中心存放着大量此类数据,建造和维护成本约为10亿美元。
麻省理工学院的科学家正在研究一种更有效的DNA数据存储方法,DNA能以极高的密度容纳海量数据。
尽管这项研究前景广阔,但在DNA能够成为可行的存储介质之前,仍需要更多的知识积累。
目前,地球上约有10万亿GB的数字数据,而且每天,人类产生的电子邮件、照片、推文和其他数字文件还会额外增加250万GB的数据。这些数据大多存储在被称为EB级数据中心的大型设施中(1EB等于10亿GB),这类设施的占地面积可相当于数个足球场,建造和维护成本约为10亿美元。
许多科学家认为,替代方案在于承载我们遗传信息的分子:DNA。DNA在进化过程中形成了以极高密度存储海量信息的能力。麻省理工学院生物工程教授马克·巴特(Mark Bathe)表示,理论上,一个装满DNA的咖啡杯就能存储全球所有的数据。
“我们需要新的解决方案,来存储世界正在积累的这些海量数据,尤其是档案数据。”巴特说道。他同时也是麻省理工学院与哈佛大学布罗德研究所的副会员。“DNA的密度甚至比闪存高出上千倍。另一个有趣的特性是,一旦合成DNA聚合物,它就不消耗任何能量。你可以写入DNA,然后永久保存。”
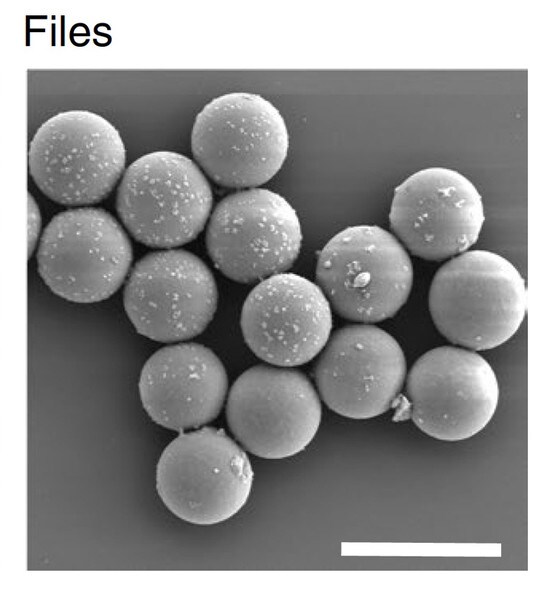
科学家们已经证明,他们能够将图像和文本页面编码为DNA。然而,还需要一种简便的方法,从众多DNA片段的混合物中挑出所需文件。巴特及其同事现已展示了一种实现方式:将每个数据文件封装在一个6微米的二氧化硅颗粒中,并用揭示其内容的短DNA序列对颗粒进行标记。
借助这一方法,研究人员证明,他们能够从20张图像的集合中准确提取出以DNA序列存储的单张图像。考虑到可用标签的数量,该方法可扩展至1020个文件。
巴特是这项研究的资深作者,该研究今日发表于《Nature Materials》。该论文的主要作者为麻省理工学院高级博士后詹姆斯·巴纳尔(James Banal)、麻省理工学院前研究助理泰森·谢泼德(Tyson Shepherd)以及麻省理工学院研究生约瑟夫·贝勒安特(Joseph Berleant)。
稳定存储
数字存储系统将文本、照片或任何其他类型的信息编码为一系列0和1。同样的信息也可以用构成遗传密码的四种核苷酸(A、T、G和C)编码到DNA中。例如,G和C可用于表示0,而A和T可表示1。
DNA还具有其他一些使其成为理想存储介质的特性:它极其稳定,而且合成和测序虽然成本高昂,但相对容易。此外,由于其密度极高——每个核苷酸相当于最多两个比特,体积约为1立方纳米——以DNA形式存储的1EB数据可以放入你的手掌中。
这种数据存储方式的一大障碍在于合成如此大量DNA的成本。目前,将1PB数据(100万GB)写入DNA需要花费1万亿美元。若要与常用于存储档案数据的磁带相竞争,巴特估计,DNA合成成本需要下降约六个数量级。巴特表示,他预计这一目标将在十年或二十年内实现,这与过去几十年间闪存驱动器的存储成本大幅下降的情形相似。
除成本之外,使用DNA存储数据的另一个主要瓶颈在于,难以从所有文件中挑出你所需要的那一个。
“假设写入DNA数据的技术发展到能够以经济可行的成本写入1EB或1ZB数据,那又会怎样?你将拥有一堆DNA,里面是数不清的文件、图像、影片及其他内容,而你需要找到你想要的那一张图片或那一部影片。”巴特说道,“这就像大海捞针。”
目前,DNA文件通常使用PCR(聚合酶链式反应)进行检索。每个DNA数据文件都包含一段能与特定PCR引物结合的序列。要提取某个特定文件,就需向样本中加入该引物,以寻找并扩增目标序列。然而,这种方法的一个缺点是,引物与非目标DNA序列之间可能发生交叉反应,导致提取出不需要的文件。此外,PCR检索过程需要使用酶,并且最终会消耗掉池中大部分的DNA。
“这有点像为了找到针而烧掉了整个干草堆,因为其他所有DNA都没有被扩增,而你基本上是把它们扔掉了。”巴特说道。
文件检索
作为另一种方法,麻省理工学院团队开发了一种新的检索技术,即将每个DNA文件封装到一个小型二氧化硅颗粒中。每个胶囊都标有与文件内容相对应的单链DNA“条形码”。为了以经济有效的方式演示这一方法,研究人员将20张不同的图像编码为长约3,000个核苷酸的DNA片段,相当于约100字节。(他们还表明,这些胶囊可以容纳最大1GB的DNA文件。)
每个文件都标有与“猫”或“飞机”等标签相对应的条形码。当研究人员想要提取特定图像时,他们会取出一部分DNA样本,并加入与其所需标签相对应的引物——例如,对于一张老虎图像,使用“猫”“橙色”和“野生”;对于一只家猫,则使用“猫”“橙色”和“家养”。
引物带有荧光或磁性颗粒标记,便于从样本中提取并识别任何匹配项。这使得目标文件能够被取出,同时保留其余DNA以便放回存储。他们的检索过程允许使用布尔逻辑语句(例如“总统 AND 18世纪”)来生成结果,得出乔治·华盛顿的图像,这与使用谷歌图片搜索所检索到的结果类似。
“就目前的概念验证阶段而言,我们的搜索速率为每秒1千字节。我们文件系统的搜索速率取决于每个胶囊的数据量,而这目前受限于在DNA上写入哪怕100兆字节数据的高昂成本,以及我们能够并行使用的分拣器数量。如果DNA合成变得足够便宜,我们就能够最大化每个文件的数据量,从而使用我们的方法存储更多数据。”巴纳尔说道。
对于条形码,研究人员使用了来自哈佛医学院遗传学和医学教授斯蒂芬·埃尔奇(Stephen Elledge)所开发的文库中的单链DNA序列。该文库包含100,000条序列,每条约25个核苷酸长。如果每个文件贴上两个此类标签,即可对1010(100亿)个不同文件进行唯一标记;如果每个文件贴上四个标签,则可对1020个文件进行唯一标记。
哈佛医学院遗传学教授乔治·丘奇(George Church)将该技术描述为“知识管理和搜索技术领域的一次巨大飞跃”。
世界经济论坛在应对第四次工业革命方面正在开展哪些工作?
前沿技术与创新中心汇聚科学家、政策制定者和商界领袖,共同理解新兴技术及其现实影响。
该中心通过促进合作与实验,帮助合作伙伴将研究中的创新转化为实际应用,以应对全球共同面临的挑战。
“DNA形式的书写、复制、读取以及低能耗档案数据存储的快速进展,使得从庞大的(1021字节,ZB级)数据库中精确检索数据文件的机遇仍未得到充分探索。”未参与该研究的丘奇说道。“这项新研究利用一层完全独立的DNA外层,并借助DNA的不同特性(杂交而非测序)以及现有的仪器和化学方法,对此问题做出了出色的解决。”
巴特设想,这种DNA封装方法可用于存储“冷”数据,即保存在档案库中、不经常访问的数据。他的实验室正在孵化一家名为Cache DNA的初创公司,目前正在开发DNA长期存储技术,既用于长期的DNA数据存储,也用于近期的临床及其他现有DNA样本存储。
“虽然DNA要成为可行的数据存储介质可能还需要一段时间,但如今对于来自新冠检测、人类基因组测序及其他基因组学领域的现有DNA和RNA样本,已迫切需要低成本、大规模的存储解决方案。”巴特说道。
该研究由美国海军研究办公室、美国国家科学基金会以及美国陆军研究办公室资助。




