在多家研究合作伙伴的协助下,DeepMind发布了一个数据库,其中包含人体几乎所有蛋白质的结构。
这些结构由AlphaFold通过计算方法确定,AlphaFold是一种突破性的蛋白质折叠系统。
该数据库对所有人免费开放,有望成为生物学和医学领域的变革性工具。
DeepMind与多家研究合作伙伴发布了一个数据库,其中包含人体几乎所有蛋白质的三维结构,这些结构由去年展示的突破性蛋白质折叠系统AlphaFold通过计算方法确定。这一可免费获取的数据库为数百个学科和领域的科学家带来了巨大的进步与便利,很可能将成为生物学和医学新阶段的基础。
AlphaFold蛋白质结构数据库是DeepMind、欧洲生物信息学研究所及其他机构合作的成果,包含数十万条蛋白质序列及其由AlphaFold预测的结构,计划还将新增数百万条,以打造“全球蛋白质年鉴”。
“我们认为,这项工作代表了迄今为止人工智能对推动科学知识进步所作出的最重要贡献,也是人工智能能够为社会带来何种益处的一个极佳范例,”DeepMind创始人兼首席执行官戴密斯·哈萨比斯(Demis Hassabis)表示。
从基因组到蛋白质组
如果您对蛋白质组学并不熟悉——如果确实如此,这也非常正常——那么理解这一问题的最佳方式或许是借助另一项重大工程:人类基因组测序。您或许还记得,在90年代末和21世纪初,这是由全球众多科学家和机构历经多年共同开展的一项巨大工程。基因组终于完成,对无数疾病的诊断与认识以及相关药物和治疗方法的研发都发挥了关键作用。
然而,这只是该领域工作的开端,就像完成了一幅巨大拼图的所有边角料。在那些年里,人们将目光投向的下一个大型项目之一,是理解人类蛋白质组——即人体所使用、并编码于基因组中的全部蛋白质。
蛋白质组的难点在于它要复杂得多,复杂得多。蛋白质与DNA一样,都是由已知分子构成的序列;在DNA中,这些分子是少数几种常见碱基(腺嘌呤、鸟嘌呤等),而在蛋白质中,则是20种氨基酸(基因中每种氨基酸均由多个碱基编码)。仅此一点就已大大增加了复杂性,但这只是开始。这些序列并非简单的“代码”,而是会扭曲并折叠成微小的分子折纸机器,在我们体内完成各种各样的任务。这就好比从二进制代码进入一种能够在现实世界中呈现出实体事物的复杂语言。
实际上,这意味着蛋白质组不仅包含约20000条由数百个氨基酸组成的序列,每一条序列还都具有特定的物理结构和功能。理解这些蛋白质最困难的部分之一,是弄清楚给定序列会形成何种形状。这通常通过X射线晶体学等实验方法完成,这是一个漫长而复杂的过程,若有最好的实验室和技术条件,解析单个蛋白质也可能需要数月甚至更长时间。结构也可以通过计算进行预测,但在AlphaFold出现之前,这一方法从未足够可靠,无法真正依赖。
令学科界猝不及防
在此不赘述计算蛋白质组学的全部历史(尽管我很想这样做),我们基本上是从15年前的分布式暴力计算方法——还记得Folding@home吗?——发展到过去十年中更加精细的流程。随后,基于人工智能的方法登上舞台:2019年,DeepMind的AlphaFold以远超世界上其他所有系统的表现引起轰动;2020年,它又实现了一次飞跃,准确性和可靠性达到了足够高的水平,以至于一些专家宣布,将任意序列转化为三维结构的问题已经解决。
我之所以将这段漫长的历史压缩成一段文字,是因为它当时已被广泛报道,但很难夸大这一进展的突然性和彻底性。这是一个数十年来难倒世界上最顶尖头脑的问题,而它在一年之内就从“我们或许有一种大体可行的方法,但速度极慢且成本高昂”发展到“准确、可靠,并且可以用现成的普通计算机完成”。
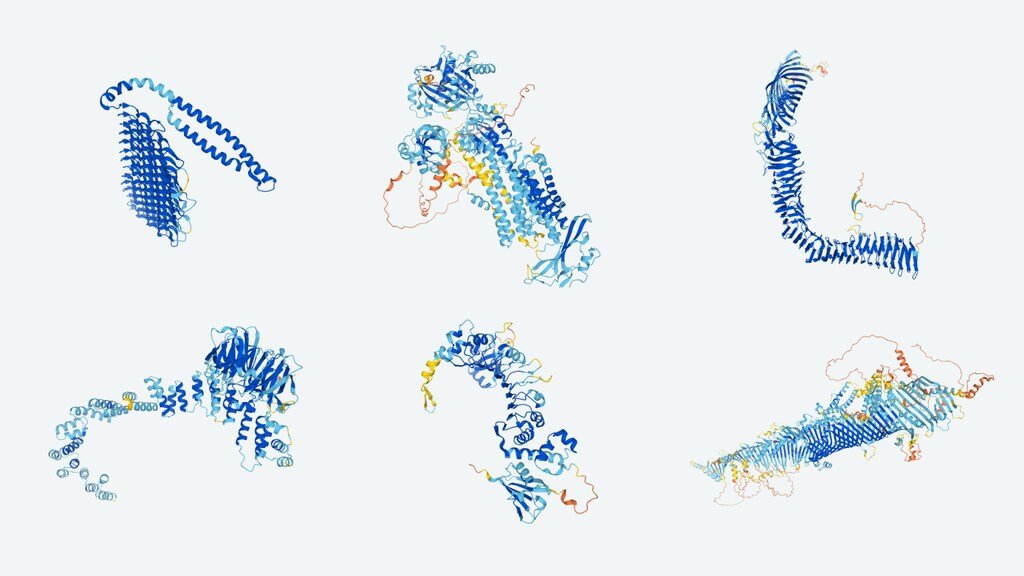
至于DeepMind的具体进展及其实现方式,我将留给计算生物学和蛋白质组学领域的专家去探讨,毫无疑问,他们将在未来数月乃至数年间对这项工作进行深入剖析和持续改进。今天我们关注的是实际成果:自AlphaFold 2(2020年展示的版本)发布以来,该公司所投入的时间不仅用于调整模型,更用于对其能够获取的每一条蛋白质序列进行运行……
结果是,人类蛋白质组中现已有98.5%被“折叠”,正如业内人士所说,这意味着该人工智能模型已对其预测的结构有足够的把握(更重要的是,我们对其可信度有足够的把握)——这些结构是真实可靠的。顺便一提,他们还对另外20种生物(如酵母和大肠杆菌)的蛋白质组进行了折叠,总计约35万个蛋白质结构。这无疑是——以数量级计——关于这一极为关键信息的最大、最优质的集合。
所有这些内容都将以可自由浏览的数据库形式提供,任何研究人员只需输入序列或蛋白质名称,即可立即获得三维结构。有关该过程和数据库的详细信息,可参阅今天在《自然》(Nature)期刊上发表的一篇论文今天在《自然》(Nature)期刊上发表的一篇论文。
“明天你们看到的数据库就是一个搜索栏,几乎就像谷歌搜索蛋白质结构一样,”哈萨比斯在接受TechCrunch采访时表示,“你可以在三维可视化工具中查看,缩放浏览,查询基因序列……而与EMBL-EBI合作的好处在于,它与该机构的所有其他数据库相连。因此你可以立即查看相关基因,它还与所有这些其他数据库相连,你可以看到相关基因、其他生物中的相关基因,以及具有相关功能的其他蛋白质,等等。”
“作为一名科学家,我自己也在研究一种几乎难以想象的蛋白质,”EMBL-EBI的艾迪丝·赫德(Edith Heard)表示(她并未说明是哪种蛋白质),“能够在如此短的时间内了解蛋白质的关键功能部位,这真是令人振奋——过去这需要数年。因此,能够获取其结构并说‘啊哈,这个就是关键功能部位’,然后便可以专注于研究该关键部位的作用。我认为这将使科学研究以年为单位加速推进,就像几十年前的基因组测序一样。”
这一做法的理念是如此新颖,以至于哈萨比斯表示,他完全预计整个领域都将发生变化,数据库也将随之改变。
“结构生物学家尚不习惯这样一种想法:他们可以在几秒钟内查询任何内容,而无需花费数年时间通过实验来确定这些结构,”他说,“我认为这应当会催生全新类型的研究方法,以及可以提出的问题和可以开展的实验。一旦我们开始察觉到这一点,我们或许会开始构建其他工具,以满足这类偶然发现的需求:如果我想研究10000个以某种特定方式相关的蛋白质,该怎么办?目前并没有一种常规方法可以做到这一点,因为目前没有人会提出这样的常规问题。因此,我想我们将不得不开始开发新工具,而一旦我们看到人们如何使用这一工具,对此类工具的需求自然就会出现。”
这包括该软件本身的衍生版本和逐步改进的版本,该软件已以开源形式发布,并附有大量开发历史记录。我们已经看到,华盛顿大学贝克实验室(Baker Lab)的研究人员独立开发了一个系统——RoseTTAFold,该系统以AlphaFold去年的表现为基础进行推断,开发出了一个类似但效率更高的系统——尽管DeepMind似乎凭借其最新版本再次领先。但有人指出,关键技术已经公开,供所有人使用。




