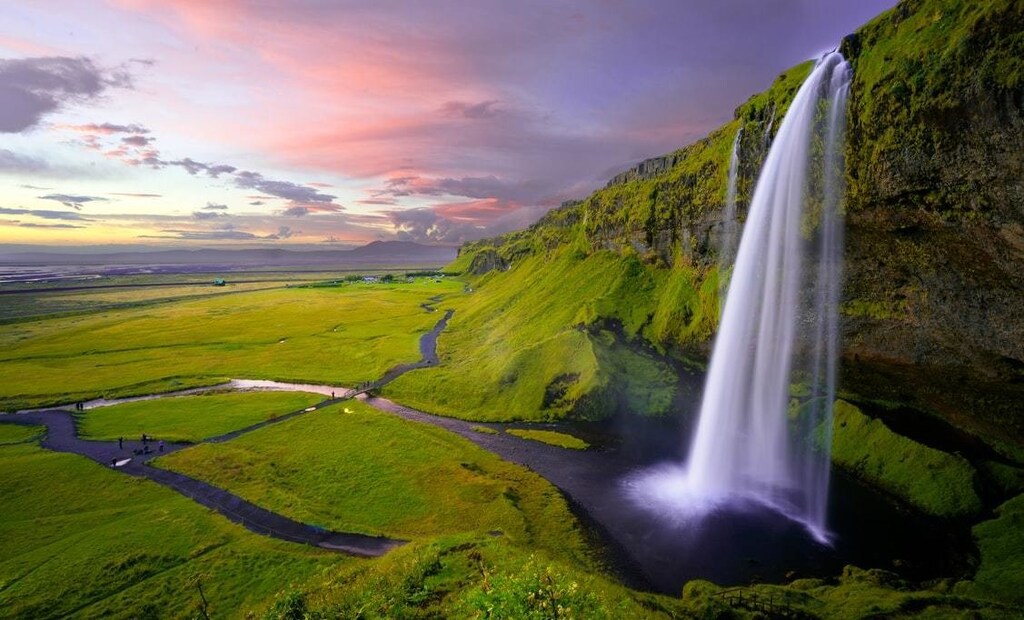
一种新的深度学习方法,可以仅凭一张照片,让瀑布、烟雾或云朵等动态素材动起来。
该技术会预测拍摄照片时物体的运动状态,然后利用这些信息生成动画。
该方法也无需用户输入任何内容或额外信息。
未来,它还可用于让人物的头发随风飘动的效果动画化。
有时照片无法真正捕捉场景的神韵。如果尼亚加拉瀑布的那张度假照片中的水流能够动起来,效果会精彩多少呢?
一种新的深度学习方法正好可以做到这一点:只需输入一张瀑布照片,系统就能生成一段视频,展现水流倾泻而下的景象。唯一缺少的,就是水声的轰鸣和水雾扑面的感觉。
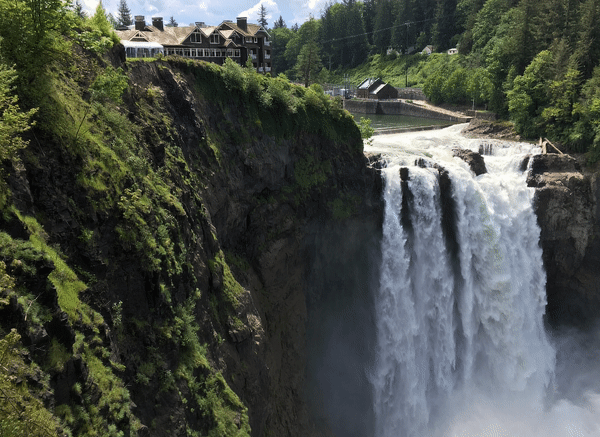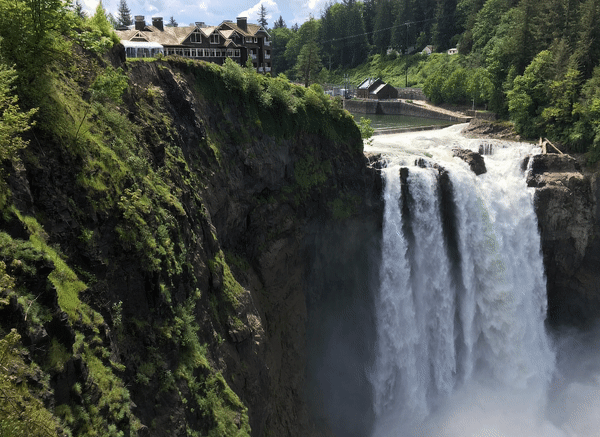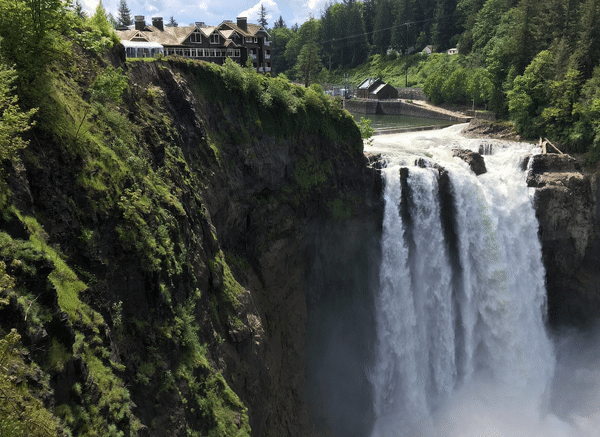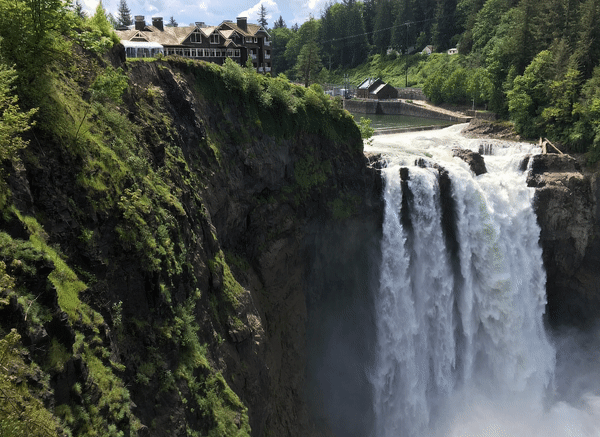
该技术可生成一段无缝循环的短视频,营造出仿佛运动永不停歇的effect。研究人员将在计算机视觉与模式识别会议上展示这一方法。
“一张照片捕捉的是凝固在时间中的一刻。但静态图像会丢失大量信息。是什么导致了这一刻的发生?事物又在如何变化?回想一下你上一次被某个非常有趣的事物深深吸引的情景——很可能它并非完全静止不动,”第一作者、华盛顿大学保罗·G·艾伦计算机科学与工程学院的博士生Aleksander Hołyński说道。
Hołyński表示:“我们这种方法的特别之处在于,它无需用户输入任何内容或额外信息。”他接着说:“你只需要一张图片。它输出的是一段高分辨率、无缝循环的视频,而且往往看起来就像真实视频一样。”
拍一张照片,生成一段视频
要开发一种能将单张照片转化为逼真视频的方法,一直是该领域的一项挑战。视频。Hołyński表示:“这实际上要求你去预测未来。”他接着说:“而在现实世界中,接下来可能发生的事情几乎有无限种可能。”
该团队的系统由两部分组成:首先,它预测拍摄照片时物体的运动状态,然后利用这些信息生成动画。
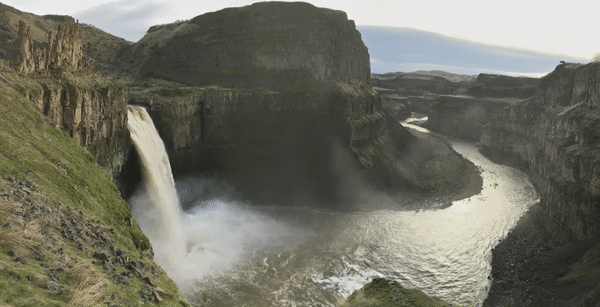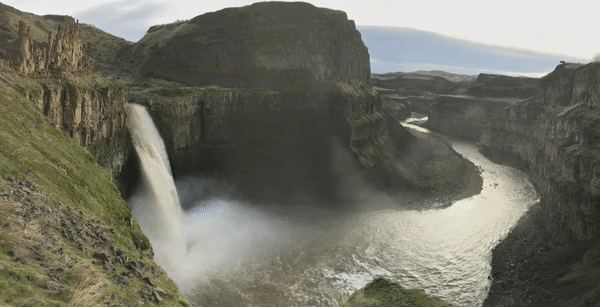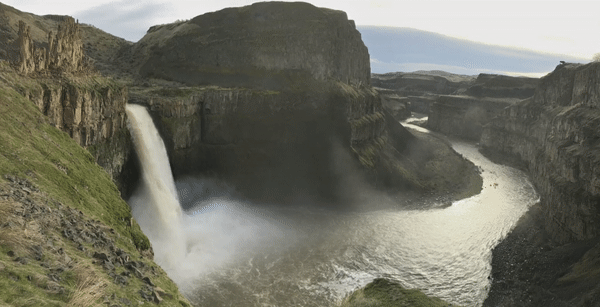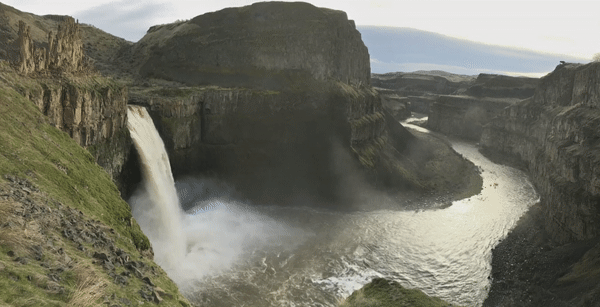
为估算运动状态,该团队用数千段瀑布、河流、海洋以及其他具有流体运动特征的素材视频训练了一个神经网络。训练过程是让网络仅根据第一帧画面推测视频中的运动。将其预测结果与实际视频对比后,网络学会了识别线索(例如溪流中的涟漪),以帮助其预测接下来发生的事情。随后,该团队的系统利用这些信息来判定每个像素是否移动以及如何移动。
研究人员尝试使用一种名为“溅射”(splatting)的技术为照片制造动画。该方法会根据每个像素的预测运动来移动它。但这带来了一个问题。
“想象一下奔流而下的瀑布,”Hołyński说道,“如果只是把像素沿着瀑布向下移动,视频播放几帧之后,顶部就将没有任何像素了!”
因此,该团队提出了“对称溅射”。本质上,该方法会同时预测图像的未来和过去,然后将两者合并为一段动画。
“回到瀑布的例子,如果我们回溯到过去,像素就会沿瀑布向上移动。因此,我们会在靠近底部的位置开始看到一个空洞,”Hołyński说道,“我们会整合这两段动画的信息,从而确保扭曲后的图像中永远不会出现明显的大面积空洞。”
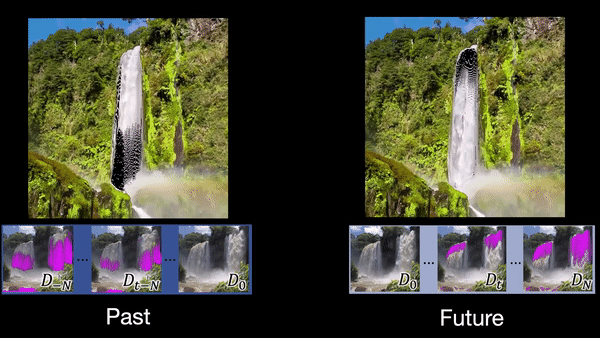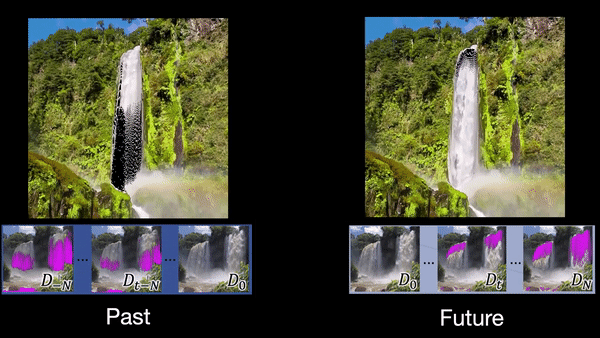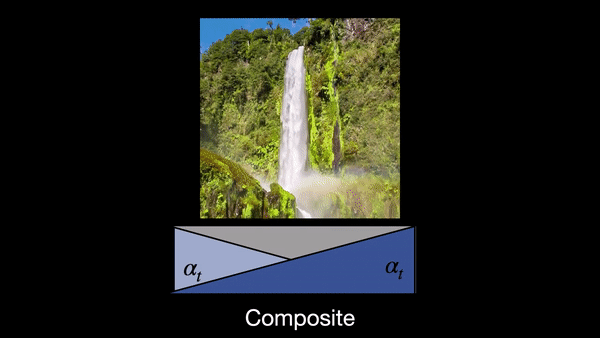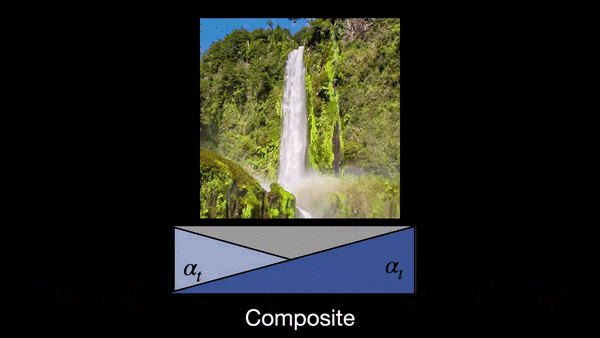
最后,研究人员希望其动画能够无缝循环播放,从而呈现持续运动的效果。该动画网络采用了一些技巧以保持画面整洁,包括在不同时间过渡画面的不同部分,并根据每个像素周围的环境决定其融合速度的快慢。
头发随风飘动
该团队的方法最适用于具有可预测流体运动的物体。目前,该技术难以预测倒影应如何运动,或水流如何扭曲其下方物体的外观。
“看到瀑布时,我们知道水应该如何流动。火焰或烟雾也是如此。这些运动遵循相同的物理定律,而且图像中通常存在一些线索,告诉我们事物应该如何运动,”Hołyński说道。
“我们非常希望将这项工作扩展到更广泛的物体上,比如让人的头发随风飘动。我希望最终我们与朋友和家人分享的照片不再是静态图像,而是全部变成动态动画,就像我们的方法所生成的那些一样。”
华盛顿大学现实实验室、Facebook、Google、Futurewei 和 Amazon 资助了这项工作。




