小型语言模型(SLM)正日益受到关注,因为企业认为它们是采用人工智能的一种高效且经济实惠的方式。
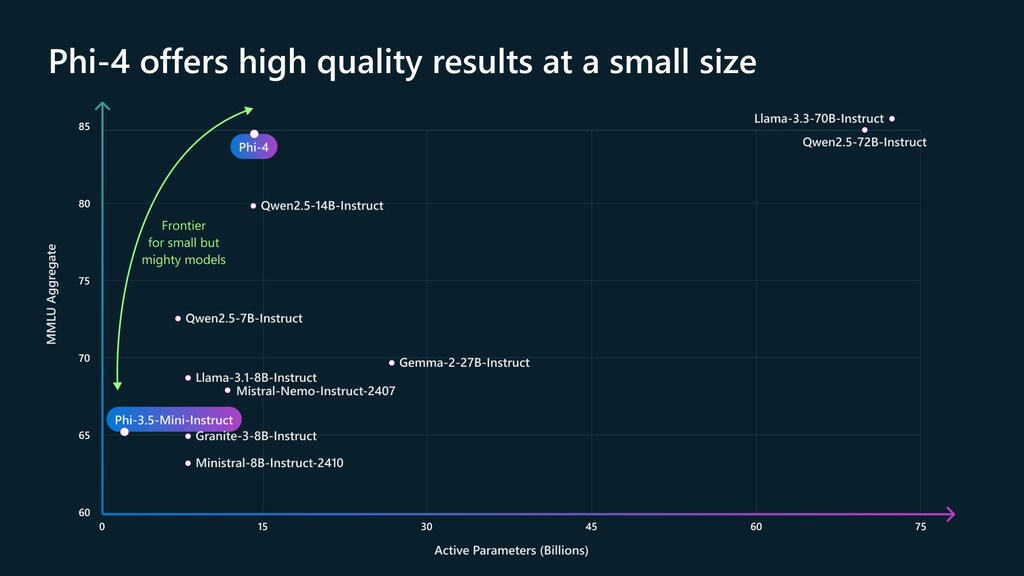
微软刚刚发布了 Phi-4,并表示它在数学推理方面的表现优于更大的模型,同时也能执行自然语言处理任务。
Meta副总裁兼首席人工智能科学家 Yann LeCun 告诉世界经济论坛,SLM也有助于缩小人工智能领域的语言多样性差距。
Llama、Phi、Mistral、Gemma 和 Granite 听起来或许像一支新晋超级英雄战队,但它们实际上都是小型语言模型(SLM)的例子。这些轻量级强者开始在人工智能领域展现出超出其规模的实力。
大型语言模型(LLM)一直占据新闻头条,企业正日益认识到SLM的战略价值,将其视为实施人工智能时更有针对性、更高效且更经济实惠的方案。
Nandan Nilekani(印孚瑟斯董事长兼联合创始人)告诉《金融时报》,成本考量和数据隐私问题等多种因素推动了这一转变。
“看看大型企业,它们都在说:‘我们如何掌握自己的人工智能发展方向?’基于非常具体的数据训练的小型语言模型实际上相当有效……每个人都会构建模型,但我认为不必构建这些庞然大物。”
世界经济论坛如何为人工智能制定防护规则?
人工智能卓越中心汇聚各行业的领导者,帮助他们理解人工智能的迅速演进及其对经济和社会的影响。该中心支持围绕人工智能应用带来的机遇、风险和权衡开展知情对话。
通过可信赖的交流空间和协作倡议,该中心助力合作伙伴增进共识,并共同探索负责任的人工智能创新与应用方式。
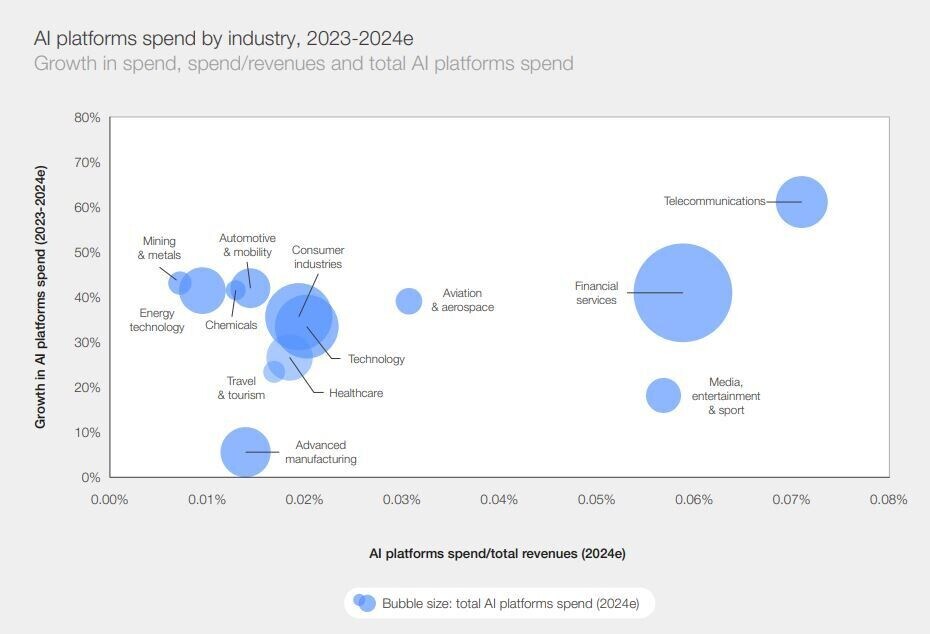
世界经济论坛人工智能治理联盟刚刚发布了旗舰白皮书系列《人工智能时代的产业转型》,探讨各行业采用人工智能的情况,重点介绍不同的路径、投资水平以及各行业面临的挑战。
《人工智能行动:超越实验,推动产业转型》指出,整合支持人工智能的手持设备、先进的边缘人工智能和“紧凑型”语言模型,有望通过自动执行任务、管理日程和提供实时信息,彻底改变工作方式。
“这些创新有助于更快地做出更明智的决策、实现有效沟通并提升工作效率。即时获取关键信息能够改善个人和职业决策。这一转变很可能重塑个人和企业的运作方式,其影响堪比互联网带来的变革。”
什么是小型语言模型(SLM)?
与大型语言模型类似,例如为 OpenAI 的 ChatGPT 提供支持的 GPT-4,SLM能够理解和生成自然语言,并以大型语言模型所用人工神经网络的精简版本为基础构建。
但SLM旨在擅长特定任务。它们基于聚焦的数据集进行训练,因此在分析客户反馈、生成产品描述,甚至处理行业专用术语等任务上效率很高。
所有语言模型都使用参数,即可调整的设置,使模型能够从数据中学习并进行预测。SLM的参数数量显著少于大型语言模型,从而提升了速度和效率。
因此,虽然 GPT-4 等大型语言模型可以拥有超过1750亿个参数,但SLM的参数数量通常从数千万到不到300亿不等。
这种精简架构使SLM能够以远低于大型模型的算力,在客户服务聊天机器人和虚拟助手等特定领域执行自然语言处理任务。
SLM的紧凑设计通过多种技术实现,例如知识蒸馏、剪枝和量化。这些方法使SLM能够以更少的处理能力保留大型模型的核心功能,因此非常适合资源受限的环境,例如边缘设备和移动应用。
SLM对企业有哪些益处?
SLM更有针对性的方法不仅能提高准确性,还能回应人们对数据隐私和控制权的担忧。使用SLM有助于企业更好地管理数据,并减轻使用大型语言模型可能引发的版权问题。
2024年12月,微软发布了 Phi 系列最新的小型语言模型 Phi-4。微软表示,该模型“在数学相关推理方面优于同类及更大型模型”,同时也能够执行常规语言处理任务。
据微软介绍,SLM还具有以下优势:
训练和响应速度更快:由于参数较少,SLM可以更快地完成训练,并在实时应用中更迅速地响应。
降低能耗:SLM的架构更小,因此能耗更低,也更加环保。
经济实惠:较低的计算需求和能耗意味着运营成本降低。
提升特定领域任务的表现:SLM可针对特定应用进行定制,因此在狭窄领域中有望实现更高的准确性。
兼容边缘设备:SLM体积小巧,可部署在边缘设备上,从而实现本地处理并降低延迟。
SLM如何帮助缩小人工智能领域的语言多样性差距
SLM也为解决人工智能领域的语言多样性差距带来了机会。目前,大多数人工智能聊天机器人仅使用全球7000多种语言中的约100种进行训练,且明显偏向英语。
这一局限可能导致数十亿人被排除在数字经济之外。SLM能够专注于特定语言或方言,有望弥合这一差距,打造更具包容性的人工智能系统。
例如,Meta迄今最小的开源模型 Llama 3.2 1B 和 3B就具备多语言文本生成能力。
在世界经济论坛可持续发展影响力会议(SDIM)上,Meta副总裁兼首席人工智能科学家 Yann LeCun 于2024年9月以塞内加尔的数字医疗为例,说明多语言人工智能对于弥合差距的必要性。
Kera Health 等人工智能平台让人们能够“与人工智能助手交谈,但它必须会说沃洛夫语,除了法语之外,还要会说塞内加尔的另外三种官方语言”。
LeCun表示,开源人工智能——“人工智能领域的‘维基百科’”——能够推动变革,让人们构建服务当地居民的系统,并促成合作伙伴关系。
“例如,Meta与印度政府建立了合作关系,让未来版本的[Llama]至少能说印度全部22种官方语言,或许还能说数百种地方语言和方言。”

《人工智能行动》白皮书指出,人工智能驱动的通用翻译有望通过提供跨语言和方言的精准、专业级翻译,改变全球互动方式。
“它打破沟通壁垒,促进包容性,并扩大地方文化的传播范围。这项技术能够让学习资料普遍可及,从而平等地提供教育机会;通过有效的多语言沟通改善医疗服务;并通过简化协作和贸易支持全球商业发展。
“它通过艺术和媒体促进文化交流,使信息普及化,并赋能互联互通世界中的各个社会;同时让濒危语言获得全球关注和影响力,从而加以保护。”
小型语言模型有哪些局限?
不过,SLM也有局限,微软指出,其中包括:
处理复杂语言的能力有限:SLM可能难以理解细微的语言差别和语境中的微妙之处。
复杂任务的准确性较低:面对多方面推理或复杂的数据模式时,SLM的精确度可能不及大型模型。
性能受限:SLM虽然效率高,但可能无法胜任对性能要求极高的任务。
适用范围较窄:SLM通常基于规模较小、专业性较强的数据集进行训练,因此与大型模型相比,灵活性和通用知识有所受限。
尽管存在这些局限,SLM在各个领域的应用日益增多,尤其适用于边缘计算和实时处理场景。
SLM的兴起标志着企业人工智能战略出现重大范式转变。企业正从实验性方法转向战略性、目标明确的应用,这类应用更有针对性,也可能更具成本效益。




