人工智能和自动化究竟会创造、消除还是改变工作岗位,以及影响的程度如何,是一场没有止境的争论的核心问题。2013年,牛津大学学者卡尔·贝内迪克特·弗雷(Carl Benedikt Frey)与迈克尔·奥斯本(Michael Osborne)合作发表了一项研究,题为“《就业的未来:工作受计算机化影响的可能性有多大?》(The Future of Employment: How Susceptible Are Jobs to Computerization?)”。该研究估计,到2030年中期,美国47%的工作岗位面临高风险。
去年,世界经济论坛(WEF)发布了《2018年就业未来》(The Future of Jobs 2018)报告。报告指出,预计算法和智能机器将在全球创造1.33亿个新岗位,同时到2022年将淘汰约7500万个岗位,净增约5800万个工作岗位。
无论具体数字或百分比如何,上述所有报告以及新闻和社交媒体上反复传递的核心信息是:自动化和人工智能将使低技能岗位消失,取而代之的是专业化、知识水平高的工作者。显然,我们正面临非熟练劳动力的衰落,以及软件工程师、数据科学家、数字传播专家和网络专家的兴起。
但事实真的如此吗?自动化和人工智能确实具备替代重复性、可预测的认知和体力任务的确切能力(和优势)。然而,人工智能和机器学习还有一个鲜少被讨论、大多数公众甚至并不知晓的隐蔽面:数据的新装配线。
构建人工智能的沉默大军
“数据是新石油”如今已成为人们熟知的格言。这确实不假,数据正日益成为宝贵的新商品,对人工智能而言尤其如此。大多数机器学习算法都需要基于通常规模庞大的数据集进行训练。之所以如此,是因为当今大多数机器学习技术都属于所谓的“监督学习”范畴:计算机最终能够做出“推断”或“决策”,但前提是它已经被展示了足够多带有相应“答案”的示例。我们可以通过向神经网络输入成千上万张汽车图像来教它识别汽车,同时每次都向算法说明:“嘿,这是一辆汽车!”我们提供的汽车图片越多,它识别汽车的能力就越强。
现在,这些训练数据需要由某人进行标注,也就是说需要人工完成。我最近专门撰写了一篇文章,主题是计算机视觉、激光雷达与图像标注。文章解释了该概念、流程以及不同的标注技术。简而言之,就是有人指明图像中确实有一辆汽车,有时还需说明它的位置、正在做什么、车灯是开是关,等等。
人类参与其中,并审核每一张(或几乎每一张)图像、每一行文本以及输入神经网络的每一条数据。为了让你对规模有个概念,仅以自动驾驶汽车为例,据英特尔称,车辆每驾驶八小时将产生40TB的数据。Waymo是众多自动驾驶汽车公司之一,该公司近期称,其车辆在美国公共道路上已行驶了1600万公里。。你可以算一算,这是一个庞大的数据量。
所有这些都意味着数以千计、数以万计的人工工时。而且,标注任务不仅限于自动驾驶汽车或自主机器人。机器学习无处不在,标注工作也是如此,医疗领域同样如此。模式识别软件已用于放射学、病理学、心脏病学、肿瘤学,甚至精神病学。包括影像文件、CT、MR、心电图等在内的海量数据集,同样需要人工参与,以标定肿瘤细胞、围绕异常值绘制多边形,并突出显示病理信号。此外,还有更多应用,包括跨多个行业和应用场景的其他影像、文本或语音识别示例。
装配线2.0
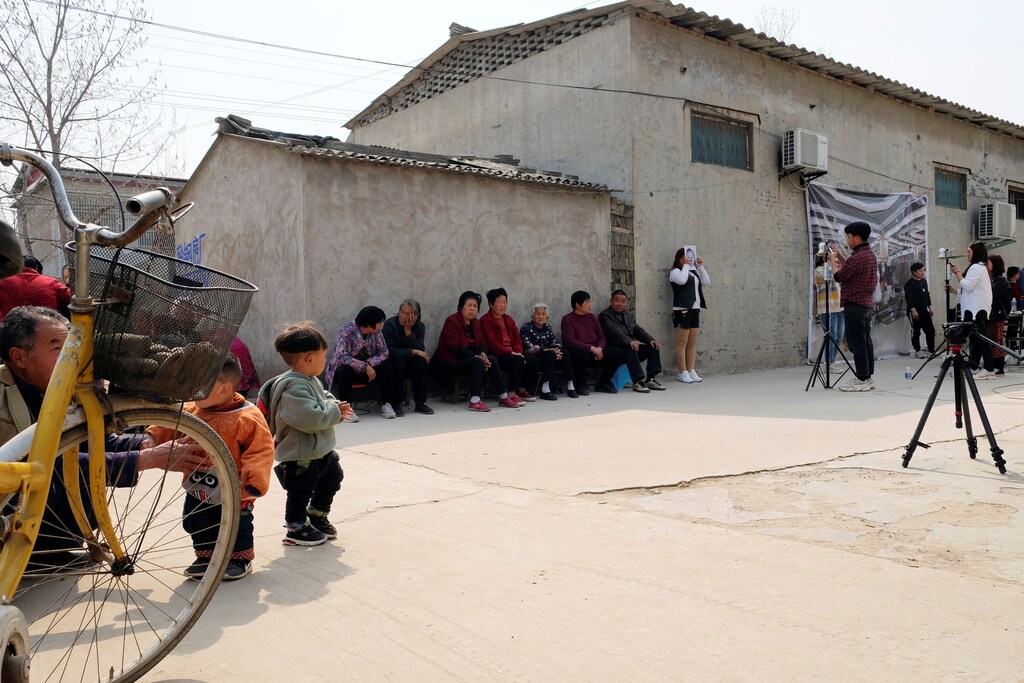
但这项工作在何时、以何种方式、在何处进行?有许多公司开发供人工完成标注流程所用的软件工具。其中一些公司设有内部员工,另一些公司则将实际的人工标注工作外包出去。无论哪种情况,这些标注团队几乎总是位于劳动力成本较低的国家或地区:印度、中国或非洲的多个地区。我们所说的是规模非常庞大的团队,人数以千计。一些公司的标注人员超过5万人,并从全球超过100万名标注员的人才库中调配人手,实行日夜轮班。
基本上,工厂和制造设施正变得越来越智能,充满了代替人类工人完成手工任务的机器人,而数据标注工厂则是人工智能时代的新装配线2.0。如果没有驱动这场革命的机器学习算法,这些新工作本不会存在。可以将数据标注视为装配线的认知版本,在这种模式下,工人不必承受高强度的体力劳动,而是从事认知类工作。诚然,这仍然是一项相当重复的任务,但它是坐着完成的,远离潜在的危险机械。
数据标注员并非易事,需要接受培训,并且需要极其细致的注意力。你需要在图像中的物体周围绘制非常精确的多边形,或者使用鼠标和键盘精准定位地标。而且你必须以极高的准确度完成这些工作:标注数据的质量对机器学习算法的成功至关重要。此外,在自动驾驶汽车等许多行业中,糟糕的训练数据可能会决定生死。标注数据耗时费力,但它是教会我们的机器如何行动、做出决策和预测结果的必要工作。
鉴于任务的规模和特点,数据标注为低技能工人、生活在发展中国家的人群,或在求职方面面临更大困难的群体,提供了绝佳的机会。
Deepen AI是一家从事数据标注业务的组织,例如,它已开始与lifelong.ai合作。lifelong.ai是一家非营利组织,帮助难民获得工作机会并学习新技能,以改善其社会经济状况。Lifelong在约旦培训叙利亚难民成为数据标注员,并为他们连接人工智能市场中的远程工作机会,同时还免费提供英语、网页开发和移动开发课程。
此外,Deepen承诺向员工支付高于最低工资标准的薪酬,并建立了清晰的职业发展阶梯,帮助员工从标注员晋升为团队负责人、软件质量保证人员、项目经理和人力资源专员。得益于这一努力,Deepen在印度的许多员工有机会结婚、组建家庭、成长,并丰富其所在社区的生活。
由此可见,人工智能不仅为拥有硕士和博士学位的人创造机会。这项蓬勃发展的技术实际上正在以难以预测的方式,为低技能人群催生新的工作类别。
数据标注的阴暗面
企业有责任增强社区能力,并确保员工不会困于低技能工作,而是能够在知识和技能上不断成长。然而,在这些低技能就业机会之中,也存在阴暗面。一些标注公司试图以超竞争性的定价抢占市场并获取更高利润,却将标注员的薪资压得极低。部分报酬可低至每小时1美元,甚至更低,远低于最低工资标准。从事此类业务的机构,基本上是在数字时代助长一种新型的奴役。
对标注数据的需求极为旺盛,因此短期内,采取这种做法的公司可能获得可观的经济回报。然而从长远来看,这种行为模式将导致员工流失率居高不下、产出质量低下,并对社区产生负面影响。这些公司不仅通过剥削工人、以不道德的方式开展业务而破坏社会规范,这种不公平的行为也对整个行业造成损害。人工智能是一项备受争议的技术,围绕它存在诸多社会、伦理和道德方面的担忧。向数据标注员支付荒谬薪酬的肮脏做法,无疑会给整个行业蒙上阴影,损害人们对技术的信任,并最终阻碍或延缓社会获得技术可能带来的诸多益处。
总之,自动化和人工智能的到来,既在淘汰数以百万计的工作岗位,也在创造数以百万计的新岗位。并非所有由人工智能创造的工作都必然面向高技能、高知识水平的工作者;低技能人群同样拥有许多新的机会。这些新岗位的增长速度,可能无法与其他低技能岗位消失的速度相匹配,但人工智能仍处于起步阶段。很可能在未来几年,数据的可用性以及获取标注数据集的需求将呈指数级增长,这意味着全球对数据标注员的需求很可能急剧上升。
做出可靠的预测非常困难。我们或许能做的最好的事情,就是效仿我们的算法:审视当前的事实,并据此做出一些推断。仅就自动驾驶汽车而言,我们目前知道,要实现安全、完全自动驾驶,我们还需要再行驶数百万乃至数十亿英里……这足以让大量数据标注员在相当长的一段时间内保持忙碌。