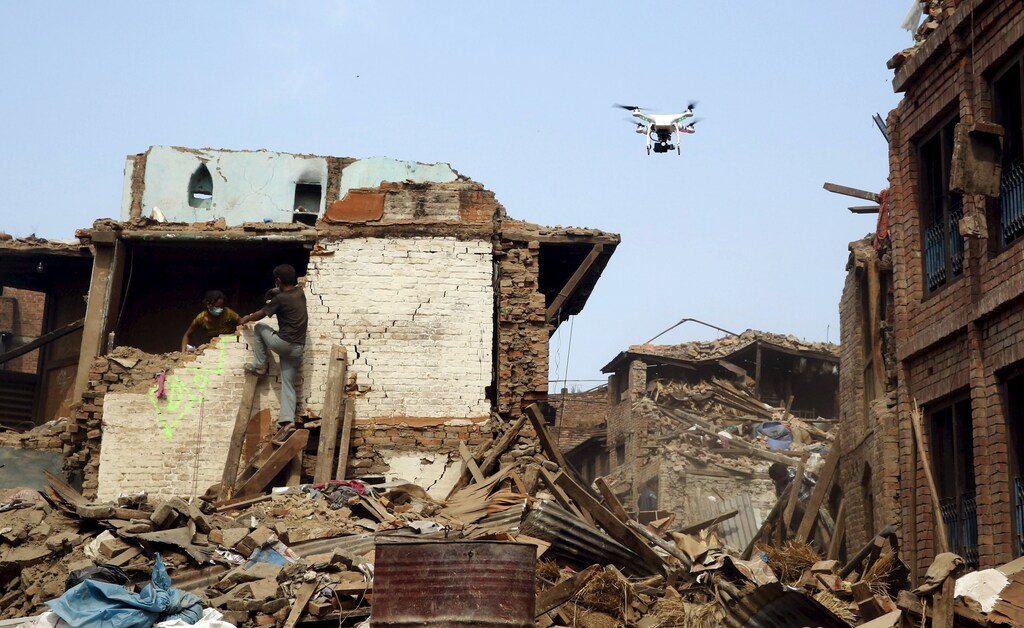
灾难发生时——无论是洪水、地震等自然灾害,还是大规模枪击或爆炸等人为事件——派遣救援人员进入现场可能极其危险,而现场又确实有人急需救助。
无人机颇为实用,已在灾后救援中发挥作用,例如在阿拉巴马州致命龙卷风之后,但大多数无人机都需要由专人通过遥控器操控。这限制了救援人员查看整个受灾区域的速度,并可能延误实际援助抵达受害者的时间。
自主无人机本可更快地覆盖更大范围,但只有当其能够自行协助救援人员识别需要帮助的人员时,效果才会更好。在代顿大学视觉实验室,我们正致力于开发能够帮助发现人员或动物的系统,尤其是那些可能被坠落碎片困住的人或动物。我们的技术模仿人类救援人员的行为:短暂扫视广阔区域,并迅速选择特定区域进行聚焦,以便更仔细地检查。
在混乱场景中寻找目标
灾区往往堆满倒伏的树木、坍塌的建筑、破损的道路以及其他杂乱物体,这些都可能使得发现需要救援的受困人员变得非常困难。
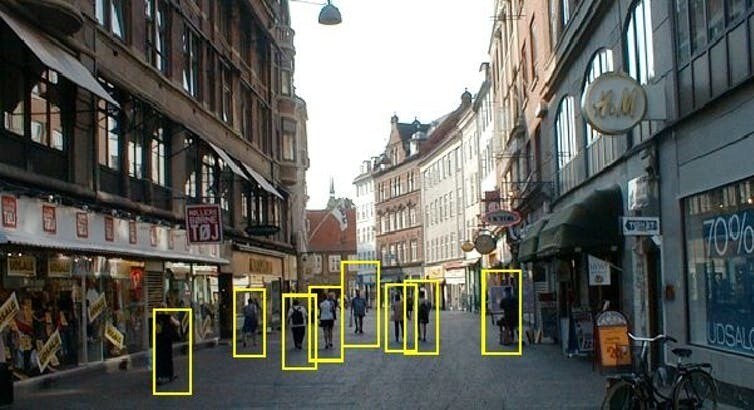
我的研究团队开发了一种人工神经网络系统,可在搭载于无人机上的计算机中运行。该系统能够模拟人类视觉的一些出色运作方式。它分析无人机摄像头拍摄的图像,并将重要发现传达给人工监督人员。
首先,我们的系统会对图像进行处理,以提高其清晰度。正如人类眯起眼睛以调整焦距一样,我们的技术会对场景中较暗区域进行详细估算,并通过计算方式提亮图像。当图像过于朦胧或有雾时,系统会识别出图像过亮,并降低图像的白度,从而更清晰地呈现实际场景。
在雨天环境中,人脑会运用一种精妙的策略来看清事物。通过注意到场景中不变的部分——以及随雨滴落下而变化的部分——人们即使在雨中也能相当清楚地看见事物。我们的技术采用同样的策略,持续分析一系列图像中的每个位置的内容,以获得清晰的信息,了解该位置物体的情况。
我们还开发了一项技术,可使无人机搭载摄像头拍摄的图像更大、更亮、更清晰。通过放大图像尺寸,算法和人类都能更清晰地看到关键特征。
确认目标对象
我们的系统能够识别处于各种姿态的人员,例如俯卧或蜷缩成胎儿姿势的人员,即使从不同视角观察或在光照条件多变的情况下也能做到。
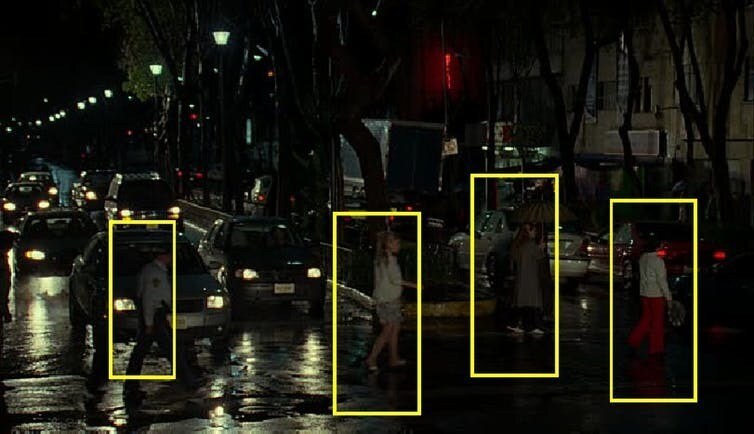
人脑只需看到物体的一个视角,就能想象出该物体从其他角度看会是什么样子。当警方发布通告请公众协助寻找某人时,通常会附上一张静态照片——因为人们的大脑会想象出该人可能呈现的三维形象,即使看到的角度与照片不完全相同,也能在街上认出对方。我们借助这一策略,通过计算人物的三维模型来实现——既可以是通用的人体形状,也可以是针对特定人员的更详细投影。这些模型用于在人物出现在场景中时进行相似性匹配。
我们还开发了一种无需看到完整物体即可检测其局部的方法。我们的系统可经过训练,用于检测并定位从废墟下伸出的一条腿、远处挥动的一只手,或堆叠木块上方冒出的一个头部。它还能将人或动物与树木、灌木或车辆区分开来。
整合各个环节
在对地面进行初步扫描时,我们的系统模仿空中侦察员的做法:先检查地面,找出可能的目标或值得进一步检查的区域,然后再进行更细致的观察。例如,一名正在地面上寻找卡车的飞行员,通常会较少关注湖泊、池塘、农田和操场——因为卡车在这些区域出现的可能性较小。我们的自主技术采用相同策略,将搜索范围集中到场景中最重要的区域。
随后,我们的系统会对每个选定区域进行分析,以获取其中物体的形状、结构和纹理信息。当系统检测到与人类或人体局部相符的一组特征时,便会将该位置标记为受害者所在位置。
无人机还会收集自身位置的GPS数据,并感知其与所拍摄其他物体之间的距离。这些信息使系统能够精确计算出每位需要协助者的位置,并向救援人员发出警报。
整个过程——包括拍摄图像、对其进行处理以最大程度提高可见度,以及分析图像以识别可能被困或隐藏的人员——在无人机所搭载的普通笔记本电脑(连同其高分辨率摄像头)上仅需约五分之一秒。
美国军方对该技术很感兴趣。我们曾与美国陆军医学研究与物资司令部合作,用于在战场上寻找需要救援的伤员。我们还将这项工作进行了调整,以服务于那些需要查找管道路径入侵情况的公用事业公司,以发现可能损坏管道的施工设备或车辆。公用事业公司还关注管道路径附近新建建筑的检测。所有这些群体——以及更多其他群体——都对能够像人类一样看见、尤其是在人类无法到达的地方看见的技术感兴趣。




