尽管科技行业当前陷入低迷并出现裁员,生成式人工智能公司仍持续吸引投资者的巨大兴趣。
生成式人工智能让人们对新一轮创造浪潮充满期待,但这些模型对社会的影响也引发了担忧。
只有建立健全的制衡机制,生成式人工智能技术和产品才能实现更加审慎、更有益的拓展。
随着Stable Diffusion和ChatGPT等新模型相继发布,生成式人工智能已成为技术专家、投资者、政策制定者乃至整个社会的“热门话题”。
顾名思义,生成式人工智能可以生成文本、图像、音乐、语音、代码或视频。生成式人工智能并非新概念,其背后的机器学习技术在过去十年中不断演进。深度学习和生成对抗网络(GAN)等方法通常已被采用,而最新的方法则是Transformer(变换器)。
生成式预训练变换器(GPT)是一类大型语言模型(LLM),利用深度学习生成类人文本。它们之所以被称为“生成式”,是因为能够根据接收到的输入生成新文本;称为“预训练”,是因为在针对特定任务进行微调之前,它们已在大规模文本数据语料库上完成训练;称为“变换器”,是因为它们采用基于Transformer(变换器)的神经网络架构来处理输入文本并生成输出文本。
尽管当前市场低迷且科技行业出现裁员,生成式人工智能公司仍持续吸引投资者的关注。Stability AI和Jasper等公司为例,分别近期筹集了1.01亿美元和1.25亿美元,而红杉资本等投资者认为生成式人工智能领域可以创造数万亿美元的经济价值。超过150家初创企业已经涌现,并已在该领域开展业务。
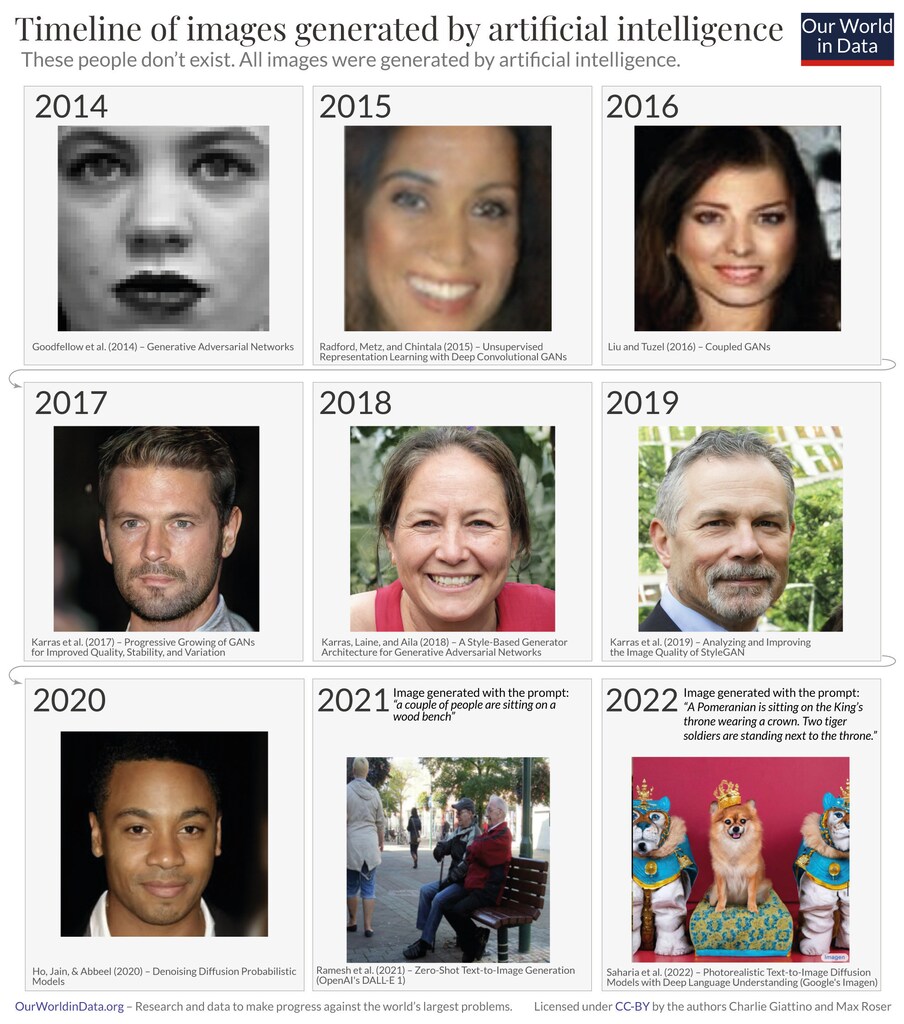
生成式人工智能系统的涌现能力
生成式人工智能的应用范围已超越语言翻译、文本摘要和文本生成等典型的自然语言处理任务。OpenAI最新发布的ChatGPT引发了病毒式传播,仅用五天便吸引了一百万用户,被认为在更广泛的任务领域取得了突破。目前正在探讨的应用场景包括搜索引擎的新架构、搜索引擎;解释复杂算法;打造个性化治疗机器人,帮助从零开始构建应用程序;解释科学概念; 撰写食谱;以及撰写大学论文,等等。
Midjourney、DALL-E和Stable Diffusion等文本生成图像程序有潜力改变艺术、动画、游戏、电影和建筑等领域的呈现方式。Stability AI的创意总监Bill Cusick认为,该软件是“未来创造力的基石”。Stability AI的创意总监Bill Cusick认为,该软件是“未来创造力的基石”。
基于人机协作的新时代,乐观派认为,生成式人工智能将助力艺术家和设计师的创作过程,因为现有任务将由生成式人工智能系统加以增强,从而加快构思速度,并从本质上加速创作阶段。人机协作为基础,乐观派认为,生成式人工智能将助力艺术家和设计师的创作过程,因为现有任务将由生成式人工智能系统加以增强,从而加快构思速度,并从本质上加速创作阶段。
除创意领域外,生成式人工智能模型在计算机工程等复杂科学领域也具有变革性能力。例如,微软旗下的GitHub Copilot基于OpenAI的Codex模型,可以提供代码建议,并协助开发者自动补全编程任务。据报道,该系统可自动补全开发者多达40%的代码,显著提升了工作流程效率。
存在哪些风险?
生成式人工智能让人们对新一轮创造浪潮充满期待,但这些模型对社会的影响也引发了担忧。数字艺术家Greg Rutkowski担心,互联网上将充斥着与他本人作品难以区分的艺术作品,只需告诉系统以他独特的风格复制一幅作品即可。艺术教授Carson Grubaugh也对此表示担忧,并预测大量创意从业者,包括娱乐、电子游戏、广告和出版等行业的商业艺术家,可能会因生成式人工智能模型而失去工作。
除了对任务和工作产生深远影响外,生成式人工智能模型及相关外部性也引起了人工智能治理界的警觉。大型语言模型的问题之一,在于其能够生成虚假和误导性内容。Meta的Galactica—— 该模型基于4800万篇科学文章训练,声称可以总结学术论文、解决数学问题并编写科学代码——上线不到三天即被下架,原因是科学界发现它在误解科学事实和知识后生成了错误结果。
在自动化网络水军机器人的背景下,这一问题更加令人担忧,这些机器人的能力已发展到足以使图灵测试——即检验机器能否展现出与人类相似或难以区分的智能行为的测试——变得过时。此类能力可能被滥用,在各平台和生态系统中生成假新闻和虚假信息。
大型模型仍在基于书籍、文章和网站等海量数据集进行训练,这些数据可能存在偏见,且难以完全过滤。尽管通过使用基于人类反馈的强化学习(RLHF),ChatGPT在减少有害和不真实输出方面取得了显著成效,但OpenAI承认,其模型仍可能生成有毒和带有偏见的输出内容。
生成式人工智能如何治理?
在私营部门,目前正在形成两种生成式人工智能模型治理方式。一派以OpenAI等公司为代表,它们通过有限发布策略、对模型使用进行监控,以及通过API对其DALL-E2等商业产品实施受控访问,来进行自我治理。另一派则以Stability AI等新兴机构为代表,它们认为这些模型应当公开发布,以实现访问的民主化,并对社会和经济产生最大可能的影响。Stability AI已开源其模型的权重——因此,开发者基本上可以将其接入各类应用,以创造大量新颖的视觉效果,而几乎不对扩散过程施加任何或仅有极少的控制。
在公共部门,针对快速发展的生成式人工智能领域,几乎没有或完全没有监管措施。美国众议员Anna Eshoo在致白宫的一封近期信函中表达了“严重关切”,针对Stability AI近期不安全地发布Stable Diffusion模型一事,包括其可生成暴力和色情图像。
其他问题还涉及知识产权和版权。生成式人工智能模型背后的数据集一般是在未征得在世艺术家或仍受版权保护作品同意的情况下,从互联网上抓取的。“如果这些模型在未获得授权的情况下,基于在世艺术家的风格进行训练,那么便存在版权影响”,白宫人工智能政策工作组成员Daniela Braga如是说。
版权问题在自动补全代码领域同样突出。微软的GitHub Copilot正卷入一起集体诉讼,指控该系统是在“前所未有规模的软件盗版”基础上构建的。Copilot是基于从网络上抓取的公共代码库进行训练的,而这些代码库在许多情况下是以要求在复用代码时注明创作者的许可协议发布的。
未来之路何在?
尽管生成式人工智能在众多领域和任务中都是颠覆性力量,但仍亟需更审慎地治理这些模型的扩散及其对社会和经济的影响。未来几年,新兴的讨论对生成式人工智能社区至关重要,即一方面是集中化、受控且具有严格伦理边界的应用,另一方面是更快速的创新与去中心化的分发之间的权衡。讨论,将对生成式人工智能社区在未来几年产生重要影响。
这项任务不仅属于私营企业,公民社会和政策制定者同样需要积极参与。其中包括劳动力市场的颠覆、抓取数据的合法性、授权许可、版权问题,以及可能产生的偏见或其他有害内容、错误信息等。只有建立健全的制衡机制,才能实现生成式人工智能技术和产品更加审慎、更有益的拓展。




