机器学习分析了350万本书,发现用来形容女性的形容词往往描述外表,而指向行为的词语则多用于男性。
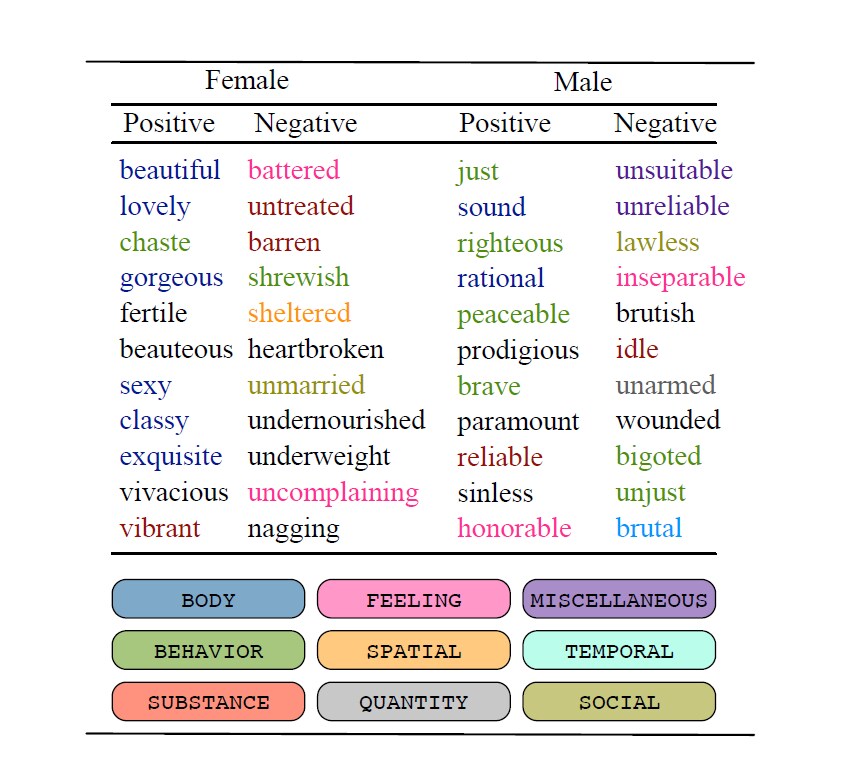
“漂亮”和“性感”是最常用来形容女性的两个形容词。用来描述男性的常见词汇包括正直、理性和勇敢。
研究人员翻阅了大量书籍,旨在探究文学作品中描述男性和女性的词语类型是否存在差异。研究人员使用一种新的计算机模型,分析了一个包含350万本书的数据集,这些书均为1900年至2008年间以英文出版。这些书籍既包括小说,也包括非虚构文学。
“我们可以清楚地看到,用于女性的词语比用于男性的词语更多地指向她们的外表。因此,我们已经能够证实一种广泛存在的观念,只不过现在是在统计层面上得到了证实。”哥本哈根大学计算机科学系的计算机科学家兼助理教授伊莎贝尔·奥古斯坦(Isabelle Augenstein)如是说。
研究人员提取了与性别特定名词(例如“女儿”和“空乘”)相关联的形容词和动词。例如,在“性感空乘”或“女孩们闲聊”等组合中。随后,他们分析了这些词语的情感倾向是积极、消极还是中性,并将这些词语归入“行为”“身体”“情感”和“思想”等语义类别。
该数据集基于谷歌N元语料库(Google Ngram Corpus)。
110亿个词
他们的分析表明,与身体和外貌相关的消极动词用于描述女性形象的频率是用于男性形象的五倍。分析还表明,与身体和外貌相关的积极和中性形容词在描述女性形象时出现的频率约为两倍,而描述男性时,最常用的形容词则指向其行为和个人品质。
过去,语言学家通常研究的是性别化语言和偏见的普遍程度,但所用的数据集较小。如今,计算机科学家可以部署机器学习算法来分析海量数据——在本研究中即为110亿个词。
奥古斯坦指出,尽管许多书籍已在几十年前出版,但它们仍然发挥着积极作用。用于构建能够理解人类语言的机器和应用程序的算法,所输入的数据是网上可获取的文本材料。正是这项技术使智能手机能够识别我们的声音,并让谷歌能够提供关键词建议。
为什么形容词如此重要?
“算法的工作是识别模式,每当观察到某种模式时,就会被视为某种‘真相’。如果这些模式涉及带有偏见的语言,结果也将带有偏见。可以说,这些系统会吸收我们人类使用的语言,因而也会吸收我们的性别刻板印象和偏见。”奥古斯坦说。她举例说明了这可能在何处很重要:“例如,如果我们描述男性和女性的语言在员工推荐中存在差异,那么当企业使用IT系统筛选求职申请时,这将影响谁会获得录用。”
随着人工智能和语言技术在社会中日益普及,了解性别化语言十分重要。
奥古斯坦继续说道:“在开发机器学习模型时,我们可以尝试通过使用偏见较少的文本,或强制模型忽略或抵消偏见来加以考虑。这三件事都是可以做到的。”
研究人员指出,该分析存在局限性:它没有考虑各段落的作者是谁,也没有考虑根据书籍出版于数据集时间线中较早还是较晚时期而导致的偏见程度差异。此外,它也未区分体裁,例如浪漫小说与非虚构作品之间的区别。研究人员目前正在跟进其中若干问题。
该研究的其他合著者来自马里兰大学、谷歌研究院、约翰霍普金斯大学、马萨诸塞大学阿默斯特分校和微软研究院。
他们在论文中进行了发表,该论文于2019年计算语言学协会年会上发表。




