学会学习
1959年,机器学习(ML)领域的先驱亚瑟·塞缪尔将其定义为“赋予计算机无需明确编程即可进行学习能力的研究领域”。
机器学习可以理解为利用经验提升性能或作出准确预测的计算方法。在这里,经验指我们能够获取的过往信息或数据,这些信息或数据已经过标注和分类。与任何计算任务一样,数据的质量和数量对于预测的准确性至关重要。
从这个角度看,机器学习似乎与统计建模十分相似。在统计建模中,我们收集数据,确认数据干净——换言之,补全、修正或删除数据中不完整、错误或无关的部分——然后使用这套干净的数据集检验假设,并作出预测和预报。统计建模背后的理念,是尝试用相对具有普适性的术语来呈现复杂问题,也就是说,用能够解释所研究的大多数事件的术语来描述。实际上,我们根据提交的数据对算法进行编程,使其执行特定功能。换句话说,算法是静态的。向其中输入数据时,需要由程序员告知它该做什么。因此,当程序员启动这种方法时,它确实很有用。
但在机器学习中,过程恰恰相反。机器学习不是预先选定模型再向其中输入数据,而是由数据决定应选择哪种分析技术,以最好地完成当前任务。换言之,计算机利用已有数据来选择并训练算法。因此,算法不再是静态的。它会分析所接触的数据,判断最佳行动方案,然后采取行动。从本质上说,它从数据中“学习”,并由此从数据中提取知识。
这种学习方式以重复为基础。请记住,算法不过是一组指令,计算机利用它将输入转换为特定输出。因此,在机器学习中,学习过程就是算法一遍又一遍地重复执行操作,并作出细微调整,直到满足一组特定条件。检验学习算法的关键标准是:当输入它此前未曾接受过训练的新数据时,它能否作出预测。
机器学习的演进
显然,数据在这一方法过程中发挥着主要作用。更重要的是,数据的结构决定了学习过程将如何进行。由此可以看到机器学习的三个层次:
监督式机器学习
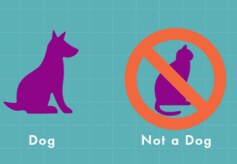
在这种情况下,计算机使用标注完善的数据进行训练。这意味着数据已经标上了正确的标签或正确的结果。例如,如果我们要教计算机区分猫和狗的图片,就会按以下方式标注数据:
这一标注过程应由程序员完成。算法学会区分之后,就可以对输入的新信息进行分类,并判断新图像中的是狗还是猫。
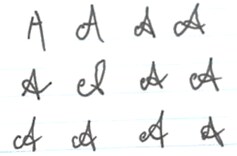
基于这种简单方法,监督式机器学习可以用于执行复杂得多的操作。一种用途是识别数字和字母。不同的人书写数字“1”或字母“A”的方式各不相同。
手写数字1的字形。图片由作者提供。手写字母A的字形。图片由作者提供。
向计算机输入大量标注为数字“1”或字母“A”的示例,就能训练算法识别这些字符的各种写法。这样,计算机便开始学习不同写法,并越来越擅长识别这些模式。
如今,计算机识别此类手写模式的能力已经超过人类。数据集越大,算法训练得越好。训练完成后,算法会接收新数据,并利用过往经验预测结果。
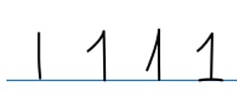
无监督式机器学习
在这种情况下,算法使用没有任何标签的数据集进行训练。算法不会获知数据代表什么。此时,学习过程取决于识别数据中反复出现的模式。以猫和狗为例,算法会根据狗的固有特征,开始对接收到的图像进行区分。
在无监督学习中,算法必须使用基于推断统计学的估算方法,从原始、未经标注的数据集中发现模式、关系和相关性。识别出模式后,算法会运用统计方法找出数据集中的边界。具有相似模式的数据会被归为一组,形成数据子集。随着分类过程持续进行,算法开始理解正在分析的数据集,从而能够预测未来数据的类别。
这种数据聚类可以实现决策自动化,为无监督学习增添一层复杂性。更重要的是,它让我们能够以新的方式利用数据。知识不足之处,可以用数据来弥补。
强化式机器学习
强化学习与无监督式机器学习相似,训练数据同样没有标签。不过,当系统被询问有关数据的问题时,结果会得到评分,因此仍然存在一定程度的监督。算法接收没有标签的数据,但会获得一个带有正面或负面结果的示例。这个正面或负面评分为算法提供反馈机制,使其能够判断所给出的解决方案是否解决了问题。从本质上说,它是人类通过试错学习的计算机版本。
强化式机器学习常用于制定策略。由于决策会带来后果,其输出的行动具有指导性,而不像无监督学习那样仅作描述。这种学习方法已被用于训练计算机玩游戏。这正是谷歌于2014年收购的DeepMind公司的思路;该公司训练了他们训练算法学习如何玩雅达利游戏。
随后,该公司开发了AlphaGo,它以4比1的成绩击败了人类最优秀的职业围棋棋手,赢得了围棋比赛。围棋是世界上最复杂的游戏之一。
对企业的影响
如今,机器学习已应用于许多领域。谷歌的自动驾驶汽车就是利用机器学习开发的;如今,机器还能比人类更快地读唇。近年来,机器学习已渗透到金融业几乎所有领域。例如,机器学习正用于算法交易、分析时间序列数据、投资组合管理、欺诈检测、客户服务、新闻分析、投资策略制定等。
不过,机器学习真正的威力要通过神经网络才能充分发挥。在下一篇文章中,我们将对此作进一步探讨。




