Alexa、Siri和Google等热门语音助手借助语音识别软件回答用户的问题,但儿童的语言高度复杂且难以预测。
儿童会过度强调字词的发音,拉长某些音节,在边想边说时对每个词都进行断句,或直接跳过某些词语。
儿童每天花在屏幕上的时间高达5小时以上,因此让他们被理解至关重要。
疫情前,新增互联网用户中有超过40%是儿童。目前的估计显示,儿童的屏幕使用时间已大幅增长,60%或以上,12岁及以下儿童每天在屏幕上花费5小时以上(伴随而来的是各种益处与风险)。
尽管人们很容易惊叹于数字原住民的技术能力,但教育工作者(和家长)深知,年幼的“远程学习者”往往难以驾驭键盘、菜单和界面,而这些正是兑现教育技术承诺所必需的。
在此背景下,支持语音的数字助手带来了希望,有望实现与技术更顺畅的互动。然而,尽管孩子们喜欢让Alexa或Siri打拍子、讲笑话或模仿动物叫声,但家长和教师都知道,一旦孩子提出的请求偏离可预测的范围,这些系统就难以理解他们这些最年幼的用户。
问题在于,为Alexa、Siri和Google等热门语音助手提供动力的语音识别软件从设计之初就不是为儿童使用而打造的,而儿童的声音、语言和行为远比成年人复杂。
这不仅仅是因为孩子的声音更尖细,他们的声道更窄更短,声带更小,喉部也尚未完全发育。这导致其语音模式与大一些的儿童或成年人截然不同。
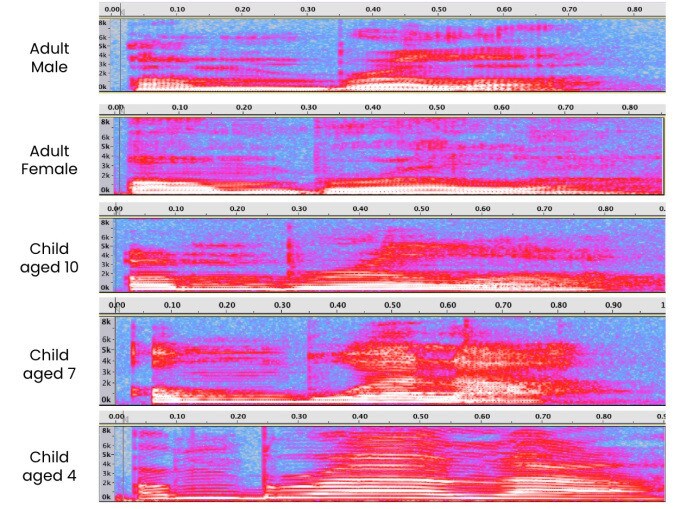
从下图可以清楚看出,仅仅改变用于训练语音识别的成人声音音调,无法还原理解儿童语音所需的复杂信息。儿童的语言结构和模式差异很大。他们在句法、发音和语法方面的飞跃式发展,需要被语音识别系统的自然语言处理组件纳入考虑。此外,处于各种不同发育阶段的儿童之间的个体差异进一步加剧了这种复杂性,而在成人语音中则无需考虑这一点。
儿童的语音行为不仅比成年人更加多变,而且极其不规则。儿童会过度强调字词的发音,拉长某些音节,在边想边说时对每个词都进行断句,或直接跳过某些词语。他们的语音模式并不遵循为成年用户设计的系统所熟悉的常见节奏。作为成年人,我们已经学会如何与这些设备最好地互动,如何获得最佳回应。我们坐直身体,在脑中组织好请求,根据习得的经验进行调整,然后大声说出请求,深吸一口气……“Alexa……”而孩子们则会不假思索地脱口而出,仿佛Siri或Alexa是真人一样,而且往往得到错误或模板化的回应。
在教育环境中,这些挑战进一步加剧,因为语音识别不仅要应对环境噪音和课堂的不可预测性,还要应对儿童在一学年中语音的变化,以及典型小学中多种口音和方言并存的情况。孩子年龄越小,他们与成年人在生理、语言和行为方面的差异也越大。这意味着,最能从语音识别中受益的低龄学习者,恰恰是开发者最难为其开发产品的群体。
要应对并理解儿童语言中高度多样的特点,语音识别系统就必须经过专门设计,有意识地从儿童的说话方式中学习。儿童的语音不能简单地被视为语音识别需要适应的另一种口音或方言;它在根本上和实际上都有所不同,并且会随着儿童身体发育和语言能力的提升而变化。
与大多数消费场景不同,准确性对儿童有着深远的影响。若系统在孩子回答正确时告诉他们错误(假阴性),会打击他们的信心;若在孩子回答错误时告诉他们正确(假阳性),则可能造成社会情感(及心理测量)方面的伤害。在娱乐场景中,例如应用程序、游戏、机器人和智能玩具里,这些假阴性或假阳性会带来令人沮丧的体验。而在学校里,错误、误解或模板化回应可能产生更为深远的教育影响和公平性影响。
有充分记录的偏见例如,语音识别中的偏见可能对儿童产生有害影响。若某产品对特定人口统计或社会经济背景的儿童准确率较低(即产生假阳性和假阴性),这是不可接受的。越来越多的研究表明,语音可以成为儿童极具价值的交互界面,但我们不能允许或无视其可能放大学校中本已普遍存在的偏见和不平等。
语音识别有潜力成为儿童在家中和课堂上的强大工具。它能够在儿童读写和语言学习的各个阶段提供关键支持,帮助孩子更好地理解周围的世界,并让周围的世界理解他们。它还可能开启一个“无形”观察式测量的新时代,即使在远程环境中也能可靠运行。然而,目前大多数语音识别工具并不适合这一目标。Siri、Alexa及其他语音助手中所采用的技术有其既定任务,即理解说话清晰且可预测的成年人,而且在大多数情况下,它们都能很好地完成这一任务。若要让语音识别适用于儿童,就必须针对他们独特的声音、语言和行为进行建模,并对其作出响应。




