人工智能领域的一项重大突破:语音识别软件如今已能像人类一样准确地理解语言,尽管要把握语言背后的语境仍然很困难。
微软的研究人员开发出一款软件,其词错误率为5.9%,与人工转录员的水平大致相当。
“这一研究里程碑并不意味着计算机能完美识别每个词。事实上,人类也做不到。它的意思是,错误率——也就是计算机把一个词听错的比率,例如把have听成is,或者把听成——与人听同一段对话时的预期水平相同。”微软在一篇博客文章中表示。
这一成果多年来不断逼近,而就在几周前,同一团队报告称他们已将错误率降至令人振奋的6.3%。
二十年前,已发表研究中表现最佳的系统,其词错误率仍高于43%。
神经网络
IBMIBM和微软都指出,深度神经网络的出现是语音识别取得进展的关键原因之一。这类网络受到大脑生物过程的启发。
几十年来,计算机科学家一直试图训练计算机系统完成图像识别、语音理解等任务,但直到最近,这些系统仍饱受准确性不足的困扰。
微软的新项目依托这些深度神经网络,以及专用图形处理器,使软件能够以此前无法实现的速度学习。
蓬勃发展的市场
这一里程碑具有深远影响。
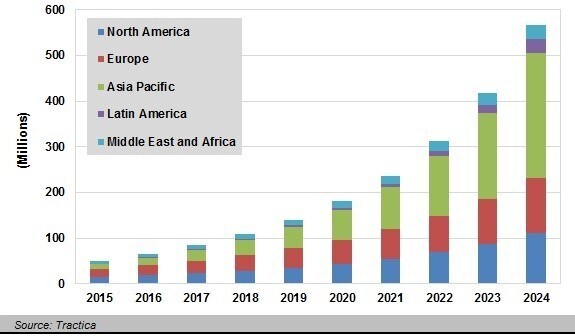
近期研究机构Tractica预测,到2024年,全球语音识别软件许可数量将超过5.5亿。消费和医疗保健用途是增长最强劲的领域,但这项技术对多个行业都有影响。
2015—2024年各地区语音与语音识别许可年度数量
仍有工作要做
研究人员表示,仍需进一步改进该系统在现实环境中的表现,例如背景噪声很大的场所。多人交谈时识别各个说话者的研究,也是长期研究工作的一部分。
任何曾经对着Siri、Cortana或Google Assistant大声喊话的人都能作证:要让计算机不仅理解说了哪些词,还能理解其含义和语境,仍有大量工作要做。计算机要达到人类的准确程度来回答问题或执行指令,还需要一段时间。
黄学东领导微软人工智能与研究团队。他表示:“计算机要理解所说或所展示内容的真正含义,还需要很长时间,路途也还很遥远。”




