一组研究人员通过使用通常用于训犬的技巧,教机器人掌握新技能。
他们采用正向强化,仅用几天就教会机器人学习新事物,而这通常需要一个月。
团队设想,这些发现有助于训练家用机器人和自动驾驶汽车。
研究人员使用一种常用于教狗坐下和停留的训练技巧,展示了如何让机器人自学几项新本领,包括堆叠积木。
采用这种方法,名为 Spot 的机器人几天内就学会了通常需要一个月才能掌握的内容。
团队采用正向强化——任何曾用零食改变狗狗行为的人都熟悉这种方法——大幅提升了机器人的技能,而且速度足够快,使训练机器人胜任现实世界的工作变得更加可行。
“我养过狗,所以知道奖励有效;这启发了我设计学习算法。”
“这里的问题是,怎样才能让机器人学会一项技能?”主要作者安德鲁·亨特说。他是约翰·霍普金斯大学计算交互与机器人实验室的一名博士生。“我养过狗,所以知道奖励有效;这启发了我设计学习算法。”
这项研究发表于《IEEE机器人与自动化快报》。
教机器人学习
与天生拥有高度直觉大脑的人类和动物不同,计算机是一张白纸,必须从头学习一切。但真正的学习往往通过反复试错实现,机器人研究人员仍在探索如何让机器人高效地从错误中学习。
团队设计了一套奖励机制,让机器人像狗狗通过零食获得奖励一样得到激励。狗狗表现出色可能会得到一块饼干,而机器人则获得数字积分。
亨特回忆说,他曾教自己的梗犬混种幼犬莉娅听从“别碰”的指令,这样散步时她就能对松鼠视而不见。他用了两种零食:普通训练零食,以及更好的东西,比如奶酪。
莉娅兴奋地在零食周围嗅来嗅去时,什么也得不到。但当她平静下来并把目光移开时,就能得到好东西。“那时我把奶酪给她,说:‘别碰!莉娅真棒!’”
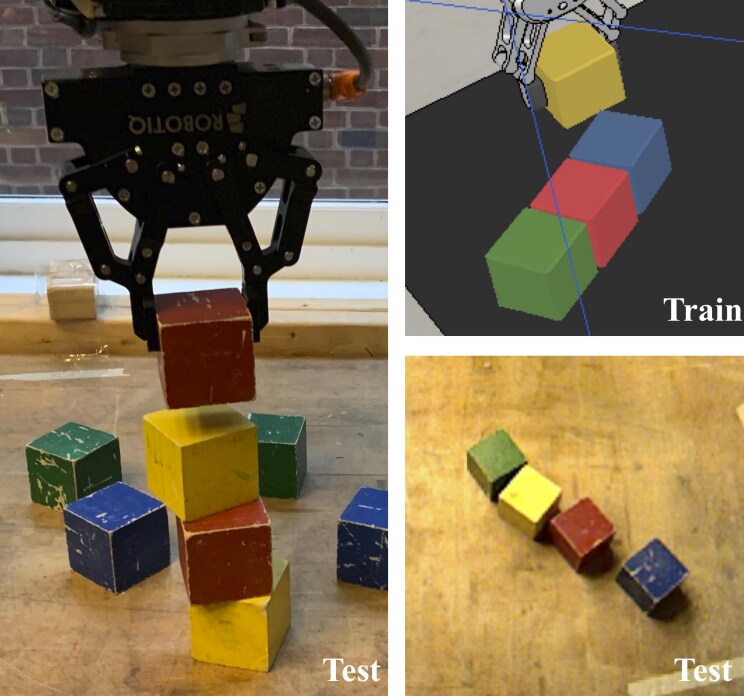
同样,要堆叠积木,机器人 Spot 必须学会专注于有助于完成任务的行动。在探索积木时,它很快就学会了:正确的堆叠行为能获得高分,错误行为则一分也没有。伸手却没抓住积木?不得分。把积木堆弄倒?当然也不得分。把最后一块积木放到四块积木堆的顶端时,Spot 得分最高。
高分!
这种训练方法不仅有效,还只用几天就教会了机器人过去需要几周才能学会的内容。团队先训练一个模拟机器人(这很像电子游戏),再用 Spot 进行测试,从而缩短了练习时间。
“机器人想要更高的分数,”亨特说。“它很快就能学会获得最佳奖励的正确行为。事实上,以前机器人需要练习一个月才能达到 100% 的准确率。我们两天就做到了。”
正向强化不仅帮助机器人自学堆叠积木,通过积分系统,机器人也同样迅速学会了其他几项任务——甚至能玩模拟导航游戏。在各种情境中从错误中学习的能力,对于设计能够适应新环境的机器人至关重要。
“一开始,机器人完全不知道自己在做什么,但每练习一次都会进步。它从不放弃,不断尝试堆叠积木,并且每次都能完成任务,”亨特说。
团队设想,这些发现有助于训练家用机器人洗衣服和洗碗——这些任务可能在公开市场上受到欢迎,也能帮助老年人独立生活。这些发现还可能有助于设计更先进的自动驾驶汽车。
“我们的目标是最终开发出能够在现实世界中完成复杂任务的机器人,例如产品组装、照护老年人和手术,”共同作者、计算机科学教授格雷戈里·D·哈格说。
“目前我们还不知道如何为这类任务编程——现实世界太复杂了。但这项研究表明,让机器人学会安全、高效地完成此类现实世界任务是有希望的,”哈格说。
来源:约翰·霍普金斯大学




