语音控制设备(如亚马逊的Alexa、谷歌的Home或苹果的Homepod)正日益普及,但人们应当停下来思考机器学习机器学习的进展可能催生能够理解语音中不同情绪的应用。
谷歌谷歌首席执行官桑达尔·皮查伊(Sundar Pichai)近日表示,公司20%的搜索是通过语音发起的,来自移动电话。另外,2017年底对美国市场的分析显示,共售出4400万台亚马逊Alexa和谷歌Home设备。
这项技术在识别词语方面的能力日益出色,但是,作为一名声学专家,我清楚地认识到,言语交流要复杂得多。事物的表达方式与词语本身同样重要。当有人说“我没事”时,其语调可能恰恰表明他们的情绪与所说的相反。
语音控制设备,也被称为智能音箱或虚拟助手,使用起来可能令人沮丧,因为它们只关注词语,大多忽略了言语的表达方式。科技巨头希望,像亚马逊Echo这样的设备的下一个前沿将是通过声音察觉人的情绪,从而使互动更加自然。

人的声音可以透露说话者是谁、来自何方以及情绪如何。陌生人开口说话时,人们会立即注意到其口音和语调,并据此对其阶层、背景和教育程度作出推断。
如果语音控制设备能够捕捉到这类信息,语音交互界面便可得到改进。但对于可能产生的意外后果,仍值得保持警惕。该技术依赖机器学习——这是人工智能的一个分支,它将算法与机器从大量数据中习得的统计规律结合起来,因此其行为并不完全可以预测。
未来是聪明还是愚笨?
研究表明,用于训练机器学习应用的语音样本很可能导致偏见。此类技术问题在谷歌翻译等流行工具中已有明显体现。
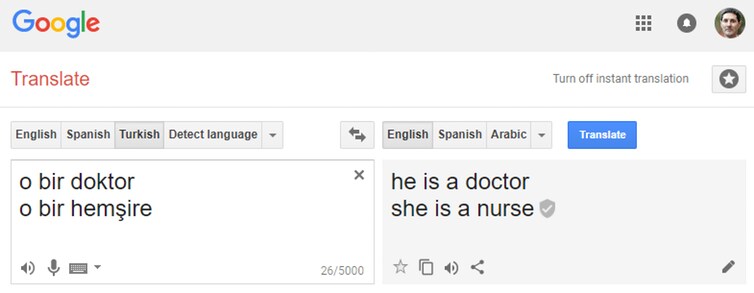
例如,当把土耳其语短语“o bir doktor”和“o bir hemşire”翻译成英文时,谷歌的服务返回的结果是“he is a doctor”和“she is a nurse”。然而,在土耳其语中,“o”是一个性别中性的第三人称代词。认为医生是男性、护士是女性的假定,反映了文化偏见,以及医疗行业中性别分布的失衡。
谷歌翻译吸收了算法训练数据中存在的人类文化偏见,最终结果是一个带有性别歧视的翻译系统。
要解决此类问题并不容易,因为机器学习会反映人类的刻板印象。人们在聆听声音时,会借助经验法则来简化判断如何回应对方的过程。
研究表明,当人们听到一名女性在许多句子末尾使用上扬语调时,即所谓的“上扬语调”(uptalk),人们通常会推断她很年轻。如果一名男性说话声音低沉,人们则会假定他高大强壮。这类对言语的简化假设可能导致带有偏见的判断。
带有伯明翰口音的刑事嫌疑人,一项研究发现,与口音较为中性的人相比,更有可能被判定为有罪。研究还揭示,非母语口音会被认为更不诚实。
仅凭言语判断一个人是愤怒、高兴还是悲伤,对于任何使用语音控制设备的人来说都可能非常有用。但人们发出的声音线索因人而异,也因语言和文化而异。人并不总能正确识别情绪,任何曾经历过恋爱关系的人都会证实这一点,那么又为何要指望机器能做得更好呢?
关于人们的听觉“gaydar”(“同性恋雷达”)的研究——这是一个口语化的说法,指一些自称能凭直觉判断他人是否为男同性恋、女同性恋或双性恋的人——为模糊甚至不可靠信号提供了一个很好的例子。例如,听者会对男同性恋者的说话方式作出假设,如认为他们声音较高,但这些假设往往是错误的。为迎合观众预期,演员刻意扮演不符合实际的刻板形象,这在电视荧幕上已逐渐成为一种文化常态,研究表明。声音信号固有的、因人而异的自然模糊性,很可能导致错误,除非科技公司
从自身的失误中吸取教训。被用于解读人类声音的应用可能会习得根深蒂固的偏见,因为该技术高度依赖于对所输入数据的学习。开发语音控制设备和服务的科技公司或许已经与声学专家进行了交流。但在将
机器学习应用于解码人类声音之前,它们需要认真倾听这些警示,以更好地理解需要避免的陷阱。应用于解码人类声音之前,它们需要认真倾听这些警示,以更好地理解需要避免的陷阱。




