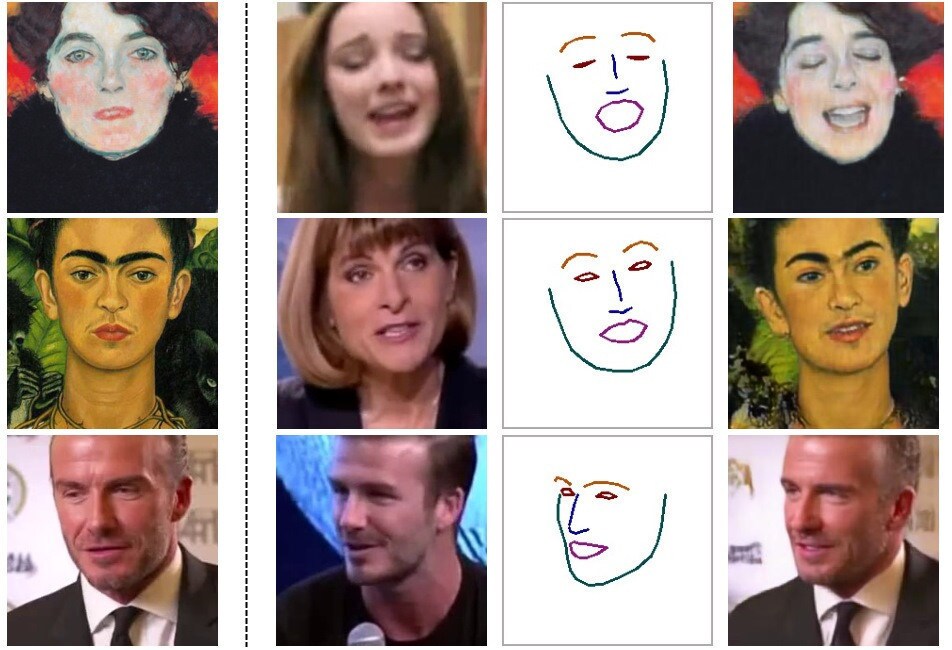
机器学习研究人员开发出一种系统,仅凭一张人脸图像就能重现栩栩如生的动作,这使得不仅照片,连绘画也有可能动起来。它并不完美,但在奏效时,正如当今许多人工智能成果一样,令人毛骨悚然又着迷。
该模型记录于三星人工智能中心发表的一篇论文中,您可以在此处阅读该论文,发布于Arxiv。这是一种新方法,将源人脸上的面部关键点(任何说话的头像均可)应用于目标人脸的面部数据,使目标人脸做出源人脸的动作。
这种方法本身并不新颖,它属于当前人工智能领域面临的整体合成影像问题之一(我们最近在柏克莱举办的机器人与人工智能活动上就此进行过一次有趣的讨论)。我们已经能够让一段视频中的人脸,根据所说的话或注视的方向,呈现出另一段视频中人脸的表情。但大多数此类模型需要大量数据,例如一两分钟的视频用于分析。
然而,三星位于莫斯科的研究人员发表的这篇新论文表明,仅使用一张人脸图像,就能生成该人脸转头、说话并做出日常表情的视频,其逼真程度令人信服,尽管远非完美。
其方法是,借助海量数据预先处理面部关键点识别过程,使模型能够高效地找到目标人脸中与源人脸对应的部分。数据越多,效果越好,但它仅用一张图像也能完成此任务,这被称为单样本学习,并且能够做到。正因如此,才能拍摄爱因斯坦、玛丽莲·梦露,甚至蒙娜丽莎的照片,并让她们像真人一样动起来、开口说话。
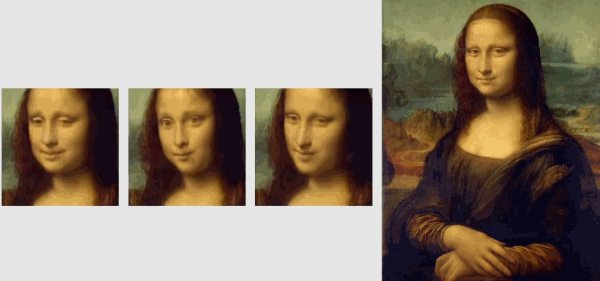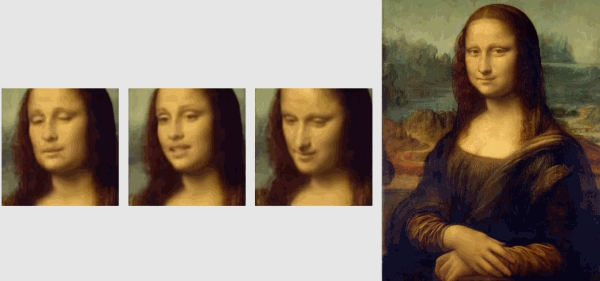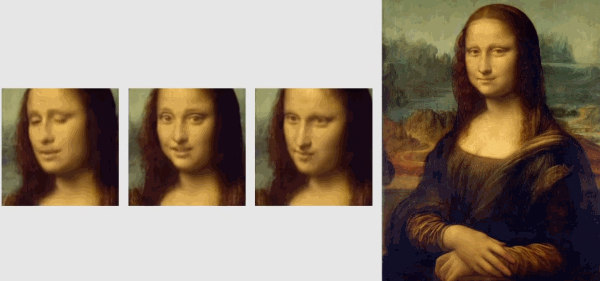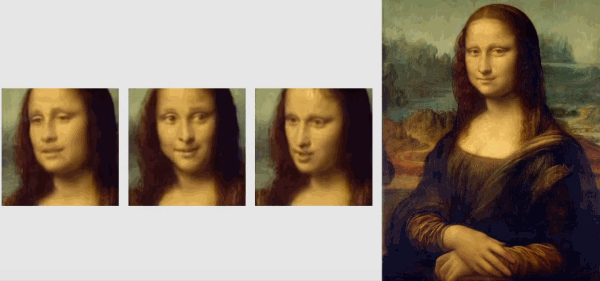
该方法还采用了所谓的生成对抗网络,这实际上是让两个模型相互对抗:一个试图骗过另一个,使其相信所生成的内容是“真实的”。通过这种方式,结果能够达到创作者设定的一定真实度水平——“判别器”模型必须以例如90%的把握判定这是人脸,过程才能继续。
在研究人员提供的其他示例中,虚假头像的质量和明显程度差异很大。其中一些试图复制从有线新闻中截取图像的人物,同时还重现了画面底部的新闻字幕滚动条,并将其填充为乱码。如果知道该看什么,常见的涂抹痕迹和怪异的伪影随处可见。
尽管如此,它的效果如此出色仍然令人惊叹。不过需要注意的是,这仅适用于面部和上半身——您无法让蒙娜丽莎打响指或跳舞。至少目前还不行。




