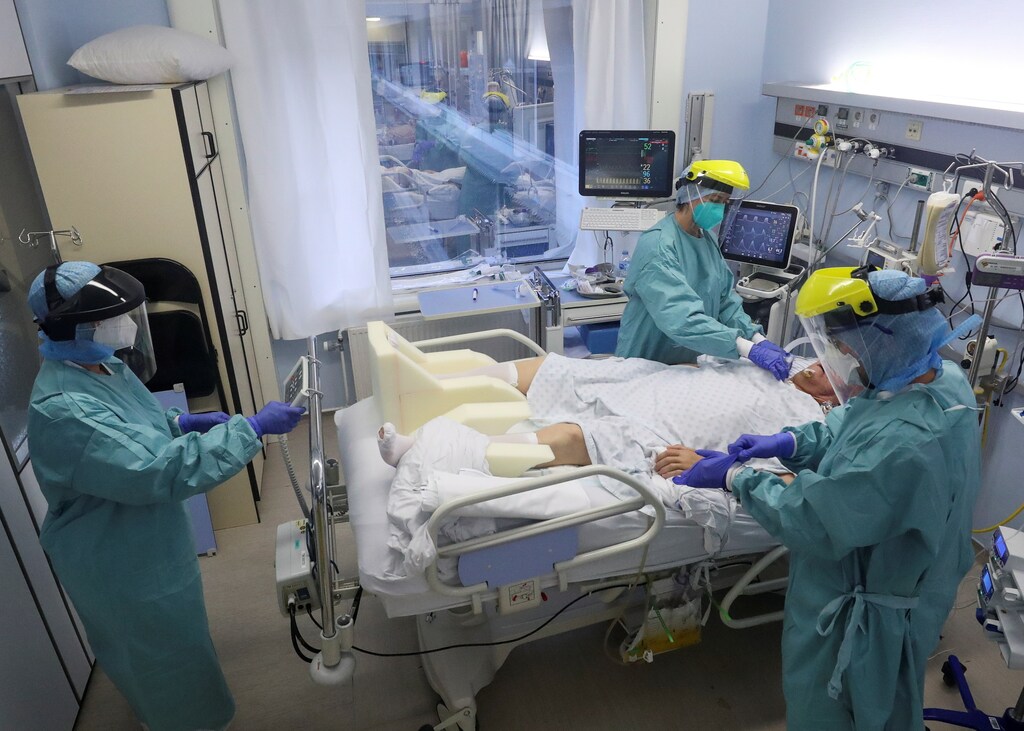
自然语言处理(NLP)算法可以在数以千计的患者记录中发现规律,有助于找到有效的治疗方法。
它们还可以帮助预测哪些患者更有可能因新冠肺炎病情严重,并预测疫情即将出现的激增。
病历是健康数据的丰富来源。将其中的信息结合起来,有助于研究人员更好地了解疾病,并更有效地加以治疗。其中包括新冠肺炎。但要挖掘这一丰富资源,研究人员首先需要阅读这些记录。
我们或许已经告别了手写病历的时代,但现代电子健康档案中记录的信息,同样可能难以获取和解读。有个老笑话说,医生的字迹难以辨认,而事实证明,他们的打字水平也好不到哪里去。
健康档案所包含的信息量之大令人震惊。每天,一家普通英国国家医疗服务体系(NHS)医院的医护人员所产生的文字量之大,即使只是让人浏览一遍,也要耗费大量时间,更不用说阅读了。利用计算机分析所有这些数据显然是一个解决方案,但绝非易事。对人类而言再合乎情理的内容,对计算机来说却可能极难理解。
我们的团队正在运用一种人工智能形式来弥合这一差距。通过教计算机理解人类医生的记录,我们希望它们能够通过发现数以千计患者记录中的规律,揭示抗击新冠肺炎的见解。
健康档案为何难以处理
健康档案的很大一部分由自由文本构成,其形式类似电子邮件,采用叙述性文字录入。其中包括患者的症状、病史,以及有关既往疾病和正在服用药物的记录。还可能混杂着与家庭成员和生活方式相关的信息。而且,由于这些文字是由忙碌的医生录入的,其中还会有缩写、不准确之处和拼写错误。
这类信息被称为非结构化数据。例如,一份患者记录可能写道:
Smith女士,65岁,患有心房颤动,三月份曾发生CVA。既往有#NOF和OA病史。有乳腺癌家族史。已开具阿哌沙班处方。无出血史。
这段高度精简的文字包含了大量关于Smith女士的数据。另一位阅读这些记录的人能够知道哪些信息重要,并在数秒内将其提取出来,但计算机完成这项任务则极为困难。
教机器阅读
为解决这一问题,我们正在使用一种称为自然语言处理(NLP)的技术。基于机器学习和人工智能技术,NLP算法可将自由文本中使用的语言转换为标准化、结构化的一组医学术语,从而便于计算机进行分析。
这些算法极为复杂。它们需要理解语境、较长的词语串和医学概念,区分当前事件与历史事件,识别家庭关系等。我们通过向它们输入现有的文字资料来教授这些能力,使其能够学习语言的结构和含义——在本项目中,所用的是互联网上公开可用的英文文本——随后再使用真实的病历进行进一步优化和测试。
利用NLP算法分析和提取健康档案中的数据,对改变医疗保健具有巨大潜力。患者记录中以叙述性文字记载的大量内容通常再也不会被查看。其中可能包含重要信息,例如癌症或中风等严重疾病的早期预警信号。能够自动分析并标记重要问题,有助于提供更好的护理,并避免诊断和治疗的延误。
寻找抗击新冠肺炎的方法
通过利用这些工具汇集健康档案,我们现正运用这些技术来发现与疫情相关的规律。例如,我们近期利用自有工具探究了通常用于治疗高血压、糖尿病及其他疾病的药物——即血管紧张素转换酶抑制剂(ACEIs)和血管紧张素受体拮抗剂(ARBs)——是否会增加严重感染新冠肺炎的几率。
引发新冠肺炎的病毒通过与细胞表面一种名为ACE2的分子结合来感染细胞。据认为,ACEIs和ARBs均可增加ACE2的数量,使细胞表面的ACE2增多,因此人们担心这些药物可能会使人们面临更高的病毒感染风险。
然而,回答这一问题所需的信息——有多少病情严重的新冠肺炎患者正在服用这些药物——既可以以结构化处方的形式记录,也可以以自由文本的形式记录在其病历中。要让机器回答这一问题,这些自由文本需要采用可供计算机检索的格式。
借助我们的NLP工具,我们得以分析1,200名新冠肺炎患者的匿名记录,比较临床结局与患者是否服用这些药物之间的关系。令人欣慰的是,我们发现,被开具ACEIs或ARBs处方的人并不更可能病情严重,与未服用这些药物的人相比并无差异。
我们目前正在扩展这些工具的使用范围,以进一步了解哪些人最容易受到新冠肺炎的威胁。例如,我们已利用它们调查相关联系,探究种族、既往健康状况与新冠肺炎之间的关系。研究发现了几项引人注目的结果:黑人或混血人群因该疾病入院的可能性更高;此外,亚裔患者在住院期间,被送入重症监护室或死于新冠肺炎的风险更大。
我们还利用这些工具评估了早期预警评分,以预测哪些入院患者最有可能病情严重,并提出可用于改进这些评分的其他措施建议。我们还正在利用该技术预测即将出现的激增新冠肺炎病例,依据是医生记录的患者症状。




