大语言模型之间的性能差距正在迅速缩小。
中国的人工智能初创企业在金融资本和算力方面无法与科技巨头竞争,因此必须专注于其拥有独特数据优势的领域的人工智能应用。
在全球人工智能竞赛中,中国的人工智能市场趋势对于新兴市场(尤其是融资和计算资源匮乏的市场)具有参考价值。
TikTok可能是全球用户花费时间最长的社交网络,但很少有TikTok网红意识到,TikTok的母公司字节跳动还拥有另一款全球前十的移动应用——视频剪辑应用CapCut。截至2024年底,其总下载量 CapCut在所有移动应用中排名第四,仅次于Facebook、Instagram和TikTok。
很少有人意识到CapCut现已由人工智能(AI)驱动。其对应的AI生成内容软件Dearmina可与OpenAI的Sora相媲美,后者可将文本输入转化为视频内容。
5月下旬,字节跳动发布了自家的大语言模型(LLM),与OpenAI的模型类似,震惊了人工智能市场。其主打模型"豆包"的定价显著低于中国科技巨头的同类产品。该公司称,豆包大模型能够以人民币1元(0.14美元)的价格处理200万个汉字,相当于125万个token。
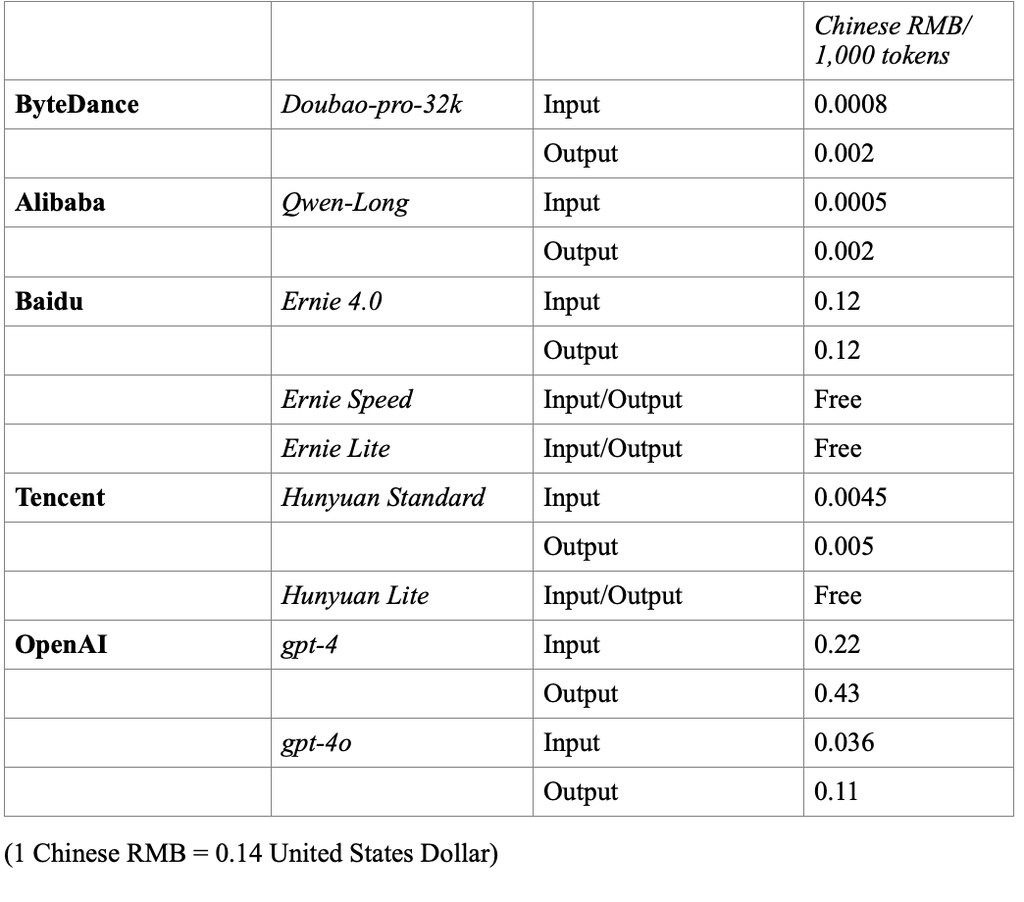
其他中国科技重量级企业,如 阿里巴巴 和 腾讯,随即大幅降价。一些企业还免费开放其功能较弱的大语言模型。
OpenAI同期发布的最先进多模态模型GPT-4o,每百万输入token收费5美元。在人工智能领域,token是算法处理数据的基本单位。对于中文大语言模型而言,一个token通常相当于1至1.8个汉字。
中国的这场价格战以及美国的类似趋势(开源免费模型,如Meta的Llama和xAI的Grok,正在促使OpenAI降低模型价格)表明,大语言模型之间的性能差距正在迅速缩小。
当大语言模型基础模型本身已商品化时,各类企业可将其视为操作系统或平台,围绕这些模型开发尚未真正出现的人工智能应用,蕴藏着巨大机遇。
因此,在中国的人工智能市场中,大多数参与者专注于应用层面——即大语言模型的"商业化"。就针对不同行业领域具体任务的人工智能应用而言,模型规模未必是决定性能的唯一因素。
架构、训练数据和微调技术等其他方面可能发挥重要作用。价格战降低了初创企业的大语言模型成本,提升了其利润率。
当然,创新方向的这种转变也是许多中国人工智能初创企业的必然选择。由于美国的制裁,英伟达GPU等最先进的芯片难以获取。
此外,中国经济放缓导致初创企业陷入"风险投资寒冬"。它们无法在金融资本和算力方面与科技巨头竞争。因此,它们必须专注于拥有独特优势的领域的人工智能应用,例如:
现有数据资源
数据使算法和模型产生差异,而专有数据提供了可持续的人工智能护城河。对于人工智能而言,高质量的搜索、分类、预测、个性化、异常检测以及其他诸多用例的实现,都依赖于数据。因此,CapCut隶属于TikTok和字节跳动无与伦比的短视频平台,是一款优质的视频剪辑软件,也就不足为奇了。
CapCut的 人工智能工具Dreamina(中文名即梦)近期进行了更名,并借此完成了AI绘画和AI视频剪辑功能的全面上线。与OpenAI的Sora一样,它允许用户将文本描述转化为图像。
此外,即梦计划推出"故事创作"功能,允许用户借助人工智能技术创作个性化故事,从而丰富其产品线(该即将推出的功能仍在测试中)。这一功能显然带有TikTok短视频的基因。
为特定业务模型投资稳健的客户数据基础设施并进行数据策展
中国初创企业FancyTech赢得了 LVMH 2024创新奖,其平台利用生成式人工智能根据3D产品模型制作视频,就是一个很好的例子。
FancyTech的创始人在电商平台天猫(阿里巴巴集团旗下)工作时,深知全球品牌的痛点:它们可能需要为库存中的100件产品制作100条视频,而采用传统制作方式几乎不可能完成。
如今,生成式人工智能为这一难题提供了强有力的工具,品牌——如Hublot的天猫旗舰店——现已包含多条由FancyTech制作的视频。
最重要的是,广告视频的制作与分发全过程实现了全自动化,无需人工质量控制。秘诀何在?FancyTech在数据标注团队上投入巨大,以策展高质量数据集来训练其人工智能应用,进而为品牌生成高质量视频内容。
企业可通过三种方式改进其人工智能应用:检索增强、基于提示与回复的微调以及自监督预训练。理想的部署方案会整合这三者,但这意味着沉重的数据标注负担。
世界经济论坛如何为人工智能建立防护机制?
卓越人工智能中心汇聚各行业领袖,共同理解人工智能的快速发展及其对经济体和社会的影响。它支持就人工智能应用相关的机遇、风险和权衡进行知情对话。
通过可信赖的交流空间和协作性倡议,该中心助力合作伙伴建立共同认知,并携手推进负责任的人工智能创新与应用。
小即是新的大
当科技巨头竞相构建规模日益庞大的语言模型时,一个令人意外的趋势正在兴起:更小的模型——即小语言模型(SLM)。SLM更适用于特定应用。大语言模型拥有数千亿参数,而SLM的参数量约为数百亿。如果说2023年是大语言模型之年,那么2024年很可能就是小语言模型之年。
SLM具备一定的适应性和响应能力,这对实时应用至关重要。对于特定任务,例如特定领域的问答,这些紧凑、高效且专门构建的SLM可在速度、成本和准确性三个关键指标上提供更优性能。如果说最大的大语言模型旨在成为顶尖大学的博士,那么较小的SLM则乐于成为职业学校的毕业生。
中国人工智能企业之所以专注于SLM,是因为"万物互联"(IoT)和边缘计算时代已悄然到来(联网的物体数量多于联网的人)。其较小的体量使请求处理延迟更低,使其成为物联网边缘人工智能计算的理想选择,而这一场景对速度要求极高。各类人工智能陪伴机器人已在中国电商网站上销售,其中大多数价格低于100美元。
综上所述,中国的人工智能市场正在形成一种 混合人工智能生态系统 ,使企业和公司即便在融资和计算资源往往有限的情况下,也能把握生成式人工智能带来的机遇。
它们使用大语言模型,充分利用开源模型,但更侧重于特定应用和SLM,这些SLM通常部署在本地(例如智慧农业)或虚拟私有云上,因为它们体量较小,并且可能使用高度专有的数据进行训练。
其结果是,中国涌现出一批人工智能应用,声称在各行业实现了PMF(产品/市场契合)。随着中国聚焦数字基础设施建设并强调 数据作为经济的基础要素,其数据资源正得到进一步规范、整理和整合。其产业政策近期已从上一个十年的"互联网+"转向"数据×"。中国整体数据基础有望使2024至2025年成为"部署与规模化"之年。
中国的人工智能市场趋势对于新兴市场(尤其是在全球人工智能竞赛中融资和计算资源匮乏的市场)具有参考价值。
我们如今才刚刚达到企业级架构可真正用于利用人工智能的阶段,因此新兴市场现在正是利用其现有数据资源、投资数字基础设施以创造性地应用人工智能的良机。
新兴市场可借助其专有数据和专业领域知识——这是大语言模型所不具备的宝贵资源——在当前人工智能热潮中实现数字化转型的跨越式发展。




