你有哪些需要了解却尚不知道的事?你又如何知道自己不知道?试想把这个问题输入搜索引擎,并期待得到连贯的答案。我们寻求的答案是探索与学习的核心动力,源于需要与乐趣、工作岗位被取代,或是在复杂且瞬息万变的世界中对领导力的不确定感。无论由人还是机器提供帮助,学习过程都要求我们详细了解自己和所处的世界。
我们可以通过网络搜索、与专家和志同道合的人交流、阅读书籍、完成教育课程、在线学习视频教程,以及吸收在线新闻频道和聚合平台上源源不断的大量内容,来弥补技能和知识上的不足。其中一部分属于结构化学习,但很大程度上,我们也需要在摸索中保持开放,随时接纳意外的发现。
如今,机器学习正开始发挥作用。它正在吸收并建模你知道和不知道的内容,以便提供更有针对性的信息,帮助个人学习。这正是谷歌、领英和亚马逊等平台公司的发展方向——构建能够以数据呈现我们及其需求的算法。平台驱动的匹配技术将为终身学习提供动力。这些技术将充分了解我们,从而给出建议,并适应不断变化的情境。这正是人类学习与机器学习的连接点。
平台匹配
这一机遇的核心是数据——大量数据,以及懂得如何将其转换为比较矩阵以进行匹配的算法。亚马逊长期以来一直采用这种方法推荐商品:“购买此商品的顾客也购买了……”。在 Tinder 上,匹配算法会将一个个人资料中的数据与其他资料进行比较,提供一系列可能的匹配对象。在 Facebook 上,匹配技术用于定向广告。实际上,你的数据正成为代表你的画像,并服务于特定目的。算法需要充分了解你和你的需求,才能按优先顺序提供选项。这种技术简单、无处不在,而且出奇地强大。然而,这些算法的用途远不止于推荐下一本要读的书,而且其潜力才刚刚开始显现。
领英经济图谱“以数字方式绘制全球经济图谱,大规模连接人才与机遇。”这让领英得以深入洞察工作的变化趋势、构成特定职位所需的技能类型,以及预示着工作变动的职场行为。它还可以识别职业发展所需弥补的技能差距。识别人们的技能差距并帮助他们弥补,恰好说明领英为何收购内容聚合应用Pulse(2013年),收购在线学习网站Lynda.com(2015年),并于领英学习(2016年9月)推出该平台。
未来几十年里有一个讽刺之处:机器学习将越来越多地取代合同法务和秘书工作等知识型岗位,但它也会发现并推荐学习机会,帮助那些人弥补新出现的知识缺口,从而找到新的工作。
从个人学习到组织学习
未来几年,推动这些创新的相同技术将普及到各类公司。数据驱动型企业和文化已经被讨论了一段时间,但实际上,关键在于转向知识驱动。部门和团队各自为政,知识被锁在每个人的头脑里;内部流程尚未优化;员工培训几乎不存在;公司董事会可能对内部动态知之甚少,首席执行官也可能尚未意识到正迅速逼近、威胁公司盈亏底线的颠覆性风险。
组织内部的不满、透明度缺失以及人才使用不当,都可以借助与选歌类似的推荐算法得到改善。“解决了这个问题的同事还咨询过……”“缺乏这项诀窍的首席执行官也缺少……”“需要这项服务的企业也需要……”。即使带着一点戏谑,你也能看出这种做法会走向何方。
尽管目前人们对机器学习和人工智能的兴趣激增,但我们对个人学习历程的理解,仍不亚于哥白尼之前人们对地球绕太阳运行的认识。由机器学习推动的知识革命即将席卷商业世界,并带来范式转变,改变公司的组织方式和协作方式。企业将运用新的、日益普及的技术驱动方法来学习、优化和发展。
矩阵中的偏差
尽管基于机器学习的推荐正在为网络平台和电子商务网站带来收入,但这些技术仍远谈不上成熟。它们的效果出人意料地好,尽管大多只是采用宽松的统计方法来比较信息矩阵,再据此提供一组选项。这是一张网格,而不是一个决策。
这些机器学习系统中最薄弱的一环,往往是程序员及其所在公司;糟糕的算法建模和走捷径的思维会带来偏差。在亚马逊买一双鞋,很容易导致同一双鞋连续数周出现在广告中。算法似乎不知道你已经买过了。个人数据污染也是个问题——例如,你替父母或朋友买书时就可能发生。算法会突然把这当成你的偏好。此外,流行度形成的过滤气泡可能让文章一直留在阅读列表顶部,因为人们不断点击列表最上方的内容,形成自我强化循环。广告资金会抬高某一内容相对于其他内容的优先级。目前我们正目睹假新闻问题,它正在影响人们在选举期间的认知。社交传播速度很容易在推荐算法中变成失真的信号,而许多人缺乏辨别事实与虚假的制衡机制。
这为相关性工程带来了机遇。我们的学习算法尚未充分发展。目前我们大多仍依据相似性原则运作——这个像那个,所以再给你一些类似的内容。算法需要对技能之间的依赖关系,以及不同知识领域之间的互补关系进行建模,才能为个人学习体验提供有意义的指导。
内容正转化为数据
2015年,TED推出了watson.ted.com,这是 TED 与 IBM Watson 合作打造的平台。TED 演讲的完整档案经过编目后输入 Watson。数千小时视频中蕴含的洞见得以释放,供机器学习分析。语音转文字服务将视频内容转换为文字,再由自然语言处理提取概念、人物、地点和事物,并按主题进行分类。
这个过程是从此前缺乏结构的转录文字中构建知识结构。内容已经成为数据。这相当于机器学习读过你读过的每一本书,也读过你没读过的书,再通过比较所有内容给出推荐。这需要大量计算。使用 Facebook 账号登录 TED,它就会对你的社交帖子历史进行类似处理。它会非常深入地了解你和你认识的人,并为你的个人学习乐趣整理一份高度定制的视频清单。这种方式更强大、更实用,也可能更准确。
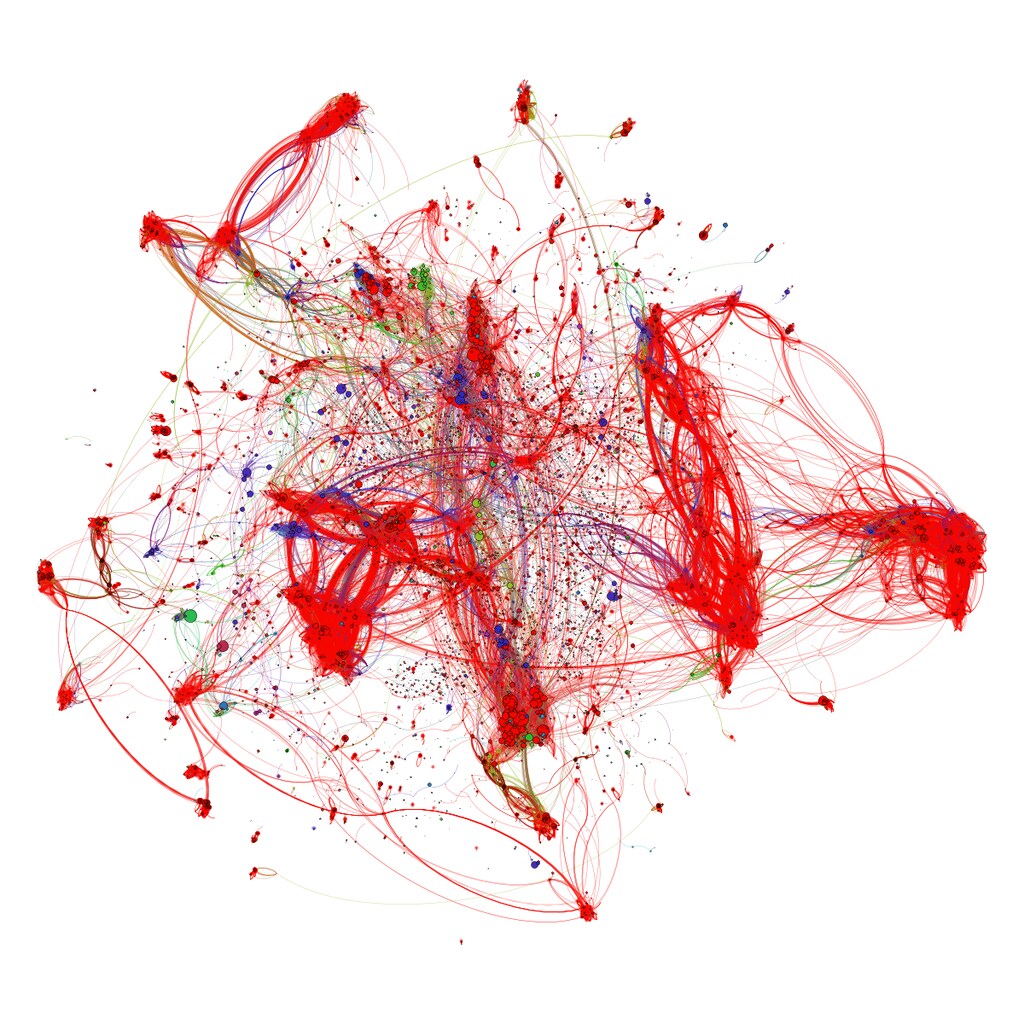
注:这张图片展示了一个斯坦福项目的可视化,取自 O’Reilly Radar 上的文章为一百万份作业评分的半自动方法。Coursera 机器学习课程约40,000份学生作业的可视化方法概述见Jon Huang 的网站。
这种做法的风险与回报显而易见。当内容渠道试图通过大量发布内容来保持竞争优势时,人们已经应接不暇。一项由《经济学人》开展的调查证实,这种现象让五分之三的全球高管感到困惑,思想领导力内容也过度拥挤,以至于价值自损。由于数量策略不再奏效,知识流动受阻。人们需要网络化知识、个性化知识和学习过滤机制。目前,这只能通过数量有限、经过精挑细选的内容渠道来实现。未来,量身定制且了解你的算法将使之成为可能。只需以数据形式分享一点自己的信息,就能获得大量个性化服务——前提是有充分的信任,确保你的数据得到妥善使用。
新的知识意识
世界经济论坛的《未来就业报告》指出,2015年至2020年间,35%的核心技能将发生变化。同样,福里斯特研究公司的报告预计,四年内机器人将取代25%的可自动化工作岗位。这种颠覆将日益显现。例如,无需结账的自助式亚马逊 Go 商店于2016年12月在西雅图开业;优步的出租车已在旧金山街头行驶,已准备好实现完全无人驾驶,但仍在等待机动车辆管理局(DMV)批准。这些不一定是外形像人的机器人,而是能够感知世界、按照可复制流程运作的机器。
周围发生如此多的变化,我们将越来越希望学习融入生活节奏,让机器学习成为连接兴趣主题与理解水平的纽带。随着我们进一步进入机器学习增强人类能力的时代,我们会希望学习数据能够跨渠道使用并便于携带,同时拥有日益先进的推荐服务,将我们与自身的学习需求相匹配。
我们仍会希望在会议上与专家见面,交流细分领域的想法。我们仍希望通过结构化课程、评估标准和认证来集中注意力。我们也仍希望在群体中分享想法,并感受到自己属于由学习者和教师组成的社群。这些趋势的早期迹象已清晰可见于edX、Coursera、可汗学院、Lynda.com及其他大规模开放在线课程(MOOC)平台,它们提供同行评审、讨论区、自动评分、互动练习和学习分析。Udacity甚至提供企业课程和纳米学位,帮助学员掌握硅谷技能,胜任未来的工作。
终身机器学习就是我们的未来。借助个人数据,我们将有机会训练自己的教师,成为混合型学习者。学习越贴合个人需求,就越以人为本。机器将通过提示并从数据中发现模式,找出你不知道什么,以及为了竞争并取得成功需要了解什么。网络化、相互连接的知识将带来新的洞见、机遇,甚至可能带来新的学习方式。
本文所表达的观点仅代表作者本人。
本文最初发表于E 180 Magazine。




