麻省理工学院大脑、心智与机器中心的研究人员发现,人类需要3种关键能力来帮助解决物理问题。
这些能力包括对类似情境的既有知识、想象自身行为效果的能力,以及在失败时迅速调整策略的方法。
该团队设计了一项新颖的任务——“虚拟工具”游戏,用以考察工具使用能力,并在人类和一个人工智能模型上进行了测试。
人类天生就是富有创造力的工具使用者。当我们需要钉钉子却没有锤子时,我们很容易意识到可以用一块又重又平的物体,比如石头,来代替。当桌子晃动时,我们很快会想到在桌腿下垫一叠纸来使其稳固。然而,这些行为对我们来说看似如此自然,却被认为是高度智能的标志——只有少数其他物种会以新颖的方式使用物体来解决问题,而且没有一种能像人类那样灵活。是什么赋予了我们以这种方式使用物体的强大能力?
在一篇新的论文中,该文发表于《美国国家科学院院刊》,描述了在麻省理工学院大脑、心智与机器中心完成的工作。研究人员凯尔西·艾伦、凯文·史密斯和约书亚·特南鲍姆研究了支撑这类即兴工具使用的认知组成部分。他们设计了一项新颖的任务“虚拟工具”游戏,用以考察工具使用能力:参与者必须从一组“工具”中选择一件物体,并将其放置在一个二维的计算机化场景中,以达成目标,例如将球放入特定的容器中。解决该游戏中的谜题需要运用多项物理原理进行推理,包括发射、阻挡或支撑物体。
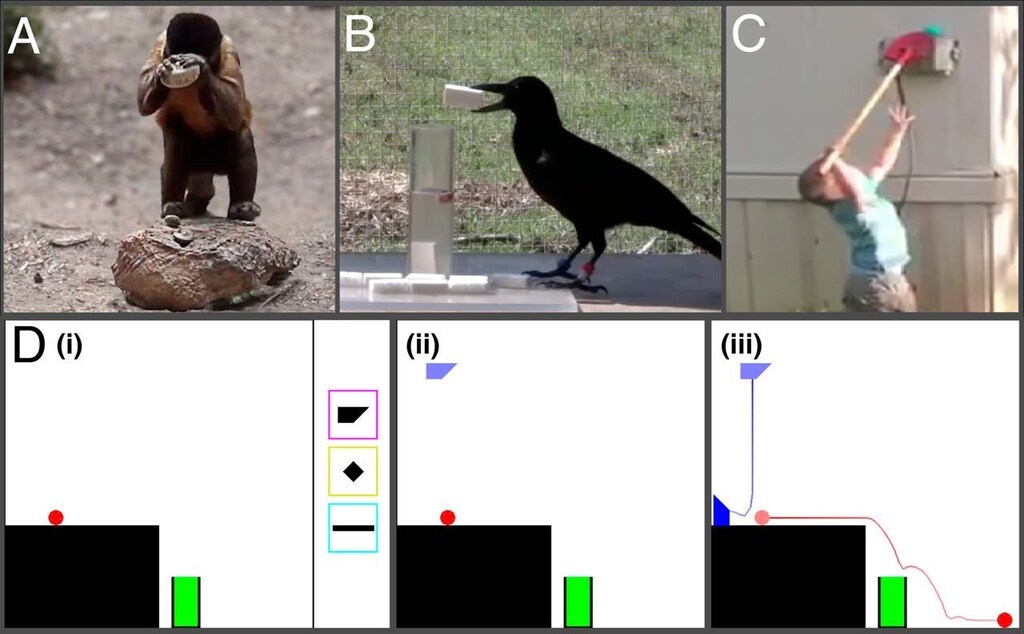
该团队提出假设:人们依靠三种能力来解决这些谜题:一种先验信念,引导人们选择那些能在场景中产生实际作用的行动;想象自身行动效果的能力;以及一种机制,用于迅速更新关于哪些行动可能提供解决方案的信念。他们构建了一个体现这些原理的模型,称为“采样、模拟、更新”(“Sample, Simulate, Update”,简称“SSUP”)模型,并让它与人类玩同一款游戏。研究发现,SSUP解决每个谜题的成功率与方式都与人类相似。另一方面,一个广受欢迎的深度学习模型虽然能很好地玩雅达利游戏,但由于不具备相同的物体与物理结构,无法将其知识推广到未经直接训练的谜题上。
这项研究提供了一个新框架,用于研究和形式化支持人类工具使用的认知过程。该团队希望扩展这一框架,不仅研究工具使用,还研究人们如何为新问题创造创新性的新工具,以及人类如何传递这些信息,从简单的物理工具发展到如今已融入日常生活的计算机或飞机等复杂物体。
凯尔西·艾伦是麻省理工学院计算认知科学实验室的一名博士生,她对“虚拟工具”游戏如何支持其他对工具使用感兴趣的认知科学家表示期待:“在这一领域还有大量值得探索的内容。我们已经开始与多个不同机构的研究人员合作开展项目,内容涵盖研究游戏具备趣味性意味着什么,到研究具身性如何影响脱离身体的物理推理。我希望认知科学界的其他人能将该游戏作为工具,以更好地理解物理模型如何与决策和规划相互作用。”
约书亚·特南鲍姆是麻省理工学院计算认知科学教授,他认为这项工作不仅是理解人类认知和文化中一个重要方面的一步,也是探索如何在机器中构建更接近人类的智能形式的一步。“人工智能研究人员一直对强化学习(RL)算法的潜力非常兴奋,即让算法像人类一样从试错经验中学习,但人类真正受益的试错学习只需少数几次尝试即可展开——而不是像当今强化学习系统那样需要数百万或数十亿次经验。”特南鲍姆表示,“‘虚拟工具’游戏使我们能够研究人类这种非常迅速且更加自然的试错学习形式,而SSUP模型能够捕捉人类所表现出的快速学习动态,这一事实表明,它或许也能为强化学习的新人工智能方法指明方向,使其能够像人类一样快速而灵活地从成功、失败和险些成功的经历中学习。”




