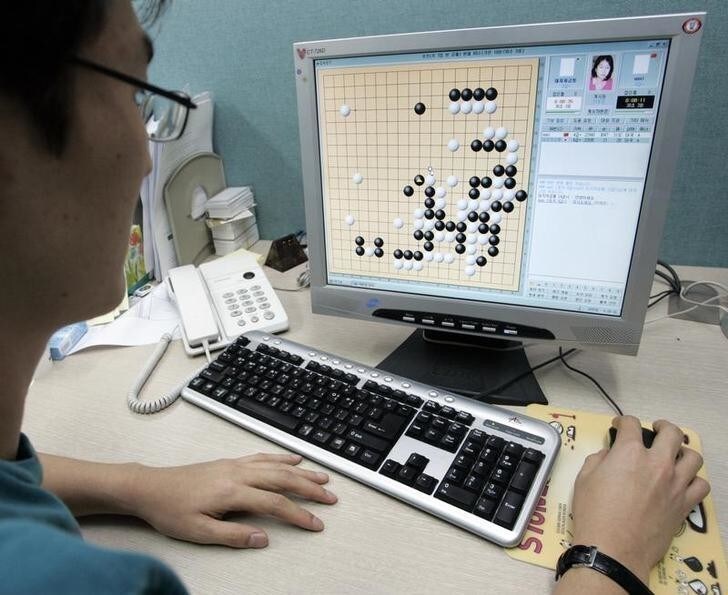
就在去年,谷歌DeepMind的AlphaGo震撼了人工智能(AI)领域,证明计算机程序能够击败世界顶尖围棋选手。
现代AI正以惊人的速度发展。作为这一进展的例证,一个名为AlphaGo Zero的改进版本取得了新的里程碑,相关详情本周发表于《自然》杂志。
AlphaGo Zero使用的算力更少,训练时间也仅有三天,却在一场100局的比赛中以100比0击败了初代AlphaGo。人类甚至不值得出场一战。
学会下围棋
围棋是两名棋手轮流在19×19棋盘上放置“棋子”的策略游戏。目标是比对手围住更大的棋盘区域。
围棋对人类而言易学难精,精通却需一生。Paragorn Dangsombroon/Shutterstock
事实证明,计算机掌握围棋比掌握国际象棋难得多。围棋每种局面下的可能走法远多于国际象棋,可进行的对局也多得多。
初代AlphaGo首先通过研究人类高手的3000万步棋学会下棋。随后,它通过与自己进行多盘对弈,超越了人类专家的水平,这一过程耗费了数月的计算机时间。
相比之下,AlphaGo Zero从未看过人类下棋。它起初只知道游戏规则。通过相对适量的500万盘自我对弈,它仅用三天、在一台比初代AlphaGo配置更低的计算机上,就学会了超越AlphaGo的棋力。
令人着迷的是,它的学习过程大致模仿了人类精通围棋时经历的某些阶段。AlphaGo Zero迅速学会放弃天真的短期目标,发展出更具战略性的思维,并创造出许多顶尖人类棋手常用的棋形。
但令人惊叹的是,它随后开始摒弃其中一些棋形,转而采用人类棋局中从未出现过的新策略。
超越人类棋局
AlphaGo Zero通过采用与初代AlphaGo不同的方法解决问题,取得了这一成就。两个版本都结合了当前推动AI发展的两种最强算法:深度学习和强化学习。
要下围棋这类游戏,程序需要学习两项基本内容。第一项是策略:在给定局面下选择每一种可能走法的概率。第二项是价值:从任一给定局面取胜的概率。
在AlphaGo Zero纯强化学习的方法中,学习策略和价值所能利用的唯一信息,就是预测最终可能由谁获胜。为了作出这一预测,它使用当前的策略和价值,但在起步时,这些都是随机的。
显然,这种方法比初代AlphaGo更具挑战性;初代AlphaGo借助人类专家的棋步,在学习之初抢得先机。但早期版本用不同的神经网络分别学习策略和价值。
AlphaGo Zero的算法突破在于找到将二者整合进一个网络的方法。这大大简化了通过自我对弈进行训练的过程,也使从零开始训练成为可能,无须先学习人类专家会如何下棋。
Elo等级分是衡量围棋、国际象棋等游戏棋手水平的常用指标。迄今为止最优秀的人类棋手柯洁目前的Elo等级分约为3,700。
AlphaGo Zero训练三天后,Elo等级分超过4,000;同一算法的扩展版本训练40天后,等级分则接近5,200。
与最优秀的人类棋手相比,这是惊人的巨大飞跃,远远超过当前顶尖人类国际象棋棋手马格努斯·卡尔森(约2,800)与国际象棋程序(约3,400)之间的差距。
下一个挑战
AlphaGo Zero是AI发展的重要一步,因为它证明了纯强化学习的可行性,且不受任何人类指导的影响。这消除了起步时对大量人类专家知识的需求,而在某些领域,这类知识很难获取。
这也意味着算法可以自由发展全新方法;如果一开始就被限制在“人类思维框架”内,这些方法可能更难发现。令人惊叹的是,这种策略的计算效率也更高。
但围棋是一种规则严密、信息完全的游戏,没有大多数现实问题所具有的复杂性。训练AlphaGo Zero需要按照围棋规则精确模拟数百万盘对局。
对于许多实际问题来说,这类模拟在计算上难以实现,或者问题本身的规则并不明确。
要创造能够在没有特定领域人类干预的情况下解决各种实际问题的通用AI,仍有许多问题需要解决。
尽管人类如今已在与围棋算法的较量中彻底落败,但幸运的是,AI与围棋不同,并非零和游戏。AlphaGo Zero的许多对局现已公开发表,为人类围棋棋手提供了值得终生借鉴的学习素材。
更重要的是,AlphaGo Zero代表着我们向这样一个世界迈进一步:人类可以借助强大的AI,为难题寻找超乎人类想象的创造性解决方案。在AI领域,从未有过比现在更适合放手一搏的时刻。




