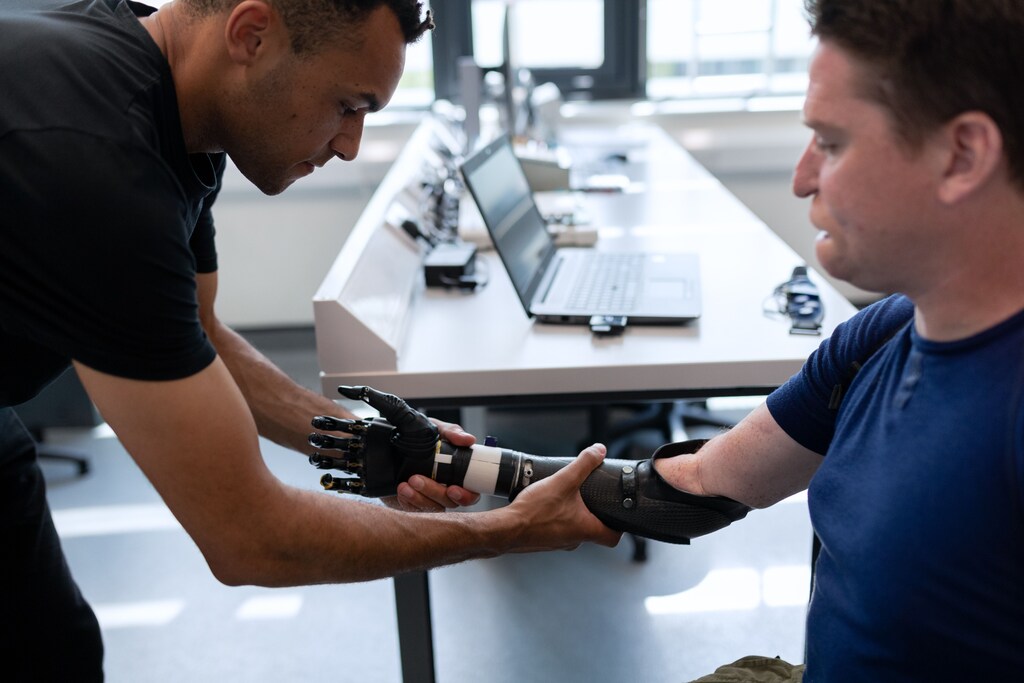
生成式人工智能可以通过推动现有辅助技术和机器人、学习、无障碍适应及可及性解决方案,为残障人士提供支持。
生成式人工智能也给残障人士带来风险。
此类风险与透明度、系统结果理解、认知孤岛、潜在的错误信息与操纵、隐私和所有权有关。
基于生成式人工智能的系统可以通过推动现有辅助技术生态系统以及机器人、学习、无障碍适应和可及性解决方案,为残障人士提供支持。最终,生成式人工智能可以助力更广泛的健康和辅助解决方案。然而,生成式人工智能也带来独特的风险,涉及透明度、系统结果理解、认知孤岛、潜在的错误信息与操纵、隐私和所有权。这些权利和类别由人工智能专门法律加以明确,例如《欧盟人工智能法》、 以及数字框架,例如《欧盟数字市场法和数字服务法》、《无障碍法案》和《残疾人权利公约》。
自《欧盟人工智能法》出台以来,全球各类与之对应的框架、政策和法规均致力于依据风险及相关合规框架对人工智能系统进行分类。生成式人工智能系统成为最受争议的类别:它不属于高风险类别,但仍带来更高的风险和违规隐患,对残障及有功能障碍的群体尤为如此。
此后,包括经济合作与发展组织(OECD)、世界卫生组织(WHO)和联合国教科文组织在内的各国政府和多边机构,围绕教育与研究中的生成式人工智能开展工作,发布了专门报告以及一系列建议和指南,以反映生成式人工智能在教育、医疗保健、工作场所等特定领域的应用,并围绕相关专业和用户素养及能力建设提出建议,以进一步促进采用进程。
在此,我将探讨如何进一步减轻这些风险,以保护具有认知、感官和身体功能障碍的残障群体,并阐述应当考虑的政策因素。
生成式人工智能如何支持残障人士
人工智能算法和系统在支持残障人士及提供便利方面发挥着重要作用,从增强辅助技术和机器人,到创建个性化学习和医疗保健解决方案,皆是如此。生成式人工智能及基于语言的模型进一步扩大了这一影响,以及背后的研发工作。具体而言,此类系统可能推动现有的辅助生态系统、健康、工作、学习和便利化解决方案,这些方案需要与患者或学生进行沟通和互动,并需具备社交和情感智能及反馈能力。此类解决方案经常用于涉及认知障碍、心理健康、自闭症、阅读障碍、注意力缺陷障碍和情绪识别障碍的领域,这些领域很大程度上依赖语言模型和互动。
随着网络和职场无障碍环境的重要性日益提升(包括专门的《欧洲无障碍法案》),基于生成式人工智能的方法可用于创建数字无障碍解决方案,涉及语音转文字或图像转语音的转换。它还可以推动无障碍设计和界面的发展,包括有助于阅读、视觉或认知障碍人士的自适应文本、字体和颜色。类似的算法可用于创建图书馆、知识和教育平台,以服务于辅助便利化、社会保障、微型学习、平等培训和执法等目的。
最后,通过构建此类无障碍和辅助生态系统所探索的方法,可能有助于推动“辅助性前提”——即为残障群体开发的技术,日后可改编用于更广泛的人群,包括“神经未来主义”,从而推动涉及生物反馈、语言和各种媒介形式的新型互动、学习和创造力。
生成式人工智能与伦理
尽管人工智能系统在服务无障碍和辅助技术方面具有积极作用,但残障涉及一系列参数、相关状况、利益相关方、界面和技术,因此要妥善服务残障人士是一项复杂的任务。
具体而言,残障人士可能缺少肢体,身体形态和姿势也可能有所不同。盲人可能无法正确理解视觉提示或信号。听力障碍者可能听不到并遵循有声指令或警告。认知障碍者的沟通方式可能不同,可能缺乏情绪识别能力,并且言语或心理运动模式可能有所差异。众所周知,人工智能算法会歧视面部差异或不对称、不同手势、手势动作、言语障碍、不同沟通方式或辅助设备使用者。联合国残疾人权利问题特别报告员、欧洲残疾人论坛以及众多其他组织和机构均对此类问题表示关切。联合国残疾人权利问题特别报告员、欧洲残疾人论坛以及众多其他组织和机构。
然而,与现有人工智能系统相比,基于语言的平台需要更多关注和伦理指导。具体而言,它们可以模仿人类行为和互动,具有更高的自主性,并在委托决策方面带来挑战。它们还依赖大量数据、机器学习技术的组合,以及其背后的社会和技术素养。
生成式人工智能可能给残障人士带来哪些风险
生成式人工智能相关系统可能以多种方式给残障人士带来风险。具体而言:
•它们可能加剧现有系统中的偏见,例如自动筛选和面试,以及涉及不同类型实体与数字识别以及情境和情感偏见的公共服务。。
•它们可能导致操纵性情境、认知孤岛和回声室效应。例如,在新冠疫情期间,有算法被用于在患者中传播错误信息。
•基于语言的系统可能会给与残障相关的关键词和短语带上负面含义,或因公共数据集存在统计偏差或错误条目而给出错误结果。
•隐私方面——在某些国家,政府机构曾被指控未经同意使用社交媒体数据,以确认患者在养老金计划中的残障状况。
为何会发生这种情况——社会、技术和政策方面的挑战
需要理解的是,这些挑战由与数据、模型、系统和社会实践相关的社会和技术因素所驱动。
具体而言,大量数据集可能包含历史偏见和失真,且缺乏特定参数和条件。不同类型的机器学习技术可能带来不同的失真。以监督学习为例,数据标注人员可能会引入其主观性或错误,并忽视特定模式、案例或背景。无监督学习通常与输入的统计不足和代表性不足有关。强化学习则可能与环境限制或初始经验问题有关。
该领域研究与开发的复杂性体现在以下方面:
•光谱与参数——残障人士可能存在数据集中并不包含的附加状况和功能障碍(合并症)。例如,某些系统曾利用耳廓形状或耳道是否存在来判断图像中是否包含人脸,但该系统无法识别患有颅面综合征(面部功能障碍)的患者。
•性别与交叉性——用于城市规划的基础设施和城市数据集被普遍认为存在“性别盲区”。就认知障碍而言,女孩常因表现标准不同而被误诊,且在研究统计中长期代表性不足,从而影响数据标签。存在性别盲区。就认知障碍而言,女孩经常被误诊,且在研究统计中长期代表性不足,从而影响数据标签。
•数据获取不足——某些社会群体(例如美国的白人家庭)更有可能因为更好的医疗条件而报告与儿童自闭症相关的问题。与此同时,在某些国家,移民因担心被驱逐或面临无法承受的医疗费用,往往避免儿童自闭症因医疗条件较好而更易被发现。与此同时,在某些国家,移民往往因担心被遣返或面临无法承受的医疗费用而避免医学检查和测试。
•研究和/或证据不足——众所周知,某些针对呼吸或心脏问题的医疗方案是在短期观察之后开发的。经过更长时间的测试后,发现该系统效率并不高,且带来了负面副作用,但此时它已经投入使用。
•参与度不足——法律和司法系统众所周知,其训练所用的公开数据集超出了其特定管辖范围,往往忽视了特定群体和人群的参与。
•代理指标与泛化——众所周知,医疗评估系统是基于“标准化”的人口和健康群体创建的。这可能导致年轻人群中某些严重的认知和心理障碍被普遍排除在外,而仅归因于年长群体。众所周知,医疗和社会服务也会使用画像——即依据兴趣而非个人特征对人群进行分组——这可能导致歧视性结果。
•主观性——众所周知,评估平台是基于“正常”标准进行训练的,这些标准被发现会给残障群体在评估就业能力或专业素养及智力能力等特征时带来主观性。

未来之路
即将出台的国家人工智能战略(例如德国、英国、美国和中国)凸显了生成式人工智能系统的复杂性。这些战略关注国家安全,以及为避免数据孤岛而获取数据,确保公平的技术竞争与实践,提升素养和能力,并推出隐私与伦理标准。此外,世界卫生组织、联合国教科文组织和经合组织等多边机构正围绕医疗保健、教育、素养和能力建设等领域制定针对特定领域的指南和建议(例如联合国教科文组织——面向学生和教师的人工智能能力框架,2023年)。
然而,从技术和政策角度看,以残障为核心的生成式人工智能系统的研究与开发仍是一项复杂任务。这包括其交叉性特征、状况谱系、合并症、性别和年龄相关参数、模块化和多利益相关方情景(例如家庭、照护者、多种设备和界面可能同时参与的情况),以及针对不同细分领域、行业和案例制定特定状况的采用与素养指南的必要性。
除一般标准外,还需针对特定群体、年龄段和状况谱系,制定专门的系统类别、风险和合规要求;必须提高机器学习技术的透明度,改进结果评估方法,确保公共数据集和历史统计数据的可及性与多样性;为数据收集、隐私和同意设定界限与规则;明确应承担责任的作为与不作为;并最终理解滥用的情形。因此,应更加重视非人工智能专门法律的作用,例如数字框架——《欧盟数字市场法和数字服务法》、无障碍法案以及《残疾人权利公约》。




