世界经济论坛每周播客《达沃斯电台》推出了一个关于生成式人工智能(AI)的专题系列。
第一集探讨了人工智能为何突然成为头条焦点,并邀请了IBM的人工智能伦理负责人和一位资深人工智能教授分享观点。
人工智能是一头“强大的野兽”——能否将其驯服,造福人类?
人工智能播客系列:
第1集:人工智能:为何人人都在谈论这头“强大野兽”的前景与风险
第4集:“人工智能要么与我们竞争,要么增强我们的能力”——我们该如何选择正确的道路?
第5集:人工智能:汇聚各方利益相关者,让人工智能为所有人服务
特别加播集:人工智能——可能会出什么问题?:斯图尔特·拉塞尔教授
“这是世界各地的人们第一次能够使用并与人工智能系统互动。它确实是一个改变游戏规则的存在,因为每个人都能体验人工智能系统的能力。”
IBM研究院伦理负责人弗朗西斯卡·罗西正在谈论ChatGPT。如果您还没有使用过这款生成式人工智能工具,至少您大概也听说过它。自去年底推出以来,它已迅速成为历史上增长最快的消费级应用。
ChatGPT以及其他“大语言模型”的爆发式发展,已将人工智能的潜力带入公众视野,引发了许多关于伦理与机遇的问题,也让许多监管机构疲于跟上步伐。
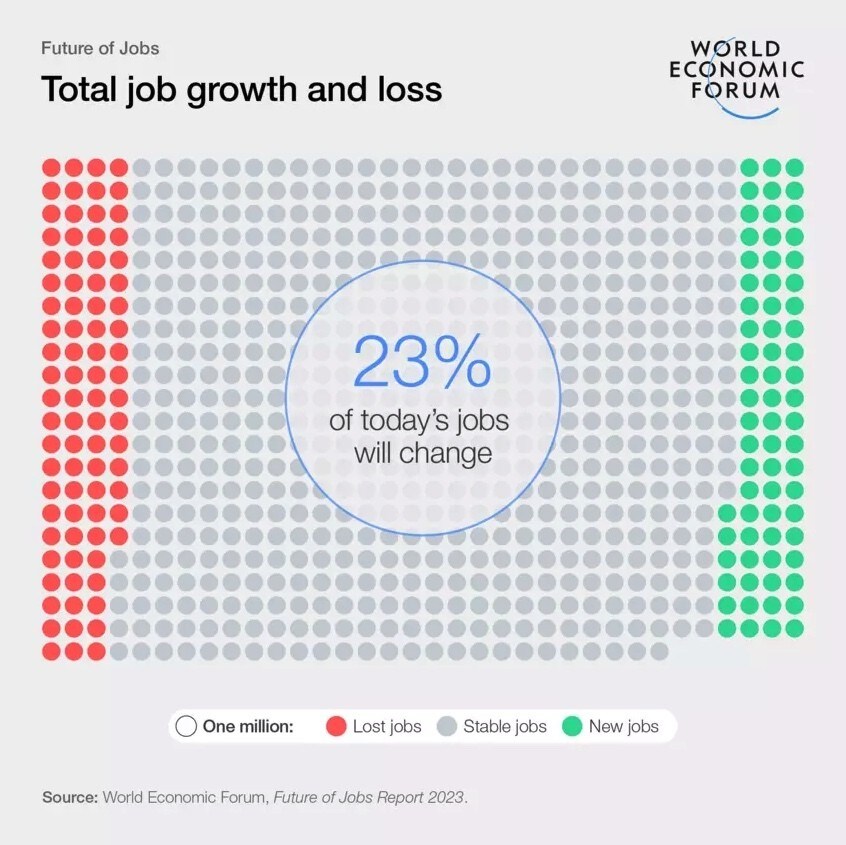
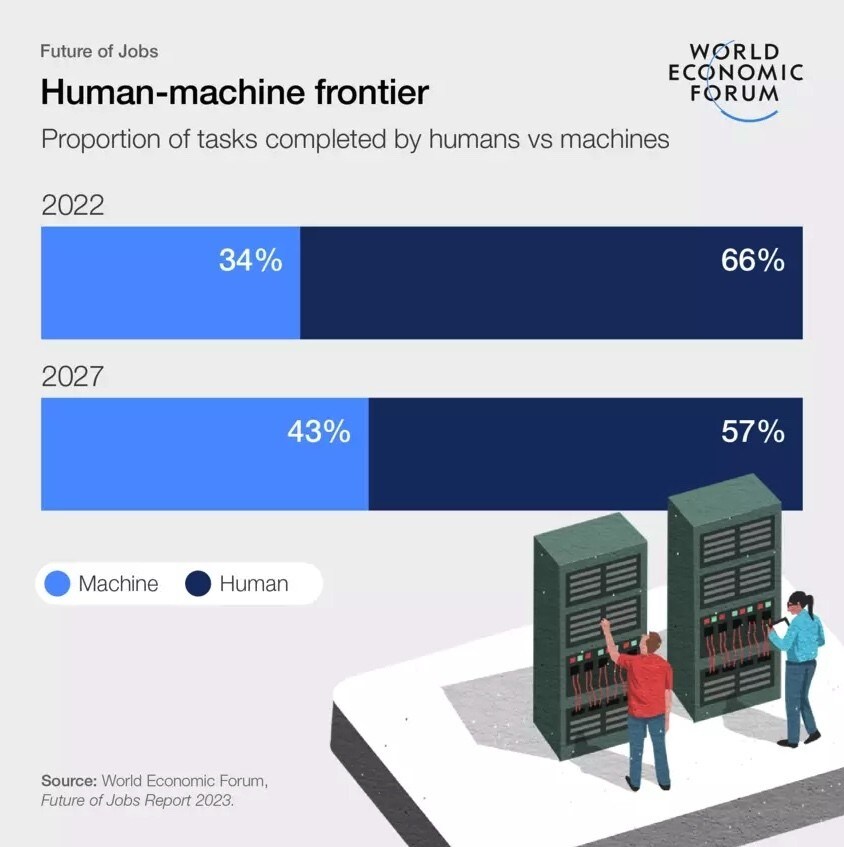
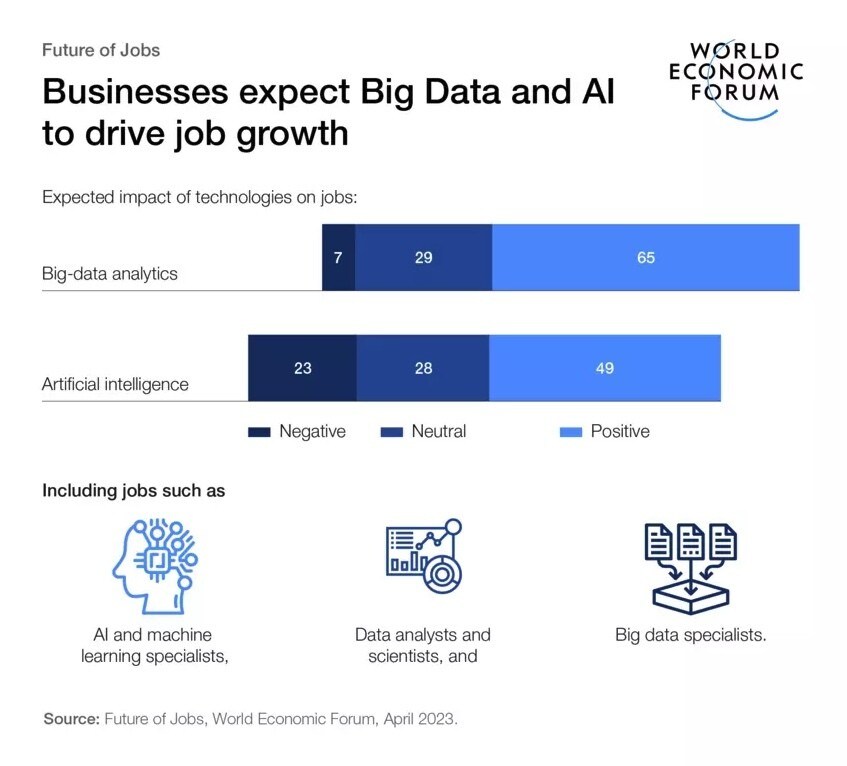
根据世界经济论坛最新发布的《未来就业报告》,雇主预测,几乎四分之一的工作岗位将受到技术影响。此外,随着认知能力、复杂问题解决能力和科技素养变得日益重要,工作场所所需技能中有44%将在五年内发生变化。
为深入探讨这些议题,世界经济论坛每周播客《达沃斯电台》推出了一个六集系列节目,邀请专家和思想家参与对话,探讨当前最重大的挑战及我们如何应对,以及人工智能改变我们生活和工作方式的潜力。
在第一集中,我们与罗西以及香港科技大学计算机工程教授、该校人工智能研究中心主任冯玜思进行了交谈。以下为这些对话的编辑版本。
在本系列中,我们还将解释一些与人工智能相关的专业术语。在本集中,世界经济论坛人工智能、数据与元宇宙负责人李晨(Cathy Li)为“大语言模型”(LLM)作出定义:
什么是大语言模型人工智能?
李晨:简单来说,大语言模型是一种智能计算机程序,能够理解并生成类似人类的语言。它采用一种称为深度学习的人工智能技术,并通过来自书籍、文章、网站及其他来源的海量文本数据进行训练,从而理解并学习词语和句子之间的规律与关联。
在训练过程中,模型会分析文本数据,并尝试根据句子中已出现的词语,预测下一个词。
当您与语言模型互动时,您需要向其提供一个提示或问题。模型会运用其已学习的知识,通过预测最可能符合您想表达语境的词语和句子,来生成回应。
小型语言模型与大型语言模型之间显然存在差异,而其临界点有时实际上难以预测。但科学家们观察到,在越过某些临界点后,模型的能力会呈指数级跃升,而科学家们也正是在此时发现了一些令人意外的涌现特性,这些特性是他们此前从未见过、也无法预测的。
什么是对话式人工智能?
冯玜思:从技术层面来讲,对话式人工智能系统主要有两类。基本上,它指的是用户(即人类用户)与机器之间的互动。
第一类包括开放域聊天机器人,通常您可以就任何话题进行交谈,因此称为开放域,只要您愿意,便可以聊任何话题。
另一类对话式人工智能系统被称为任务导向型对话系统。您的虚拟助手、智能手机助手以及呼叫中心的虚拟助手——这些都是对话系统或对话式人工智能系统,旨在完成任务,回答用户的查询。
这些人工智能的巨大进步背后有什么?
冯玜思:生成式人工智能已经存在了一段时间——它早于深度学习和神经网络。但与前几代相比,近期的生成式人工智能模型要强大得多,因为它们拥有海量的训练数据和极大的参数规模。
这些生成式人工智能模型,尤其是大语言模型,被用作基础模型,以构建对话式人工智能系统。
人们普遍存在一种误解,认为ChatGPT是一种对话式人工智能系统。从技术上讲,它并不是。ChatGPT是我们所称的基础模型。也就是说,它们是能够执行多种任务的大语言模型。此外,它还配备了聊天界面,相当于用户通过聊天与底层大语言模型互动的用户界面。
因此,ChatGPT可用于构建其他系统,包括但不限于对话式人工智能系统。
弗朗西斯卡·罗西:我并没有真正看到巨大的变化,我看到的是数十年来的逐步演进。
但与我过去接触人工智能的经历相比,如今的不同之处在于,这些研究成果以非常简洁的界面呈现,人人都可以使用。
人们在日常网络生活中几乎所有的活动中都已在使用人工智能,只是他们并未意识到,因为它隐藏在各类应用程序之中,也就是我们在网上使用的各种东西里。
您对未来哪些应用充满期待?
冯玜思:我希望能找到一些解决方案,使我们能够利用生成式人工智能或对其加以控制。
如今,这些大语言模型就像一头头强大的野兽,对吧?我们需要算法和方法来驯服这些野兽,然后将它们用于造福人类。
从长远来看,我希望看到更多有益的人工智能应用,例如在医疗领域:为老年人提供医疗保健,为无法获得先进医疗服务的弱势群体提供医疗保健。我们可以借助人工智能技术,使此类医疗服务更加普惠。
如今,从现在到那个目标之间的道路尚不明朗。也许我们能在一年内实现;也许我们需要另一次范式转变才能到达那里。但这正是生成式人工智能这一领域令人兴奋之处。在与这些模型合作时,我们几乎是在进行科学发现,并且我们正在学习与之协作的新方法,以及如何在日常工作中充分利用它们。

人们为何对此感到担忧?
弗朗西斯卡·罗西:上一波人工智能浪潮中就存在一些问题——我们对偏见、可解释性、透明度、稳健性、隐私等问题都了如指掌。但如今这些问题依然存在,并且又出现了一些新问题,这些问题同样与生成内容的能力有关。
例如,错误信息可能传播,以及一些版权问题或与隐私相关的问题。
滥用也确实可能发生。提示可以是任何内容,但我们必须在这些大语言模型中嵌入适当的应对机制。
我认为,未来我们需要找到更有效的方法,这些方法不应是在大语言模型构建完成后再加上的过滤器,而应嵌入模型本身的构建之中。
冯玜思:无意造成的伤害也让我深感担忧。有些人出于一片好心,正试图构建一个系统,帮助患者寻找各种疾病的治疗方法,类似于基于人工智能的某种WebMD。他们认为这将帮助人们获取健康信息等。但他们并不知道,这些生成式人工智能系统给出的一些答案是不正确的。
鉴于当前该领域投入巨大——仅使用生成式人工智能和ChatGPT的初创企业就有数千家——我担心很多人并不了解ChatGPT的局限性,进而开发出一些他们声称将实现某种功能、实际却在做其他事情、并非其设计初衷的应用程序。
人工智能的发展是否存在速度过快的风险?
冯玜思:风险已经存在。我们已经看到,人们正在以非设计初衷的方式使用生成式人工智能。
我很欣慰地看到,我们在前沿研究方面取得了进展,包括找到减轻人工智能危害的方法。
我担心部署的速度过快,因为我们在部署一些我们并不完全了解其影响的系统。我们不一定需要向每一位使用者详细解释我们所部署的人工智能系统,但在将系统投放到现实环境之前,我们需要有信心能够减轻其危害。
弗朗西斯卡·罗西:我会区分构建、发布和部署人工智能模型这一价值链中的不同阶段。
我认为,我们更需要推动并加快研发工作,因为这些领域有助于我们更好地理解如何减轻相关问题。
当然,我们也需要对价值链的后期阶段保持谨慎,例如部署和应用。正因如此,我认为政策和法规应更多地作用于价值链的这一部分,而非最初的环节。
在全球或区域性人工智能治理方面,我们目前处于什么阶段?
弗朗西斯卡·罗西:我认为,目前讨论最为全面的立法是欧洲正在围绕《欧盟人工智能法案》提案开展的工作。该提案仍处于草案阶段,有许多不同的修正提议,但很快将获得欧洲议会的批准。
我欣赏该法规的一点在于其基于风险的思路,即风险与人工智能所应用的场景相关。法规中列出了“高风险用途”清单,例如用于人力资源应用,决定录用谁或晋升谁等。这正是高风险应用领域之一。
目前,关于如何使该法规也涵盖生成式人工智能和大语言模型,存在大量讨论。
我希望这不会将基于风险的框架的重点,从应用领域转移到技术本身。因为有一些讨论反而认为,无论应用于何处,这些模型都是有风险的。
我认为那将是一个重大错误。
我们还能通过哪些方式减轻与人工智能相关的一些风险?
冯玜思:减轻风险是一项多方利益相关者的工作,也是一项跨国性的工作,而我们对构建这些系统的人员却谈得不够多。
因此,首先应从我们自身遵守行为准则做起,研究工程师必须遵守这一行为准则。
与此同时,我们需要设计算法,使其能够与人类价值观保持一致。

请在以下网址查看我们的全部播客:wef.ch/podcasts:




