这项工作是迈向分子存储系统的一步,此类系统有望在极小空间内容纳海量数据。
DNA分子作为海量生物信息的载体广为人知,并且人们对将其用于工程化数据存储设备的兴趣日益增长使用DNA于工程化数据存储设备,其可容纳的数据量远超我们目前的硬盘。但DNA并非唯一的选择。
这项新研究表明,可以在人工代谢组(即含有糖类、氨基酸及其他类型小分子的液体混合物阵列)中存储和读取数据。在PLOS ONE上发表的论文中,研究人员展示了他们能够将千字节级的图像文件编码到代谢物溶液中,并再将信息读取出来。
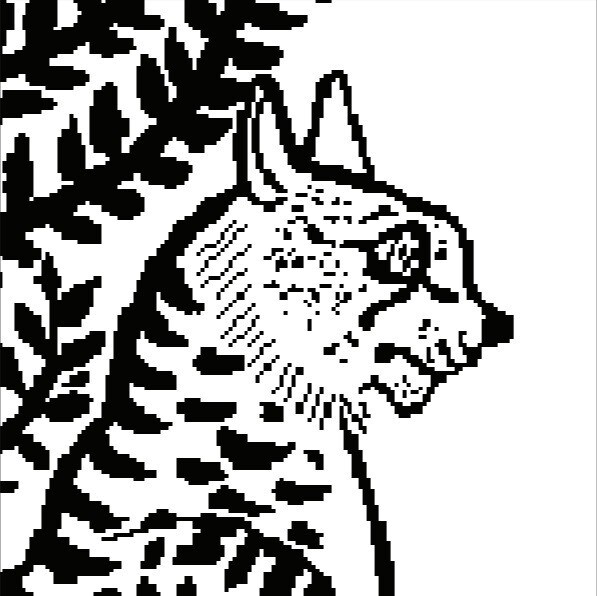
该方法将数字数据中的1和0映射为溶液中特定分子的存在与否。研究人员利用这一方案将图像文件编码到溶液中。
“这是一项概念验证研究,我们希望它能促使人们思考如何利用更广泛的分子种类来存储信息,”布朗大学工程学院教授、本研究的通讯作者雅各布·罗森斯坦(Jacob Rosenstein)说道。“在某些情况下,我们这里所用的此类小分子的信息密度甚至可能高于DNA。”
罗森斯坦表示,另一项潜在优势源于许多代谢物可以相互反应生成新化合物。这使得分子系统不仅能够存储数据,还能够对其进行处理,即在代谢物混合物内部执行计算成为可能。
3,000,000,000,000,000,000,000,000 比特数据
分子计算的理念源于对更大数据存储容量日益增长的需求。据某些估计,到2040年,全球产生的数据量将高达3尔(septillion,即3后面跟24个零)比特。存储、检索和处理所有这些数据是一项艰巨的挑战,而地球上可能根本没有足够的芯片级硅材料来使用传统半导体芯片完成这一任务。
在美国国防高级研究计划局(DARPA)的资助下,布朗大学的一组工程师和化学家一直在研究多种利用小分子构建新型信息系统的技术。
在这项新研究中,该团队希望探究人工代谢组能否成为一种数据存储方案。在生物学中,代谢组是生物体用于调节其新陈代谢的全部分子集合。
“认识到细胞和生物体利用小分子传递信息并不难,但要进行概括和量化则较为困难,”布朗大学博士后研究员、本研究第一作者埃蒙·肯尼迪(Eamonn Kennedy)说道。“我们希望证明代谢组如何能够编码精确的数字信息。”
他们的做法
研究人员自行组装了人工代谢组,即由不同分子组合构成的小型液体混合物。混合物中某种特定代谢物的存在与否编码一个比特的数字数据,即0或1。人工代谢组中分子种类的数量决定了每种混合物能够容纳的比特数。
在本研究中,研究人员构建了包含六种和十二种代谢物的文库,这意味着每种混合物可分别编码六比特或十二比特。随后,数以千计的混合物以纳升级液滴的形式排列在小型金属板上。液滴的内容物及其排列方式由液体处理机器人精确放置,从而编码所需的数据。
随后将金属板干燥,在板上留下微小的代谢物分子斑点,每个斑点均承载着数字信息。随后可使用质谱仪读取数据,该仪器能够识别板上每个斑点中存在的代谢物,并对数据进行解码。
研究人员成功运用该技术对多种大小不超过2千字节的图像文件进行了编码和读取。研究人员表示,就现代存储系统的容量而言,这一规模并不大,但它是一项扎实的概念验证。而且,该技术在扩大规模方面潜力巨大。混合物中的比特数随人工代谢组中代谢物数量的增加而增加,而可供使用的已知代谢物有数千种。
代谢组的潜力
研究人员指出,该方法存在一些局限。例如,许多代谢物在置于同一溶液中时会发生化学相互作用,这可能导致错误或数据丢失。但这一缺陷最终也可能转化为一项功能。或许可以利用这些反应来处理数据,即在溶液内进行计算。
“利用分子进行计算是一个巨大的机遇,我们才刚刚开始摸索如何加以利用,”化学助理教授、本研究的共同作者布伦达·鲁本斯坦(Brenda Rubenstein)说道。
“此类研究挑战了人们对分子数据系统可能性的固有认知,”罗森斯坦说道。“DNA并非唯一可用于存储和处理信息的分子。令人兴奋的是,我们认识到还存在其他具有巨大潜力的可能性。”




