通用智能
人工智能已经相当擅长完成特定任务,但距离具备通用智能,也就是那种能让人工智能像人类甚至动物一样在世界中行动的全面智慧,仍有很长的路要走。
抽象推理是通用智能的关键要素之一——它指的是超越“此时此地”进行思考、发现更微妙的模式和关系,并开展复杂思维的能力。周三(11日),DeepMind的研究人员——这家专注于人工智能的谷歌子公司——发表了一篇论文,详细介绍了他们测量各种人工智能抽象推理能力的尝试。为此,他们参考了我们用来测量自身能力的同类测试。
人类智商
在人类身上,我们通常通过相当直接的视觉智商测试来衡量抽象推理能力。一种名为瑞文渐进矩阵的热门测试包含数行图像,最后一行缺少最后一幅图。应试者需要根据已完成各行所呈现的规律,选择接下来应该出现的图像。
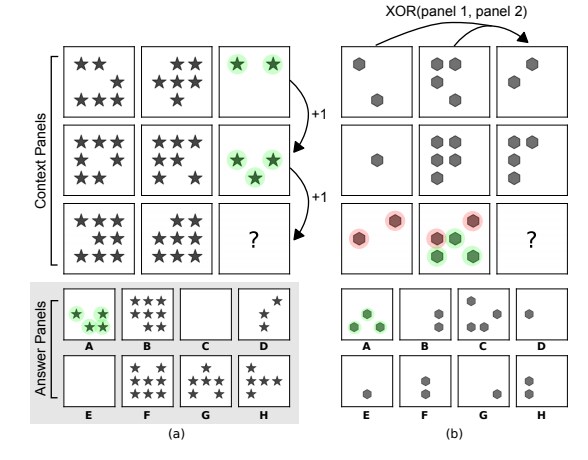
这项测试不会直接告诉应试者应该在图像中寻找什么——变化规律可能与每幅图中的物体数量、颜色或位置有关。应试者需要运用抽象推理能力自行找出规律。
为了将这项测试用于人工智能,DeepMind的研究人员创建了一个能够生成独特矩阵题目的程序。随后,他们训练了各种人工智能系统来解答这些矩阵题。
最后,他们对这些系统进行了测试。在某些情况下,他们使用的测试题与训练集具有相同的抽象因素——例如,训练和测试人工智能时,题目都要求它考虑每幅图中的形状数量。在其他情况下,他们使用的测试题包含了训练集中没有的抽象因素。例如,他们可能用要求人工智能考虑数量的题目进行训练,要求它考虑每幅图中的形状数量;但测试时,却改用要求它考虑形状位置的题目,让它据此找出正确答案。
下次再努力
测试结果并不理想。当训练题和测试题着眼于相同的抽象因素时,这些系统表现尚可,答对率为75%。然而,如果测试集与训练集不同,即使差异很小(例如,训练时使用深色物体组成的矩阵,测试时改用浅色物体组成的矩阵),人工智能的表现也非常糟糕。
归根结底,团队设计的人工智能智商测试表明,即使是当今一些最先进的人工智能,也无法解决我们没有训练它们解决的问题。这意味着通用人工智能可能仍遥不可及。不过,至少现在我们有了一种直接的方法来追踪进展。




