
2014年期间,一名恶作剧者多次向美国海岸警卫队拨打虚假的遇险电话,想必以为自己不会被抓到。他们没有留下指纹或DNA证据,还确保通话时间短到调查人员无法通过三角测量确定其位置。
然而,这名恶作剧者恐怕要失望了。如今,人工智能驱动的语音分析技术已经先进到能揭示远超一枚指纹的信息。通过强大的技术分析录制的语音,如今的科学家能够有把握地预测各种信息:从说话者的身体特征——例如身高、体重、面部结构和年龄——到其社会经济背景、收入水平,甚至身心健康状况。
这一领域的领军科学家之一是卡内基梅隆大学的丽塔·辛格,她任职于语言技术研究所。美国海岸警卫队把2014年那些恶作剧电话的录音发给她时,辛格已经从事语音识别研究20年了。她在今年早些时候接受《科技女性秀播客采访时说:“他们说,‘你能告诉我们什么,就告诉我们什么。’“那时我开始着眼于信号之外的信息。我能告诉海岸警卫队关于这个人的多少情况?”
你的声音透露了哪些信息
辛格及其卡内基梅隆大学同事开发的技术,会分析并比较人们发音方式中细微的差别,这些差别小到人耳无法察觉。随后,他们把录制的语音拆分成持续时间仅为几毫秒的微小音频片段,再利用人工智能技术仔细检视这些片段,寻找独特标识。
你的声音还能透露大量环境信息。例如,这项技术可以推测说话者所在房间的大小、房间是否有窗户,甚至墙壁由什么材料制成。或许更令人惊叹的是,人工智能能够检测录音中由当地电网波动留下的特征,再将这些特征与特定数据库匹配,从而相当准确地判断来电者的具体位置,以及他们拿起电话的准确时刻。
当然,这项技术的用途远不止调查恶作剧电话。近来,这项技术已协助处理从骚扰到虐待儿童等联邦刑事案件。辛格说:“在以语音为依据的案件中,犯罪者已经被找到并认罪,他们的供述在很大程度上证实了我们的分析。”
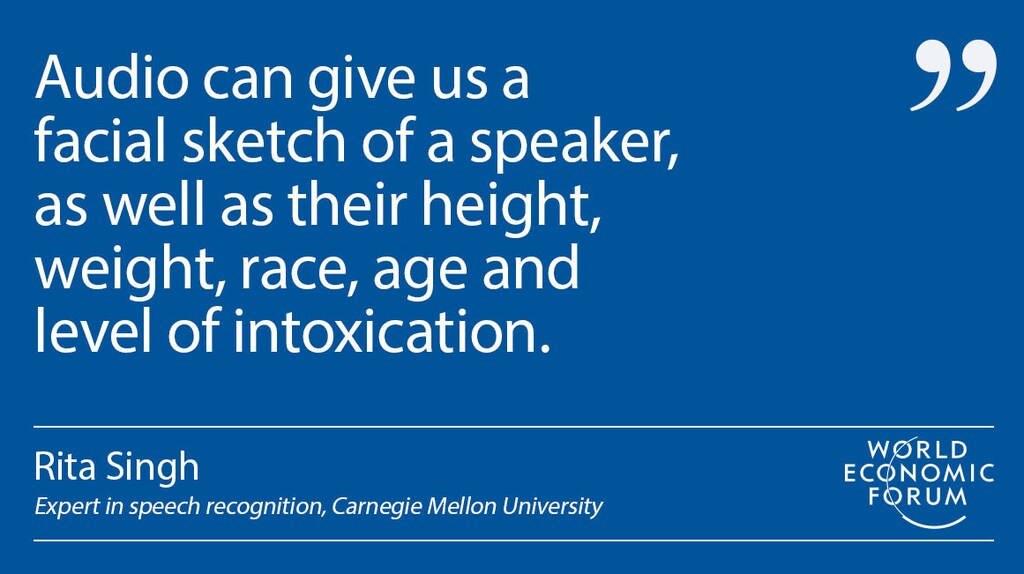
三维肖像
而这项研究才刚刚起步:辛格和其他研究人员正在开发新技术,仅凭语音录音就能为警方提供嫌疑人的三维视觉肖像。她说:“音频可以让我们勾勒出说话者的面部轮廓,还能判断其身高、体重、种族、年龄和醉酒程度。”
不过,这类基于语音的画像技术要在法庭上获得实际应用,还有一段路要走。辛格解释说:“关于证据是否可采,会有一些疑问。我们现在的处境有点像1987年DNA技术刚出现时,那一年美国首次出现基于DNA证据的定罪。”
这一切显然给那名毫不知情的海岸警卫队恶作剧来电者带来了坏消息。在美国,向紧急服务机构拨打恶作剧电话被视为联邦犯罪,可处以高额罚款和数年监禁;而通常,电话录音本身就是唯一可用的证据。辛格制作的个人特征档案帮助海岸警卫队排除了错误线索并锁定一名嫌疑人,他们希望不久后提起诉讼。
鉴于当前技术正以指数速度发展,可以肯定,这项技术未来会更广泛地被执法部门采用。至于正在读这篇文章、可能打算拨打恶作剧电话的人:眼下最好还是沿用老办法,用报纸剪字再粘贴。只要别留下指纹就行。




