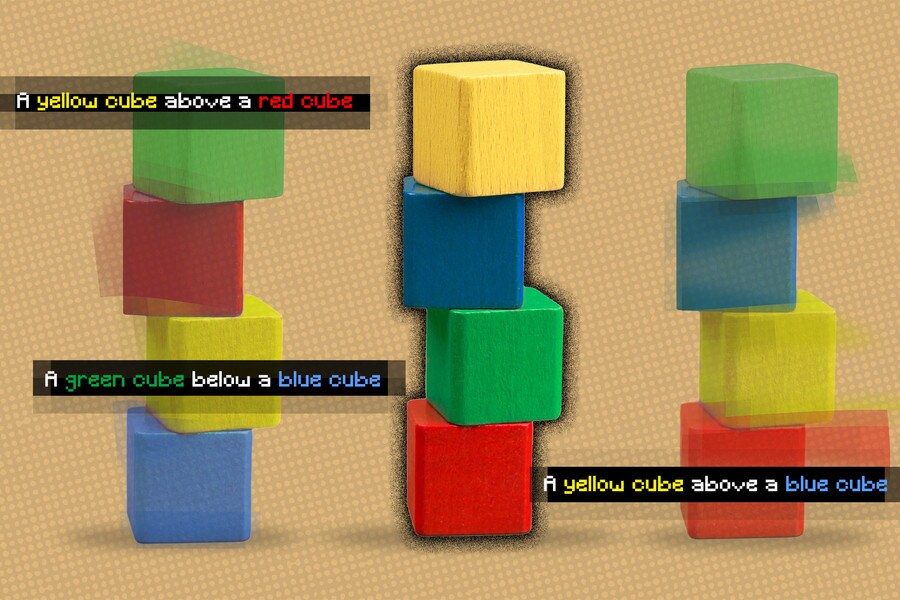
麻省理工学院研究人员开发了一种模型,能够理解场景中物体之间的内在关系。
该模型一次表示一种具体关系,然后将这些表示组合起来描述整个场景。
这使模型能够根据文字描述生成更准确的图像,即使场景中包含多个彼此关系各异的物体,也能做到这一点。
人类观察场景时,会看到物体及其相互关系。你的桌面上可能有一台笔记本电脑,它位于手机左侧,而手机又在电脑显示器前面。
许多深度学习模型难以这样看待世界,因为它们无法理解单个物体之间错综复杂的关系。由于缺乏对这些关系的认识,一台旨在帮助人们料理厨房事务的机器人,就难以听从这样的指令:“拿起炉子左边的锅铲,把它放在砧板上。”
为解决这一问题,麻省理工学院研究人员开发了一种模型,能够理解场景中物体之间的内在关系。该模型一次表示一种具体关系,然后将这些表示组合起来描述整个场景。这使模型能够根据文字描述生成更准确的图像,即使场景中包含多个彼此关系各异的物体,也能做到这一点。
这项研究可应用于工业机器人需要执行复杂、多步骤操作任务的场景,例如在仓库堆叠物品或组装家电。它也让该领域朝着实现这样的机器更进一步:机器能够像人类一样从环境中学习并与环境互动。
“我看一张桌子时,不会说某个物体位于 XYZ 坐标。我们的思维不是这样运作的。在我们看来,理解一个场景,实质上是根据物体之间的关系来理解它。我们认为,如果构建一个能够理解物体之间关系的系统,就可以利用它更有效地操控和改变周围环境。”叶伦·杜(Yilun Du)说。他是计算机科学与人工智能实验室(CSAIL)的博士生,也是论文的共同第一作者。
杜与共同第一作者、CSAIL 博士生李爽(Shuang Li)以及伊利诺伊大学厄巴纳-香槟分校研究生刘楠(Nan Liu)共同撰写了这篇论文;其他作者还包括脑与认知科学系计算认知科学教授、CSAIL 成员约书亚·B·特南鲍姆(Joshua B. Tenenbaum),以及资深作者安东尼奥·托拉尔巴(Antonio Torralba)。托拉尔巴是电气工程与计算机科学系三菱电机教授,也是 CSAIL 成员。研究成果将于 12 月在神经信息处理系统大会上发表。
一次处理一种关系
研究人员开发的框架可以根据物体及其关系的文字描述生成场景图像,例如:“一张木桌在蓝色凳子的左边。一张红色沙发在蓝色凳子的右边。”
该系统会把这些句子拆分为两个较小的部分,分别描述一种关系(“一张木桌在蓝色凳子的左边”和“一张红色沙发在蓝色凳子的右边”),然后分别对每个部分建模。随后,系统通过优化过程将这些部分组合起来,生成场景图像。
研究人员使用一种称为基于能量的模型的机器学习技术,来表示场景描述中物体之间的具体关系。这项技术使他们能够用一个基于能量的模型编码每种关系描述,再将这些模型组合起来,从而推断出所有物体及其关系。
李解释说,将句子拆分成描述各个关系的较短部分后,系统就能以多种方式重新组合这些部分,因此更能适应此前未见过的场景描述。
“其他系统会整体处理所有关系,并根据描述一次性生成图像。然而,遇到分布外描述时,例如关系数量更多的描述,这类方法就会失效,因为这些模型实际上无法通过一次处理生成包含更多关系的图像。不过,由于我们把这些彼此独立的小模型组合起来,就能够建模数量更多的关系,并适应新的组合。”杜说。
该系统也能反向工作——给定一张图像,它可以找出与场景中物体关系相符的文字描述。此外,这种模型还可用于编辑图像:重新排列场景中的物体,使其符合新的描述。
理解复杂场景
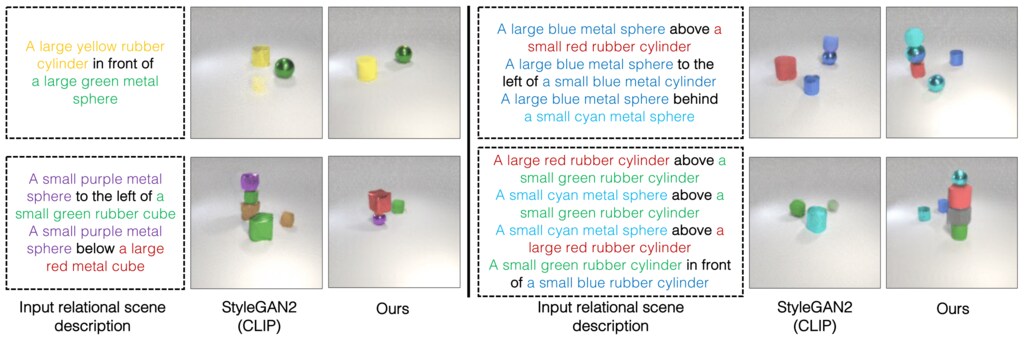
研究人员将他们的模型与其他深度学习方法进行了比较。这些方法接收文字描述,并据此生成展示相应物体及其关系的图像。在每种情况下,他们的模型都优于基准方法。
他们还请人们评估生成的图像是否符合原始场景描述。在最复杂的示例中,描述包含三种关系,有 91% 的参与者认为新模型表现更好。
“我们发现一件有趣的事:对于我们的模型,可以把句子从包含一种关系描述增加到两种、三种,甚至四种描述;我们的方法仍能生成与这些描述相符的图像,而其他方法则会失效。”杜说。
研究人员还向模型展示了它此前未见过的场景图像,以及每张图像的多种不同文字描述。模型能够成功找出与图像中物体关系最相符的描述。
研究人员还给系统提供了两种描述同一图像、但表述方式不同的关系场景描述;模型能够理解这两种描述含义相同。
研究人员对模型的稳健性印象深刻,尤其是它处理此前未遇到过的描述时的表现。
“这非常令人鼓舞,因为它更接近人类的工作方式。人类可能只看到几个示例,但我们能从这几个示例中提取有用信息,并将它们组合起来,创造出无限种组合。我们的模型也具备这样的特性:只需较少数据就能学习,同时推广到更复杂的场景或图像生成任务。”李说。
尽管这些早期结果令人鼓舞,研究人员仍希望了解模型在更复杂的真实图像上的表现,这些图像背景杂乱,物体之间还会相互遮挡。
他们也有兴趣最终将模型集成到机器人系统中,使机器人能够从视频中推断物体之间的关系,再运用这些知识操控现实世界中的物体。
“开发能够应对周围世界组合特性的视觉表征,是计算机视觉领域亟待解决的关键问题之一。这篇论文提出了一种基于能量的模型,明确建模图像中物体之间的多种关系,从而在这一问题上取得了重大进展。研究结果确实令人印象深刻。”捷克理工大学捷克信息学、机器人与控制论研究所杰出研究员约瑟夫·西维茨(Josef Sivic)说。他没有参与这项研究。
这项研究部分由雷神 BBN 技术公司(Raytheon BBN Technologies Corp.)、三菱电机研究实验室、美国国家科学基金会、美国海军研究办公室以及 IBM 托马斯·J·沃森研究中心资助。




