人工智能已到达一个转折点,即将影响新一类工作——艺术家和知识工作者。
过去的技术飞跃曾淘汰了某些类型的工作,但也促使人们发展新技能,OpenAI的ChatGPT可能会带来类似的影响。
当前的人工智能仍存在一些局限,而随着人们对人工智能进行微调以生成理想结果,新的工作岗位可能会应运而生。
五位人工智能研究人员在此探讨这一新兴技术可能如何影响创意产业中的人们。
从蒸汽动力、电力到计算机和互联网,技术进步一直在扰乱劳动力市场,淘汰一些工作的同时也创造了另一些工作。人工智能在某种程度上仍是一个误称——最智能的计算机系统实际上依然并不真正“懂”任何东西——但这项技术已到达一个转折点,即将影响新一类工作:艺术家和知识工作者。
具体而言,大型语言模型——即基于海量文本训练的人工智能系统——的出现,意味着计算机如今能够生成类似人类的书面语言,并将描述性短语转化为逼真的图像。《对话》(The Conversation)邀请了五位人工智能研究人员,探讨大型语言模型可能如何影响艺术家和知识工作者。正如我们的专家所指出的,该技术远非完美,由此引发了一系列问题——从错误信息到剽窃——都会对人类工作者产生影响。

人人皆可创作——但技能会否流失?
Lynne Parker,田纳西大学副校长
大型语言模型正使创意和知识工作变得人人可及。任何拥有网络连接的人,如今都可以使用ChatGPT或DALL-E 2等工具来表达自我,并通过生成文本摘要等方式,理解海量信息。
尤其值得注意的是,大型语言模型所展现出的类人专业能力之深。新手只需几分钟,便可为其商业演示制作插图、生成营销推介文案、获取克服写作瓶颈的灵感、或生成新的计算机代码以执行指定功能,其质量通常可与人类专家相媲美。
当然,这些新的人工智能工具无法读心。人类需要一种新的、虽然更简单、但仍属于创造力的形式,即以文本提示的方式,才能获得人类用户所寻求的结果。通过迭代式提示——这是一种人机协作的范例:人工智能系统会不断生成一轮又一轮的输出,直到撰写提示的人对结果感到满意为止。例如,近期的科罗拉多州博览会数字艺术类别比赛,该(人类)获胜者使用了一款人工智能驱动的工具,展现了创造力,但并非那种需要画笔以及对色彩和质感有敏锐眼光的创造力。
尽管向所有人开放创意和知识工作的世界带来了显著益处,这些新的人工智能工具也存在弊端。首先,它们可能加速那些在未来几年仍将保持重要性的人类技能的流失,尤其是写作能力。教育机构需要制定并执行政策,规定大型语言模型的允许用途,以确保公平竞争与理想的学习成果。
其次,这些人工智能工具引发了有关知识产权保护的问题。虽然人类创作者经常从世界上现有的作品中获得灵感,包括建筑,以及他人的著作、音乐和绘画,但大型语言模型对受版权保护或开源的训练样本的适当与合理使用,仍存在未解答的问题。正在进行中的诉讼正就这一问题展开辩论,这可能会对大型语言模型未来的设计与使用产生影响。
随着社会应对这些新型人工智能工具所带来的影响,公众似乎已准备好接纳它们。聊天机器人ChatGPT迅速走红,图像生成工具Dall-E mini等亦然。这表明创造力存在巨大的未开发潜力,也说明了让创意和知识工作惠及所有人的重要性。
潜在的不准确性、偏见与剽窃
Daniel Acuña,科罗拉多大学博尔德分校计算机科学副教授
我是GitHub Copilot的常规用户,它是一款帮助人们编写计算机代码的工具,我也花费了无数个小时使用ChatGPT及类似的人工智能文本生成工具。根据我的经验,这些工具擅长探索我此前从未思考过的想法。
我对这些模型将我的指令转化为连贯文本或代码的能力印象深刻。它们有助于发现改善我思路流畅性的新方法,或借助我此前不知道存在的软件包来创建解决方案。一旦我看到这些工具生成的内容,便能评估其质量并进行大幅编辑。总体而言,我认为它们提高了创造性的标准。
但我有若干保留意见。
其中一类问题是其不准确性——无论大小。使用Copilot和ChatGPT时,我会不断检查想法是否过于肤浅——例如,文本缺乏实质内容或代码效率低下,或输出显然有误,比如类比或结论错误,或代码无法运行。如果用户对这些工具的产出缺乏批判性思考,这些工具就可能具有潜在危害。
近期,Meta关闭了其Galactica大型语言模型(用于科学文本)因为它编造了“事实”,但听起来却非常自信。人们担心它可能会用听起来很有把握的谬误污染互联网。
另一个问题是偏见。语言模型可能会从数据中的偏见中学习,并加以复制。这些偏见在文本生成中难以察觉,但在图像生成模型中则非常明显。ChatGPT的开发者OpenAI的研究人员对模型将作出的回应相对谨慎,但用户经常会找到绕过这些防护措施的方法。
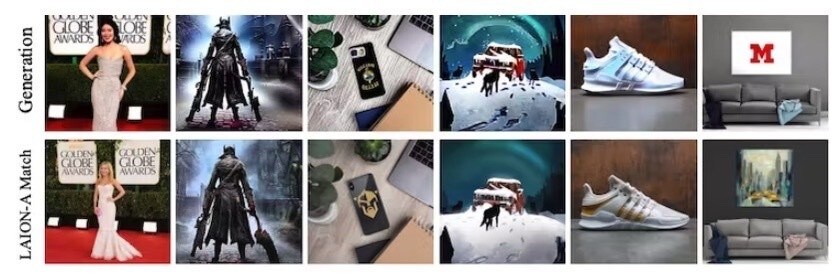
另一个问题是剽窃。近期研究表明,图像生成工具经常剽窃他人的作品。那么,ChatGPT是否也会如此?我认为我们目前并不清楚。该工具可能是在对其训练数据进行改写——这是一种高级形式的剽窃。我实验室的研究表明,文本剽窃检测工具在检测改写内容方面远远落后。
鉴于其潜力,这些工具仍处于起步阶段。目前,我认为其现有局限是可以解决的。例如,工具可以将生成的文本与知识库进行事实核查,采用更新的方法来检测并消除偏见从大型语言模型中去除偏见,并通过更先进的剽窃检测工具对结果进行检查。
人类已被超越,小众及“手工制作”的工作将依然存在
Kentaro Toyama,密歇根大学社区信息学教授
我们人类热衷于相信自身的独特性,但科学与技术一再证明这一信念是错误的。人们曾经认为,人类是唯一使用工具、组建团队或传播文化的动物,但科学已经表明,其他动物也能做到其中的每一项这些 事情。
与此同时,技术也逐一打破了认知任务必须依赖人类大脑这一说法。第一台加法器是于1623年发明的。就在过去一年,一件计算机生成的作品赢得了一项艺术比赛。我认为奇点——即计算机达到并超越人类智能的时刻——已近在眼前。
当机器变得比最聪明的人更聪明、更具创造力时,人类的智慧与创造力将如何被重视?很可能会存在一个连续谱。在某些领域,即使计算机可以做得更好,人们仍然看重由人类亲自完成的事情。自IBM的深蓝击败了世界冠军加里·卡斯帕罗夫,但人类国际象棋——尽管充满戏剧性——依然存在。
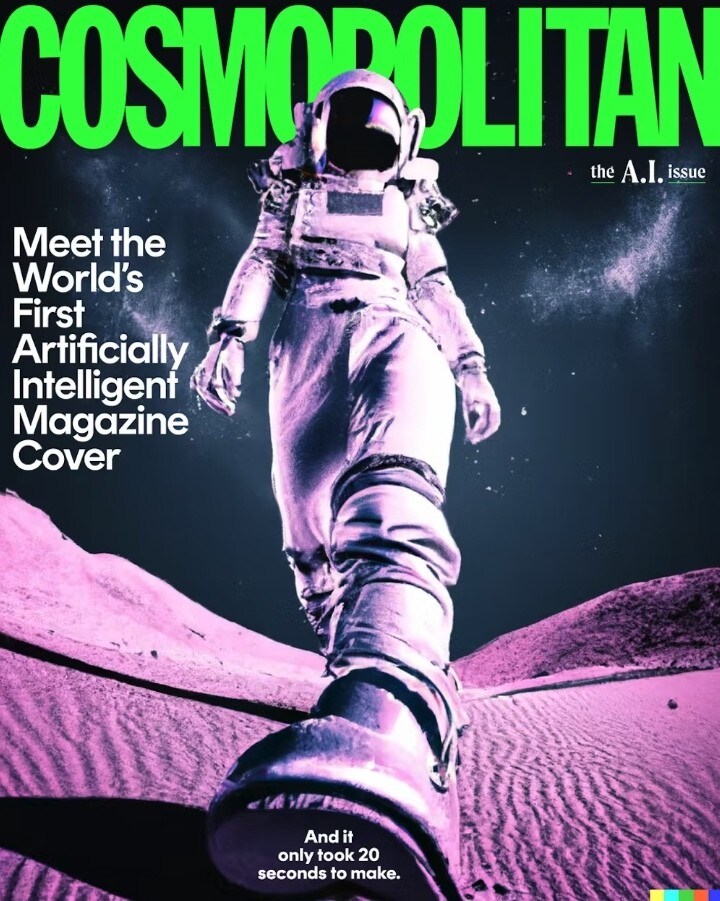
在其他领域,人类技能将显得成本高昂且多余。以插图为例。大多数情况下,读者并不在意杂志文章所配的图形是由人还是由计算机绘制的——他们只希望它切题、新颖,或许还有趣味。如果计算机能画得很好,读者在乎的是署名写的是Mary Chen还是System X吗?插画师会,但读者甚至可能察觉不到。
当然,这个问题并非非黑即白。许多领域将成为混合形态,其中一些智人(Homo sapiens)能找到幸运的小众空间,但大部分工作由计算机完成。以制造业为例——如今其中大部分由机器人完成,但仍有人监督机器,且手工制品仍有市场。
如果历史可以作为借鉴,那么人工智能的进步几乎必然会导致更多工作消失,只依赖人类独有技能的创意类人才会变得更富有但人数更少,而拥有创意技术的人将成为新的超级富豪。如果说有一线希望,那可能是当更多人失去体面的生计时,人们或许会凝聚起政治意志,以遏制失控的不平等。
旧工作将消失,新工作将涌现
Mark Finlayson,佛罗里达国际大学计算机科学副教授
大型语言模型是复杂的序列补全机器:给它一串词语(“我想吃一个……”),它会返回可能的补全内容(“……苹果。”)。像ChatGPT这样经过数以万亿计词语(记录级数量)训练的大型语言模型,其补全内容之逼真、丰富、灵活且对语境敏感,令许多人(包括不少人工智能研究人员)感到惊讶。
与任何能够自动化某项技能的强大新技术一样——在此即指生成连贯但有些泛泛的文本——它将影响在市场上提供这一技能的人。要设想可能发生的情况,回顾文字处理程序的引入所带来的影响会很有帮助。20世纪80年代初,诸如打字员等工作几乎完全消失。但从积极的一面看,任何拥有个人电脑的人都能轻松制作排版精美的文档,从而大幅提升了生产力。
此外,一些此前无法想象的新工作和技能也随之出现,例如常被列入简历中的MS Office技能。而高端文档制作市场依然存在,并变得更加强大、精细和专业化。
我认为大型语言模型很可能也会出现同样的模式:你将不再需要请他人起草连贯但泛泛的文本。另一方面,大型语言模型将催生新的工作方式,也会带来新的、尚未被想象的工作。
要理解这一点,不妨考虑大型语言模型存在的三个不足之处。首先,要编写一个能获得期望输出的提示,可能需要相当多的(人类)巧思。提示的细微改动,可能导致输出的重大变化。
其次,大型语言模型可能在毫无预警的情况下生成不当或荒谬的输出。
第三,据人工智能研究人员所知,大型语言模型并不具备抽象、通用的理解能力,无法判断什么是真假、什么是对错,也无法掌握什么是常识。值得注意的是,它们连相对简单的数学运算都无法完成。这意味着它们的输出可能会出乎意料地具有误导性、带有偏见、逻辑错误,或者干脆就是错误的。
这些缺陷为创意和知识工作者带来了机遇。就大部分内容创作而言,即便面向普通受众,人们仍需依靠人类创意与知识工作者的判断力,去提示、引导、整理、策划、编辑,尤其是对机器输出进行补充完善。许多类型的专业化及高度技术性语言,在可预见的未来仍将超出机器的能力范围。此外,还将出现新型工作——例如,有人将专门针对特定市场,对企业内部的大型语言模型进行微调,以生成某些专业文本,从而开拓业务。
总而言之,尽管大型语言模型无疑将给创意和知识工作者带来颠覆,但对于愿意适应并融入这些强大新工具的人来说,仍有许多宝贵机遇正在到来。
技术飞跃带来新技能
Casey Greene,科罗拉多大学安舒茨医学院生物医学信息学教授
技术改变了工作的性质,知识工作也不例外。过去二十年间,生物学与医学经历了由以下因素推动的变革:分子表征技术的快速发展,例如快速且低成本的DNA测序,以及医学数字化,包括应用程序、远程医疗和数据分析。
某些技术步伐感觉比其他的更大。在万维网诞生之初,雅虎曾部署人工编辑来为新兴内容建立索引。随后,利用网页链接模式中嵌入的信息来对结果进行优先排序的算法出现,从根本上改变了搜索格局,并改变了今天人们获取信息的方式。
随着OpenAI的ChatGPT的发布表明又一次飞跃。ChatGPT将一个为聊天而调优的、最先进的大型语言模型封装到一个高度易用的界面中。它将人工智能十年来的快速进步直接呈现在人们指尖。该工具能够撰写像样的求职信,并指导用户如何应对用户所选语言风格中的常见问题。
正如寻找互联网信息的技能随着谷歌的出现而改变一样,从语言模型中获得最佳输出的技能,将主要集中在创建能够产生理想输出的提示词及提示模板上。
就求职信的示例而言,可以使用多种提示词。“为某个工作撰写求职信”生成的内容会比“为数据录入专员职位撰写求职信”更加笼统。用户还可以通过粘贴部分职位描述、简历和具体要求(例如“突出对细节的关注”)来设计更具针对性的提示词。
与许多技术进步一样,在人工智能模型广泛普及的时代,人们与世界互动的方式也将发生变化。问题在于,社会会利用这一契机推动平等,还是加剧差距。




