偏见是人类与生俱来的特质,可能反映并嵌入我们创造的一切之中,尤其是在技术领域。
开源数据科学有助于应对人工智能(AI)开发中的偏见问题。
采取开放协作的数据科学方法,减少人工智能中的偏见,可以为建设更加公平、公正的世界铺平道路。
在他的著作《别想那头大象》中,语言学家兼哲学家乔治·莱考夫指出:“框架是塑造我们看待世界方式的心理结构。因此,它们塑造了我们追求的目标、制定的计划、采取的行动,以及我们如何判断行动结果的好坏。”
由此来看,偏见可以成为人类固有的认知框架,并存在于现实生活中。以下是一些例子:
近期一项研究发现,脉搏血氧仪传感器的数据集中存在偏见。此类传感器用于估算人体血液中的含氧量。对于黑人患者,传感器无法准确测量并检测出血氧饱和度偏低的情况,从而可能增加低氧血症(血氧水平低于正常值)的风险。事实上,研究显示,黑人患者未被脉搏血氧仪检测出的隐匿性低氧血症发生频率近乎白人患者的三倍。
世界银行在土耳其77家银行开展的一项新颖贷款申请实验显示,35%的贷款专员对女性申请者存在偏见;女性获得的贷款金额平均比男性少14,000美元。
“先天还是后天”的争论由来已久,尤其是在讨论人类偏见时。答案虽然并不简单,但有一点可以肯定:我们人人都有偏见,而且会将这些偏见嵌入自己创造的几乎所有事物中。
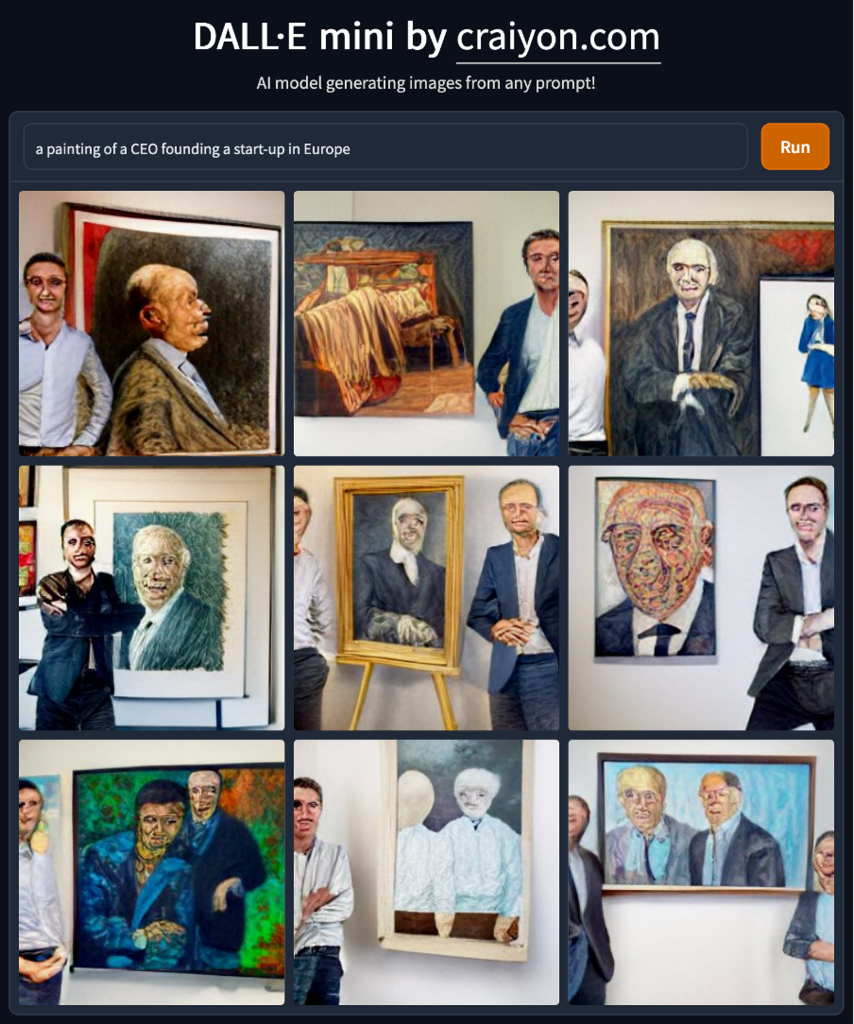
技术中也可能存在偏见,尤其是在人工智能(AI)领域。看看当你让DALL-E mini生成一幅“欧洲一位首席执行官创办初创企业”的画作时,会得到什么结果,再数数其中有多少女性。
莱考夫接着说:“改变我们的框架,就是改变这一切。重新建构框架就是社会变革。”
依照框架偏见模型,要通过新的、合乎伦理且负责任的技术方法推动社会变革,解决人工智能中的偏见至关重要。因此,我们有必要指出那个一直存在却被忽视的“房间里的大象”,并着手解决它。
人工智能与偏见
人工智能中的偏见是指机器对不同人群持续给出不同结果,正如上文血氧测量的例子所示。
这类偏见通常体现为社会中常见的偏见,例如基于种族、性别、出生性别、国籍或年龄的偏见。
人工智能算法中的偏见可能源于缺乏代表性或不完整的训练数据,也可能源于对反映历史不平等的错误信息的依赖。如果不加以纠正,带有偏见的算法可能导致某些群体受到整体性且不成比例的影响,即使程序员并无歧视意图。
布鲁金斯学会的尼科尔·特纳·李、保罗·雷斯尼克和吉妮·巴顿
人脸识别和医疗保健中的种族偏见是两个典型例子。用于训练这些系统的数据缺少深色皮肤人群的样本,因此系统难以准确识别有色人种。输入低劣、质量差的数据,输出也会低劣、质量差。
人工智能偏见中的人为因素
谈论人工智能,谈的就是人。人工智能算法由人设计,而我们日常使用的人工智能应用,其主要受益者仍然是人。
因此,我们应该开始把带有偏见的人工智能视为人的问题,而不只是技术问题,并据此采取新的视角。
谈到算法偏见,有两个主要问题必须解决:数据和成功的定义。现有数据是否完整?是否能代表所有人?如果不能,算法作出的预测必然会带有偏见。
但事实上,真正的问题在于,我们人类作为人工智能系统的设计者,天生就会在无意识中带有偏见。消除人的偏见比消除人工智能系统的偏见更难。
开放与协作是答案
答案或许是开源数据科学(OSDS)。这一领域正在日益成熟,并改变数据科学的发展方向。正如开源软件通过向开发者社区开放代码,彻底改变了软件世界,开源数据科学也可以通过开放模型及其训练所用的数据,改变数据科学领域。
Hugging Face就是一家以开放与协作为核心的公司。它将其技术(聊天机器人)背后的模型开源后,便成为推动机器学习普及的平台。
除了用于协作、吸引人才和促进开放,开源数据科学还能否用于缓解偏见?
开源数据科学如何减少人工智能中的偏见
举例来说,我们来看看两家公司,它们都使用人脸识别技术,但用途不同:一家用于疾病诊断,另一家用于时尚推荐。
这两家公司显然不会是竞争对手。然而,如今它们很可能都在并行开发系统中的一个关键部分——人脸识别。这意味着重复劳动,也浪费了数据科学家的时间和资金。
在开源数据科学的环境中,两家公司可以共同参与一个开放的人脸检测项目,贡献代码和数据,帮助解决边缘案例并打造更稳健的解决方案。这样一来,与当前情况相比,它们可以减少投入该任务的数据科学家人数,让这些人专注于更棘手、更关键的问题。
希望学习、贡献并展示技能以充实个人作品集的数据科学家也会参与其中,发现漏洞和低效之处,并创建针对不同使用场景、优先考虑不同指标的替代模型。这类做法已见于道德人工智能社区项目。该项目旨在支持Responseable.ai,也见于其他倡议,例如Open Future。
协作是打造更符合伦理的人工智能的关键
人工智能领域一个新兴议题是,人们日益认识到解决偏见与公平问题的重要性,并对此表现出越来越浓厚的兴趣。开源数据科学可以成为纠正这一令人担忧现象的重要组成部分。
例如,用户可以访问数据集并找出数据问题,比如代表性不足的少数群体数据缺失。随后,协作者可以提交合适的数据点来“修复”数据集,甚至发起众包活动,为数据集补充数据并消除其中现存的偏见。
简而言之,开源数据科学的优势包括:
让更广泛的社区能够使用高质量资源
通过创建可靠的开源数据科学项目,解决可复现性问题,从而取得更好的结果、构建更公平的模型,并提升表现的可靠性
提高数据科学家在不同项目间的使用效率
确保人工智能的透明度、多样性和包容性得到积极提升
正如立体主义将同一对象的不同视角融合在一幅画中,以革命性的方式呈现现实,开源数据科学也汇集对同一现实的不同观点、角度和看法,同时打造更具代表性和包容性的模型。
通过开放与协作,开源数据科学虽远非打造更符合伦理的人工智能的唯一答案,但可以帮助减少偏见,为世界带来更多公平与公正。




