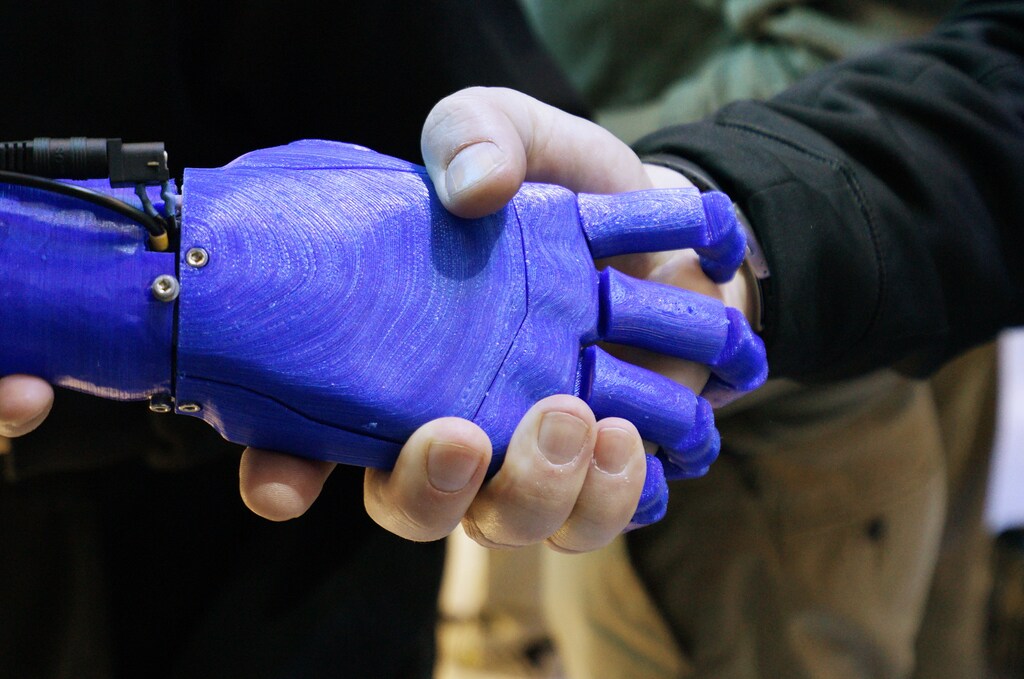
加拿大作家玛格丽特·阿特伍德在其小说《盲刺客》中写道:“”她说,“触觉先于视觉,先于言语。它是第一种语言,也是最后一种,而且它始终说真话。”
虽然触觉让我们能够感知物理世界,但我们的眼睛能够即时帮助我们理解这些触觉信号所构成的完整图景。
经过编程以用于视觉或触觉的机器人,无法像这样自由互换地使用这些信号。为了更好地弥合这一感官鸿沟,麻省理工学院计算机科学与人工智能实验室(CSAIL)的研究人员开发出一种预测性人工智能(AI),它能够通过触碰学会看,并通过观看学会感知。
该团队的系统能够根据视觉输入生成逼真的触觉信号,并直接根据这些触觉输入预测被触碰的物体及其具体部位。他们使用了一台库卡机器人手臂,并搭载了一种名为“GelSight”的特殊触觉传感器,该传感器由麻省理工学院的另一个团队设计。GelSight,由麻省理工学院的另一个团队设计。
研究团队使用一台普通网络摄像头,记录了近200件物品(包括工具、家居用品、织物等)被触碰超过12,000次的过程。研究团队将这12,000个视频片段拆分为静态帧,编制出“VisGel”数据集,其中包含超过300万张视觉与触觉配对的图像。
“通过观察场景,我们的模型能够想象触碰平面或锐利边缘时的感受”,CSAIL博士生、该系统新论文的第一作者李云珠说道。“通过盲目地四处触摸,我们的模型能够仅凭触觉感受预测与环境的互动。将这两种感官结合起来,可以增强机器人的能力,并减少涉及操控和抓取物体的任务所需的数据量。”
近期为机器人配备更接近人类的物理感官的研究,例如麻省理工学院2016年利用深度学习以视觉方式呈现声音,的项目,或是预测物体对物理力的反应的模型,两者都依赖大型数据集,而这些数据集并不适用于理解视觉与触觉之间的互动。
该团队的技术通过使用VisGel数据集和一种称为生成对抗网络(GAN)的方法,绕过了这一限制。
GAN利用视觉或触觉图像,生成另一种模态的图像。其工作方式是通过“生成器”与“判别器”相互竞争:生成器旨在制造看起来真实的图像,以骗过判别器。每当判别器“识别出”生成器的作品时,它都必须说明作出该判断的内部推理过程,从而使生成器能够不断自我改进。
从视觉到触觉
人类仅通过观看就能推断出物体的触感。为了让机器更好地具备这一能力,该系统首先需要定位触碰的位置,然后推断该区域的形状和质感信息。
参考图像(不涉及任何机器人与物体的互动)帮助系统编码有关物体和环境的细节。随后,当机器人手臂运行时,模型只需将当前帧与其参考图像进行比较,即可轻松识别触碰的位置和范围。
这可能类似于向系统输入一张电脑鼠标的图像,然后“看到”模型预测的、拿取该物体时应触碰的区域,这将极大地帮助机器规划更安全、更高效的动作。
从触觉到视觉
在从触觉到视觉的转换中,目标是让模型基于触觉数据生成视觉图像。模型先分析触觉图像,然后推断接触位置的形状和材质,再回溯参考图像,以“想象”这一互动过程。
例如,在测试期间,若向模型输入一只鞋子的触觉数据,它便能生成该鞋子最有可能被触碰的位置图像。
这种能力可能有助于在缺乏视觉数据的情况下完成任务,例如灯光熄灭时,或者有人在箱子或未知区域中盲目伸手的情形。
展望未来
目前的数据集仅包含受控环境中的互动示例。研究团队希望通过在更非结构化的环境中收集数据,或使用麻省理工学院新设计的触觉手套,来改进这一状况,从而更好地扩大数据集的规模并提升其多样性。
在模式切换过程中,仍有一些细节难以推断,例如仅通过触摸判断物体的颜色,或在不实际按压的情况下判断沙发的软硬程度。研究人员表示,通过构建更稳健的不确定性模型以扩展可能结果的分布范围,可以改善这一问题。
未来,此类模型有助于实现视觉与机器人技术之间更加和谐的关系,尤其在物体识别、抓取、更好的场景理解,以及在辅助或制造环境中促进人与机器人的无缝融合等方面。
“这是首个能够令人信服地实现视觉与触觉信号相互转换的方法”,加州大学伯克利分校博士后研究员安德鲁·欧文斯说道。“此类方法在机器人领域具有很大的应用潜力,因为机器人需要回答诸如‘这个物体是硬还是软?’或‘如果我抓着杯柄提起这个杯子,我的握持效果会如何?’之类的问题。这是一个极具挑战性的问题,因为两种信号差异极大,而该模型已展现出出色的能力。”
李云珠与麻省理工学院教授Russ Tedrake和Antonio Torralba以及麻省理工学院博士后朱俊彦共同撰写了这篇论文。该论文将于下周在美国加利福尼亚州长滩举行的计算机视觉与模式识别大会上发表。




