自虚拟国际象棋和纸牌游戏问世之初,电子游戏就一直是开发人工智能(AI)的竞技场。每一次机器战胜人类,都推动了算法变得更加智能和高效。但要解决现实世界的问题——例如实现驾驶和谈判等复杂任务的自动化——这些算法必须应对比棋类游戏更为复杂的环境,并学会团队合作。教会AI如何与其他玩家协作并互动以取得成功,此前一直被视为难以逾越的任务——直到现在。
在一项新研究中,研究人员详细介绍了一种训练AI算法的方法,使其能够在一款热门的3D多人游戏中达到人类水平的表现——该游戏是《雷神之锤III竞技场》(Quake III Arena)的改良版,采用夺旗模式。
尽管这款游戏的任务十分简单——两支对立队伍通过穿越地图来争夺对方的旗帜——但要取胜则需要复杂的决策能力,以及预测并应对其他玩家行动的能力。
这是AI首次在第一人称视角电子游戏中展现出类人的技能。那么,研究人员是如何做到的呢?
机器人的学习曲线
2019年,AI研究在其他多人策略游戏中取得了若干里程碑式的成就。五个“机器人”——由AI控制的玩家——在一场《DOTA 2》比赛中击败了一支职业电子竞技战队。职业人类玩家也同样败给了一个AI,在一场《星际争霸II》比赛中落败。在所有这些案例中,都应用了一种强化学习,即算法通过反复试错并与环境互动来学习。
在《DOTA 2》中击败人类的五个机器人并未从人类玩家身上学习——它们完全是通过与自身的克隆体对战进行训练的。使其能够击败职业玩家的进步,来自于对现有算法进行规模化扩展。得益于计算机的运算速度,AI能够在几秒钟内完成一局人类需要数分钟甚至数小时才能完成的游戏。这使研究人员能够在十个月的现实时间内,让其AI积累相当于45,000年的游戏时长。
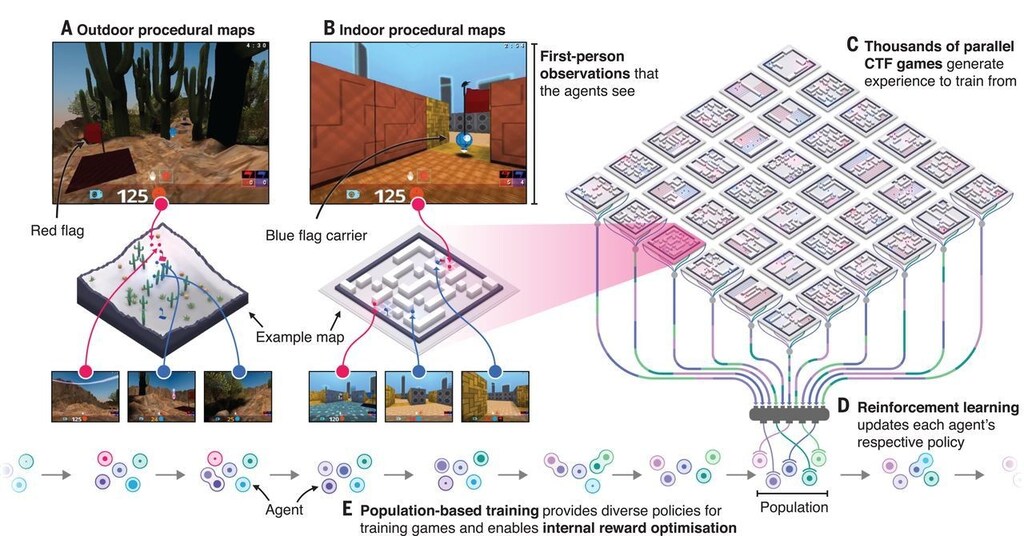
近期研究中的夺旗机器人同样是从零开始学习的。但与其和完全相同的克隆体对战不同,研究人员创建了一组由30个机器人组成的群体,并使其并行训练,同时创建并训练,每个机器人都拥有各自的内部奖励信号。该群体中的每个机器人随后会共同参与游戏,并相互学习。正如参与研究的科学家之一David Silver所指出的,AI正开始“摆脱人类知识的束缚……并自主创造知识”。
人类的学习速度仍然远慢于最先进的深度强化学习算法。OpenAI的机器人与DeepMind的AlphaStar(即参与《星际争霸II》的机器人)都在达到人类水平的表现之前,消耗了相当于数千年的游戏时长。此类训练的成本估计高达数百万美元。尽管如此,一个能够在人类擅长的游戏中击败人类的自学型AI,仍是一项令人振奋的突破,它可能会改变我们看待机器的方式。
人类与机器的未来
人们通常将AI描绘为取代或补充人类能力,但很少将其视为能够执行与人类相同任务的完整团队成员。由于这些电子游戏实验涉及人机协作,它们让我们得以一窥未来的图景。
夺旗游戏的人类玩家认为,这些机器人比其他人类玩家更具协作性,但《DOTA 2》玩家对其AI队友的反应则褒贬不一。一些人非常热情,表示他们感到得到了支持,并且在与其并肩作战的过程中有所收获。Sheever是一名职业《DOTA 2》选手,她讲述了与机器人组队的体验:
其实感觉挺好的;【AI队友】在某个时刻为我牺牲了自己。他试图帮助我,心想“我相信她知道自己在做什么”,而我显然并没有。但是,你知道吗,他相信我。我和【人类】队友在一起时很少有这样的体验。
其他人的反应则较为冷淡,但由于沟通是任何关系的支柱,改善人机沟通在未来将至关重要。研究人员已经对部分功能进行了调整,使机器人更加“人性化”,例如让机器人在赛前的队伍选角环节中刻意等待片刻后再选择角色,以避免给人类玩家施加压力。
但AI应该向我们学习,还是继续自我教学?在不模仿人类的情况下进行自我学习,或许能让AI变得更加高效和更具创造力,但这也可能催生出更适用于无需人类协作的任务的算法,例如仓储机器人。
另一方面,有人可能会认为,由人类训练出的机器会更加直观——使用此类AI的人类能够理解机器为何会做出某种行为。随着AI变得越来越智能,我们所有人都将迎来更多惊喜。




