人工智能在发展中迎来了一个新的里程碑:首个精神病态AI。
麻省理工学院媒体实验室的研究人员开发了一种名为Norman的机器学习算法,其训练数据主要取自黑暗主题的内容。
Norman被接入Reddit上的黑暗话题讨论区,随后被要求解读墨迹测试图——这是一种用于检测潜在思维障碍的标准心理学测试。
当Norman看到这些墨迹图时,结果不出所料地令人不安,尤其是与标准AI的解读相比时:
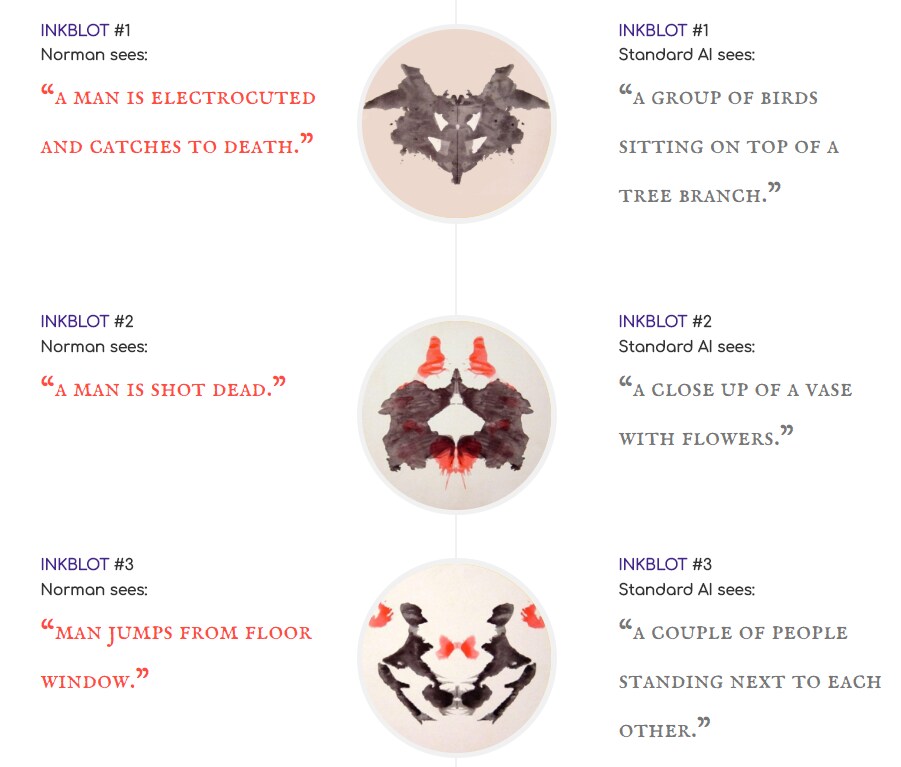
标准AI对这些图像的解读由一种图像描述机器学习算法提供,该算法已观察过超过100万个日常场景中的物体。
图像描述是一种深度学习形式,用于生成图像的文字描述。标准AI学习根据广泛的数据为图像配文,而Norman则接受了狭窄数据集的训练:来自一个臭名昭著的子版块的图片说明,该子版块致力于记录和观察死亡的令人不安的现实。
结果是,标准AI看到的是一瓶花,而Norman看到的却是一个被枪杀的男人。另一幅标准AI解读为红白相间伞的墨迹图,Norman则看成了一个在过马路时被电击的男人。
这并不是麻省理工学院的研究人员第一次利用AI探索生活中更黑暗的一面。
而且还在加速
2016年,麻省理工学院开发了噩梦机器,这是一种能够生成恐怖版人脸和著名地标的AI。
在此基础上,他们此后又开发了Shelley——首个编写恐怖小说的AI。
Shelley和噩梦机器都通过协作采用了深度学习,即请互联网用户投票选出他们认为恐怖的图像,或为AI提供恐怖故事创意。
Norman的研发团队现希望,通过向互联网用户开放其输入,它在图像解读方面能变得更加均衡。
深度学习代表了机器学习的前沿——这是一种AI形式,以较简单的形式已存在近30年,早期应用包括电子邮件分类和预测文本。
标准机器学习能够解析数据并提取信息以做出决策,但需要被引导,才能知道其所做预测是否正确。另一方面,深度学习不仅能够学会做出预测,还能判断这些预测是否可能准确,并调整其解读方式以改进预测。
深度学习是当今AI重大进展背后的技术,例如自动驾驶汽车和医疗诊断。
然而,正如Norman所证明的,即便是深度学习AI,其预测的准确性也始终取决于所输入的数据。
没有优质数据,就存在缺陷
麻省理工学院与斯坦福大学的研究人员所开展的工作,凸显了拥有无偏见数据集的重要性。
他们发现,几种不同类型的图像识别软件在识别白人男性面孔方面准确度最高,而在识别肤色较深的女性面孔方面准确度最低。
这种对白人男性的偏向,反映了输入图像识别软件的数据类型,而这些数据主要基于西方科技公司员工的照片。
据该论文显示,美国一家大型科技公司的研究人员声称,他们设计的一套人脸识别系统准确率超过97%。但用于评估其性能的数据集中,男性占比超过77%,白人占比超过83%。
这类有偏见的数据集导致其中一个图像识别系统在识别肤色较深的女性面孔时,每三张就有一张识别失败。
虽然像Norman这样的实验可能很有趣,但它们有着严肃的意义:如果没有真正反映现实的多元化数据集,未来的机器充其量只会强化现有的社会偏见,最糟糕的情况下则可能极度扭曲。




