人工智能(AI)系统的开发往往会带有偏见,并引发严重问题。近期的例子包括,谷歌人工智能算法将一些黑人标记为大猩猩,以及不得不关闭的微软 Tay 推特机器人——它仅在运行 16 小时后就学会了种族歧视言论。
认为人工智能因依赖数学计算而客观,这是一种误解;构建人工智能系统本质上是由人主导的过程。这类系统不可避免地会包含偏见。
当人工智能表现出明显偏见时,如上述例子所示,这种偏见往往可以得到纠正。纠正偏见这一做法表明,人工智能的核心不是算法,而是操控算法的人。对于许多更微妙的偏见,纠正系统可能困难得多。
试想一个例子,它说明人工智能算法中一个看似微小的选择,如何产生截然不同的结果。一份广受欢迎、容易获取的人力资源数据集,包含 15,000 条观察记录,涉及影响员工决定从公司离职的九个因素。这些因素包括员工满意度、员工承担的项目数量以及任职年限等。这类数据有助于高管确定如何分配资源,以留住员工。
希望借助人工智能帮助实施员工留任计划的经理,可能会在两种非常流行的机器学习技术之间做出选择:逻辑回归和神经网络。逻辑回归算法根据一组具有统计相关性的变量,尝试预测某个事件是否会发生(即员工会离职还是留下);神经网络则是一种受生物学启发的方法,尝试从数据中寻找模式,以揭示变量(也称特征)之间的重要关系。将两种算法应用于这份人力资源数据集时,它们的预测准确率同为 94%,这意味着在性能方面两者没有优劣之分。
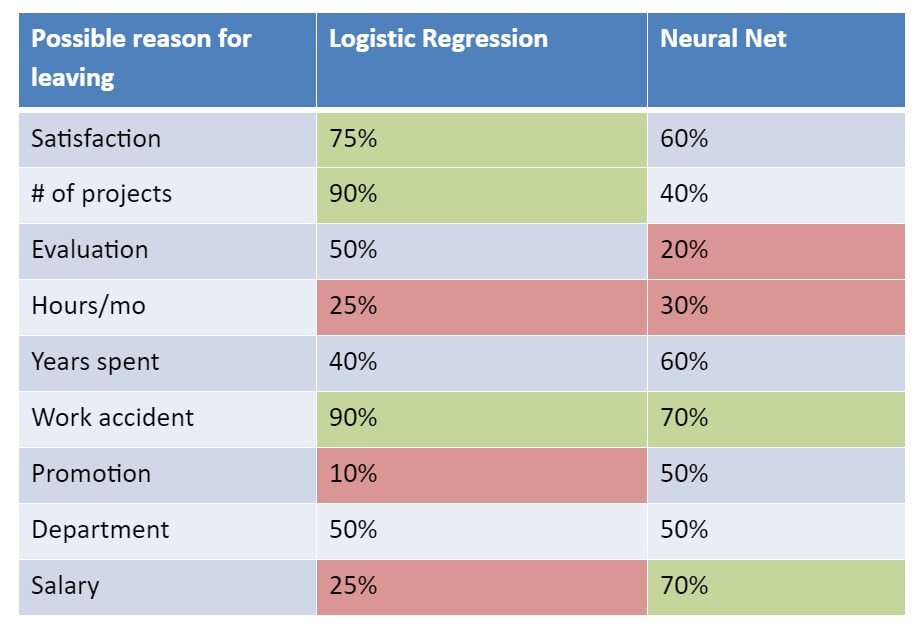
然而,如下表所示,两者为经理指向了截然不同的行动方案。表中的绿色单元格显示员工离职背后可能性最高的因素,红色单元格则显示可能性最低的因素;各项百分比表示相应原因出现的可能性。
从逻辑回归的结果来看,经理可能会认为,可以通过关注员工承担的项目数量,以及他们是否遭遇过工伤事故,来提高员工留任率。但从神经网络的结果来看,薪酬成了主要因素,尽管逻辑回归显示薪酬几乎不可能影响员工留任。
那么,经理应该相信哪种模型?公司应投资于提高工作满意度、减少项目数量并降低工伤事故吗?还是提高薪酬并减少工伤事故才是最佳做法?在这个案例中显然可以看出,算法的选择(请记住,从统计角度看,两者同样正确)会对公司如何投入资源产生重大影响。
选择算法的方式和理由通常有充分依据,但这类选择往往也可能源于熟悉程度,例如个人在大学里学过什么(无论如何都谈不上标准化),或老板希望员工使用什么算法(因为这往往是老板最熟悉的)。针对不同类型的数据分析,制定有原则、有记录的方法,了解这些方法的优势与局限,并以标准化方式培训员工如何应用,将大大有助于企业开展这类工作。然而,对于难以招聘到足够合格人才的企业而言,建立新的人工智能部门和流程可能是一项艰巨任务。
在适当条件下,人工智能可以展现惊人的能力。给定大量数据,人工智能算法可以揭示人类无法识别的关系,例如医学扫描中的肿瘤;也可以比人类更快地识别某些关系,例如汽车即将发生碰撞。但人工智能也可能极其脆弱:一旦超出由创建系统的人所界定和调整的相对狭窄的适用条件,它就可能彻底失灵。此外,在语音识别等人工智能应用中,我们可以高度确定结果是否正确;但对于试图估计人类决策的人工智能应用,却不能这么说。
算法由工程师和计算机科学家创建,他们决定如何初始化各种统计参数;这些参数可能带有一定随意性,之后他们会针对特定数据集对其进行调优或调整,以达到预期结果。在某些情况下,人们会为不同案例指定标签,以提高算法的整体预测准确率。这些往往带有主观性的参数,可能导致人工智能算法脆弱,使其在未预见的条件下失灵。谷歌自动驾驶汽车最近发生的事故就是一例:汽车撞上了一辆公交车,因为它不懂得如何有效地汇入车流。
人工智能偏见的一个常被忽视的来源,是人类对算法结果的解读。这些复杂的人工智能算法会生成一组概率和数字簇,仿佛《黑客帝国》电影中那串著名的数字流。精通统计推理的人类专家必须为这些数字赋予具体语境中的含义,再据此指导其他人或计算机如何解读结果。这类指导通常以嵌入式算法的形式呈现。由于这种相互依赖关系,要还原人工智能系统为何以特定方式运行往往十分困难,而这会掩盖此前由人工解读环节引入的偏见。要解释结果以及解空间可能存在的局限,也非常困难。
研究人员开始认识到这些困难,一个名为可解释人工智能的新领域正在兴起。研究人员认识到,他们所依赖的大多数算法和概率推理都很难理解,因此正尝试确定如何设计或呈现人工智能算法的推理过程,以便更容易理解因果关系。
各行业可以通过为可解释人工智能制定新要求,助力这一新兴领域发展;这反过来会为工程师和计算机科学家提供必要的动力,使他们重视完整的人工智能系统(人类决策者 + 算法),而不是竞相设计只有自己才看得懂的巧妙新算法。随着人工智能越来越多地应用于医疗设备、汽车、飞机和火车等安全关键领域,以及金融交易乃至智能家居,我们必须找到一种方式,说明人工智能系统可能在何时何地失效,从而开发出有韧性的系统,而不是脆弱的系统。




