一则让世界各地恶作剧者纷纷关注的消息是,如今已有一款计算机程序,能够制作出某人说话的逼真模拟视频。
华盛顿大学的研究人员通过制作一段唇形同步视频,证明了这一点。视频中的美国前总统巴拉克·奥巴马由现有音频和影像合成而成。
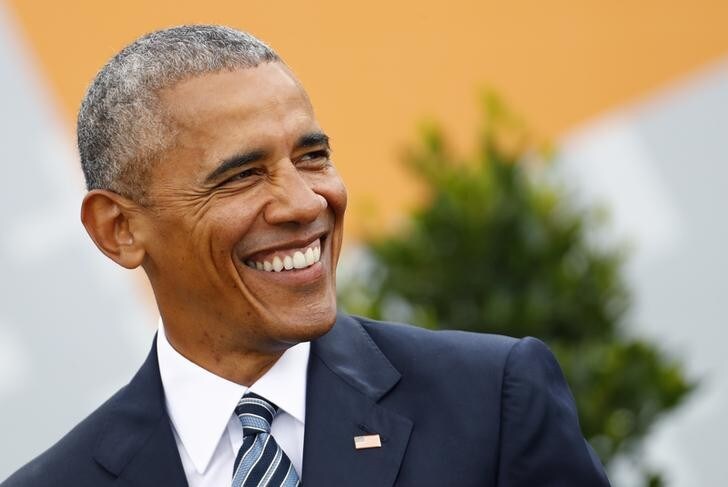
Image: 路透社/法布里齐奥·本施
该程序利用人工智能(AI),将人物说话的音频与逼真的嘴形相匹配,再将嘴形合成到现有视频中。程序分析库存影像中的数百万帧画面,研究嘴形和声音模式后,便能生成高度逼真的模拟视频。
在电影行业以假乱真
研究人员表示,这项技术有望用于特效制作。目前,音频转视频的流程需要拍摄许多人说同一句话,再尝试找出声音与嘴形之间的对应关系。这个过程既乏味又耗时,还会造成所谓的“恐怖谷”问题:视频看起来相当逼真,却又不够逼真,因此非但无法令人信服,反而往往显得诡异。
这项技术还可以改善低画质视频通话的体验,也有望用于听障人士,让他们通过读唇理解由电话音频合成的视频。
研究团队还估计,如果逆转这一流程——将视频而非单纯的音频输入程序——就有可能开发出一种算法,用来检测视频是真是假。
研究目标是改进算法,使其能够适应不同情境,并以更少的数据识别一个人的声音和说话模式。例如,训练数据可从目前的14小时视频缩短至1小时。
该程序目前只能根据同一个人说出的话来制作视频:你还不能把自己的话放进别人的嘴里。




