OpenAI的最新研究将机器学习智能体置于一个简单的捉迷藏游戏中,它们为了达成“看见或被看见”的目标,展开了一场智力竞赛,以出人意料的方式使用物体。这类自学型AI在现实世界中同样可能发挥作用。
该研究旨在探究机器学习智能体能否在研究人员不加任何提示干预的情况下,学会复杂且与现实相关的技术,并且确实取得了成功。
识别照片中的物体或生成逼真的人脸等任务既困难又有用,但它们并不能真正反映人在现实世界中可能采取的行动。可以说,这些任务高度依赖智力,因此无需离开计算机,也能达到很高的效能。
然而,训练AI操控机械臂抓起杯子并将其放入碟子,远比人们想象的困难(且仅在非常特定的条件下才得以实现);现实物理世界的复杂性使得这类任务几乎不可能仅通过纯粹的智力、计算机内部的学习来完成。
与此同时,还存在一些介于两者之间的任务,它们不一定完全反映现实世界,但仍与现实相关。一个简单的例子是:当面对多个相关物体或人物时,机器人应如何调整朝向。你无需进行上千次实体试验,就知道它应当转动自身或摄像头,以便同时看到两者,或在两者之间切换,诸如此类。
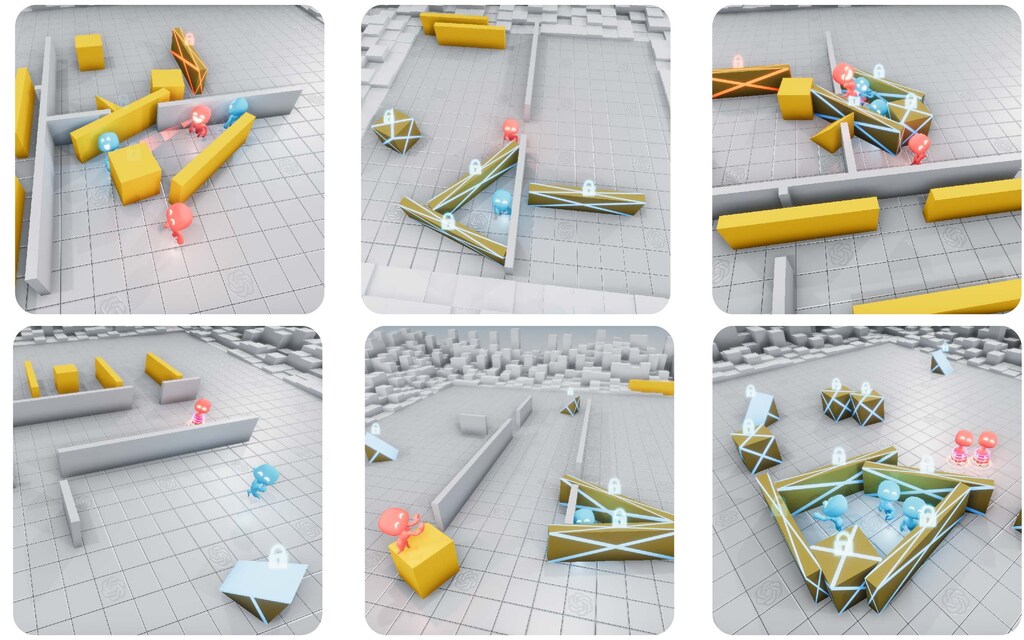
OpenAI对其初始机器学习智能体所设的捉迷藏挑战即沿此思路展开:游戏环境规则简单(称为Polyworld),但采用了接近现实世界的物理规律和输入。如果AI能够自学驾驭这一简化的现实,或许它们可以在稍作调整后,将这些技能迁移到完整的现实世界中。
无论如何,这正是该实验背后的思路,但它本身就已足够有趣。游戏让两支队伍在一个小型三维竞技场中对决,场内随机生成了若干墙体和物体。场上放置多个智能体,“躲藏者”有几秒钟时间熟悉环境并藏身。他们还可以与物体互动,推动物体或将其锁定在原地。“寻找者”抬头后,便有一定时间去发现躲藏者。
机器学习程序仅被告知基本感知能力——每个智能体都能看到周围世界,并拥有一种类似“激光雷达”的装置,用以感知附近物体的位置——以及它们可以移动物体这一事实。除此之外,无论是寻找还是躲藏,只要成功完成任务,它们便会获得一分,这便是它们的动机。
这些基本起点带来了极其有趣的结果。起初,两队几乎是随机移动。但经过数百万局游戏后,躲藏者发现,以某种方式移动——“笨拙地”逃跑——能够更频繁地获得分数。于是,一场智力竞赛由此开始。
由于躲藏者不断逃跑,寻找者开始发展出更有条理的追击策略。随后,工具出现了。
躲藏者发现,他们可以在场地上推拉物体,并开始用这些物体搭建堡垒。
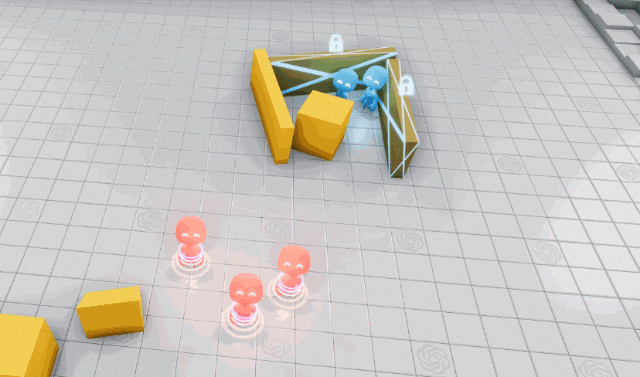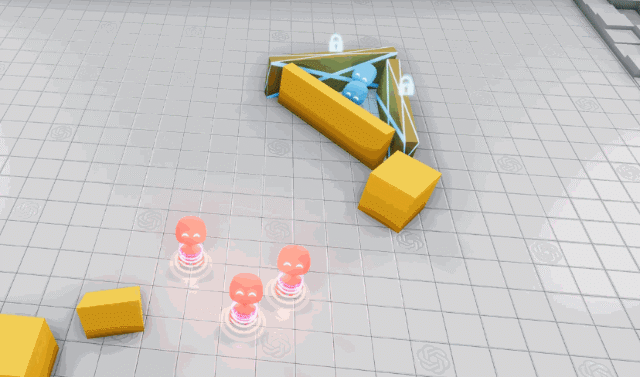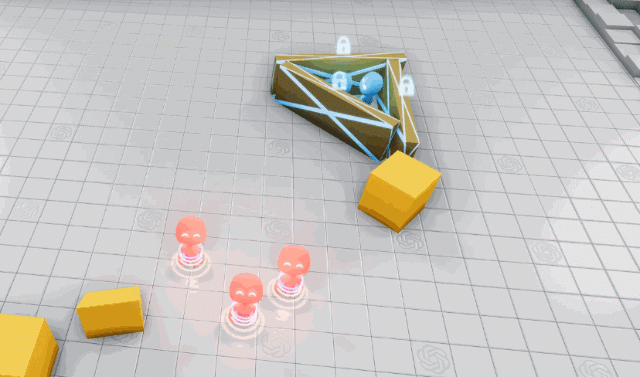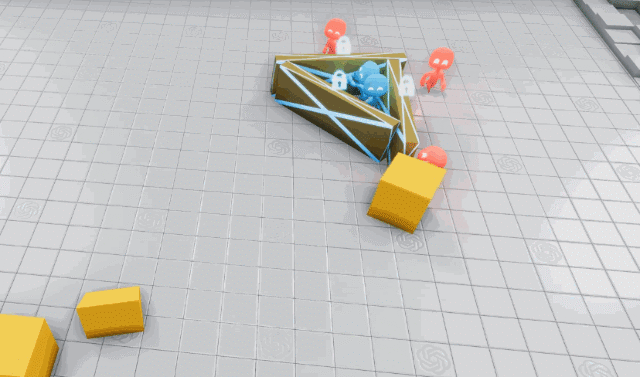
寻找者则利用场地上的斜坡越过物体,将堡垒撞毁,以此作出回应。
在寻找者仍在倒数计时时,躲藏者便开始寻找斜坡,并将其偷走或锁定在原地(被锁定的斜坡无法被对方队伍的智能体解除锁定)。有趣的是,这涉及一定程度的分工,因为通常没有足够时间让两名躲藏者都去寻找斜坡;一人必须负责搭建堡垒,另一人则去巡查斜坡。
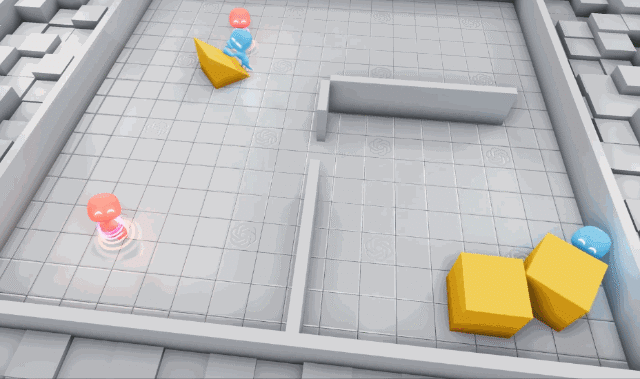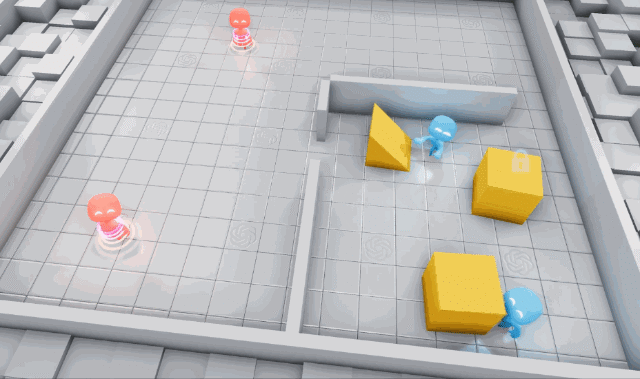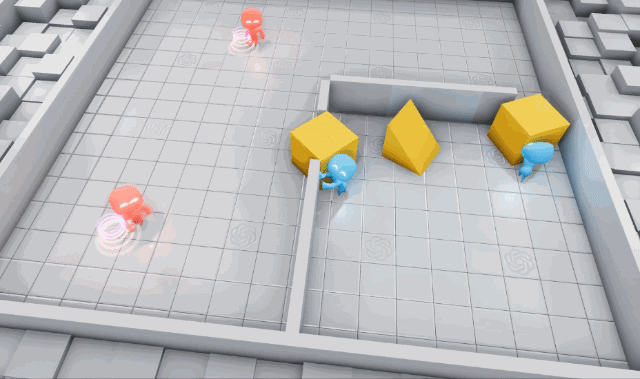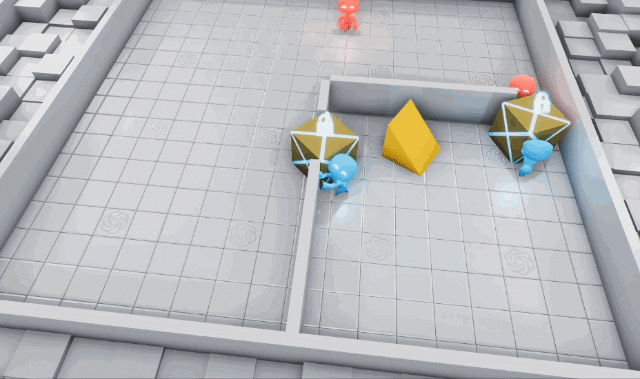
OpenAI团队原以为事情就此结束,但寻找者学会了利用游戏世界中一个非预期的特性。他们发现,自己可以骑在箱子上“推”动它,从而将箱子推到斜坡附近,爬上箱子,然后在场地上“冲浪”,找到那些狡猾的躲藏者。

当然,躲藏者也作出了回应:他们将所有未用于搭建堡垒的物体全部锁定——而在这款游戏中,策略似乎就此走到了尽头。
那么,这项研究的意义何在?正如论文作者所解释的,这大致就是我们得以形成的方式。
地球上极其丰富的复杂性与多样性,是在自然选择的引导下,生物之间通过协同进化与竞争而演化形成的。当一种新的成功策略或突变出现时,它会改变邻近智能体需要解决的隐性任务分布,并为适应性创造新的压力。这种进化上的竞赛会产生隐性的自动课程,使相互竞争的智能体不断为彼此创造新的任务。
在具有物理基础且开放式的环境中诱导自动课程,最终可能使智能体习得数量不受限制的、与人类相关的技能。
换言之,让AI模型以无监督的方式相互竞争,可能是培养有用且稳健技能的一种更好方式,远胜于任由它们独自蹒跚前行,积累诸如“已探索环境的百分比”之类的抽象数字。
随着AI能力日益复杂,人类越来越难以,甚至不可能,通过参数化设定及控制其与环境的互动,来指导AI能力的各个方面。对于机器人在拥挤环境中导航等复杂任务而言,影响因素众多,由人类设计行为或许永远无法达到日常生活中这些智能体所需的复杂程度。
但它们可以相互学习,正如我们在此处以及生成对抗网络(GAN)中所见——在GAN中,一对相互对抗的AI致力于在逼真媒体的生成或检测中击败对方。OpenAI研究人员认为,在许多其他方法过于缓慢或结构化的情况下,“多智能体自动课程”,即自我学习的智能体,是未来的发展方向。他们总结道:
“这些结果令人确信,在更加开放、多样的环境中,多智能体动态可能催生极其复杂且与人类相关的行为。”
该研究的部分内容已作为开源项目发布。你可以在此阅读描述该实验的完整论文。




