Money2020是全球规模最大的金融行业展会,每年都在拉斯维加斯威尼斯人酒店举行。最近一次聚会上,楼下赌场老虎机的喧闹声此起彼伏,加密货币初创企业在推介最新的代币发行;而在主舞台上,PayPal总裁兼首席执行官丹·舒尔曼慷慨陈词,向数千名听众谈及全球贫困劳动者,以及他们获得银行服务和信贷的需求。PayPal和许多其他公司认为,未来属于算法信用评分:支付数据和社交媒体数据与机器学习相结合,作出放贷决策;一位支持者则认为,这种方式“挑选人的本领胜过人类所能达到的水平”。
如今,中国的信贷掌握在一家名为支付宝的公司手中。它利用数千项消费者数据——包括他们购买什么、使用哪种手机、玩什么增强现实游戏,以及他们在社交媒体上的好友——来确定信用评分。在一种老年人随手掏出手机买菜、甚至无家可归者也会戴着二维码接受捐赠的文化中,可供利用的数据十分丰富。信用评分不仅能决定贷款条件,也充当衡量一个人总体品行的指标。在中国,较高的信用等级可以提升就业机会,例如,还可能帮助你获得签证前往欧洲旅行,甚至通过在线约会寻找伴侣。中国一家名为百合网(Baihe.com)的婚恋网站会为信用评分较高的用户提供更高的曝光度。
这一切都由算法支配。
例如,在中国,较高的信用等级可以提升就业机会,或帮助你获得旅行签证。据称,算法信用评分应用在预测风险方面比传统评分方法更准确;其支持者还认为,这种方法更公平,因为算法不受种族、性别和社会经济偏见的影响,而这些偏见过去曾扭曲人们获得信贷的机会。玩电子游戏、拥有一部安卓手机、在Facebook上有400位好友为何能帮助判断贷款申请是否成功,也许并不明显;但按照这种说法,金融危机过去十年后,我们需要相信数据不会说谎。
支付宝并非孤例。除了WePay等中国竞争者,还有其他公司在撒哈拉以南非洲利用机器学习作出放贷决策。其中一家名为Branch的公司,正借助肯尼亚普及的手机,从广受欢迎的移动支付平台M-Pesa获取数据,制定信用评分。当然,算法信用评分并不局限于新兴信贷市场。在德国,致力于打造“消费金融界亚马逊”的贷款服务商Kreditech,正逐渐放弃还款记录等传统指标,转而挖掘客户交出的Facebook数据中隐藏的性格线索。与此同时,美国公司ZestFinance利用大数据寻找那些评分可能始终未能从次级抵押贷款危机中恢复的客户。
算法信用评分的兴起,源于开拓全球“无银行账户人群”市场的愿望。正如舒尔曼在Money2020上的演讲所表明的,算法信用评分旨在开拓全球“无银行账户人群”市场,吸引数十亿客户;由于缺乏传统金融记录,他们迄今一直被排除在外。但算法信贷的兴起也回应了发达经济体的焦虑,尤其是金融危机之后。危机过去十年,人们隐约寄望于大数据,终于能为各地高风险的消费信贷业务提供支撑。我们是否应该相信这一承诺,仍是一个悬而未决的问题;机器学习难以解释,更让这个问题难以回答。
2002年,加拿大轮胎公司高管J.P. Martin开始分析上一年的交易数据。该公司销售体育和休闲用品、家居用品及汽车用品,并发行了一张广泛受理的信用卡。Martin审查交易记录,追踪客户购买行为与其可能拖欠还款之间的相关性。诸如购买鸟食或清除屋顶积雪的工具等负责任且具有社会导向的消费,与未来的信用可靠性相关;而购买廉价机油品牌,则表明违约可能性较高。
有些公司一旦发现客户的消费记录中出现心理咨询费用,就会收紧其信贷额度,因为抑郁和婚姻矛盾被视为可能失业的征兆。此后不久,一些信用卡公司开始利用这些及其他发现来审查客户。在美国,Visa或万事达卡处理的每笔交易都会按“商户类别”编码,例如,5122代表药品;7277代表债务、婚姻或个人咨询;7995代表博彩和下注;7273代表约会和陪侍服务。如果发现客户的消费记录中出现心理咨询费用,有些公司会收紧其信贷额度,因为抑郁和婚姻矛盾被视为可能失业或陷入高额诉讼的征兆。
这些计算以交易记录为依据,而信用评分算法则会处理包含数千个变量的数据集,这些变量汇集自支付记录、社交媒体、人口统计信息,甚至GPS数据。ZestFinance的专利描述了对支付数据、社交行为、浏览行为和用户社交网络详情的使用,还包括“借款人网络中任意或所有成员的任何社交图谱信息”。同样,Branch的隐私政策提及个人数据、短信记录、社交媒体数据、财务数据,以及手机品牌、型号和浏览器类型等设备详情。这些应用不仅利用汇总数据作出决策,还会建立系统,针对预期结果反复分析并完善自身结果,让算法通过自行建立关联来“学习”。正如ZestFinance首席执行官最近所说,“所有数据都是信用数据”;算法的运作已不再像“屋顶除雪耙=好;婚姻咨询=坏”那样简单直接。
算法的黑箱特性意味着,没有人真正知道哪些数据——或哪些数据组合——会被证明具有重要意义。尽管公司通常会坦言输入哪些数据,以完善和升级决策流程,但算法的黑箱特性意味着,没有人真正知道哪些数据——或哪些数据组合——会被证明具有重要意义。例如,英国兰卡斯特大学研究员乔·德维尔经过一些试验发现,仅仅改变手机屏幕分辨率,似乎就会导致某些算法放贷机构给出不同评分;另一些人则提出,像更频繁地给手机充电这样令人费解的行为,或许也能带来更有利的结果。与此同时,Branch首席执行官风趣地把他们的机器学习算法称为“天空中的机器人”——一种人工智能小仙子,会根据用户是乖是坏来作出放贷决策。如果你对黑箱给出的数字不满意,几乎无从改变或申诉。
算法信用评分或许看似前卫,但这类做法其实有着久远的信用评分传统渊源。例如,早期信用机构会雇用调查员深入调查客户的信用记录。这些报告大多根据当地流言编写,并受到以白人男性中产阶级为主的调查员个人猜测的影响。关于种族和阶级的评论、对家务状况的闲言碎语,以及对性取向的猜测,随处可见。纽约州布法罗的一名信用调查员写道,“与犹太人进行大额交易时应谨慎”;佐治亚州的一名调查员则把他调查的一家酒铺描述为“低等黑人商店”。类似地,1899年成立的零售商信用公司(即如今的Equifax)利用迎宾员收集的信息,为数百万美国人汇编档案,持续了整整60年。
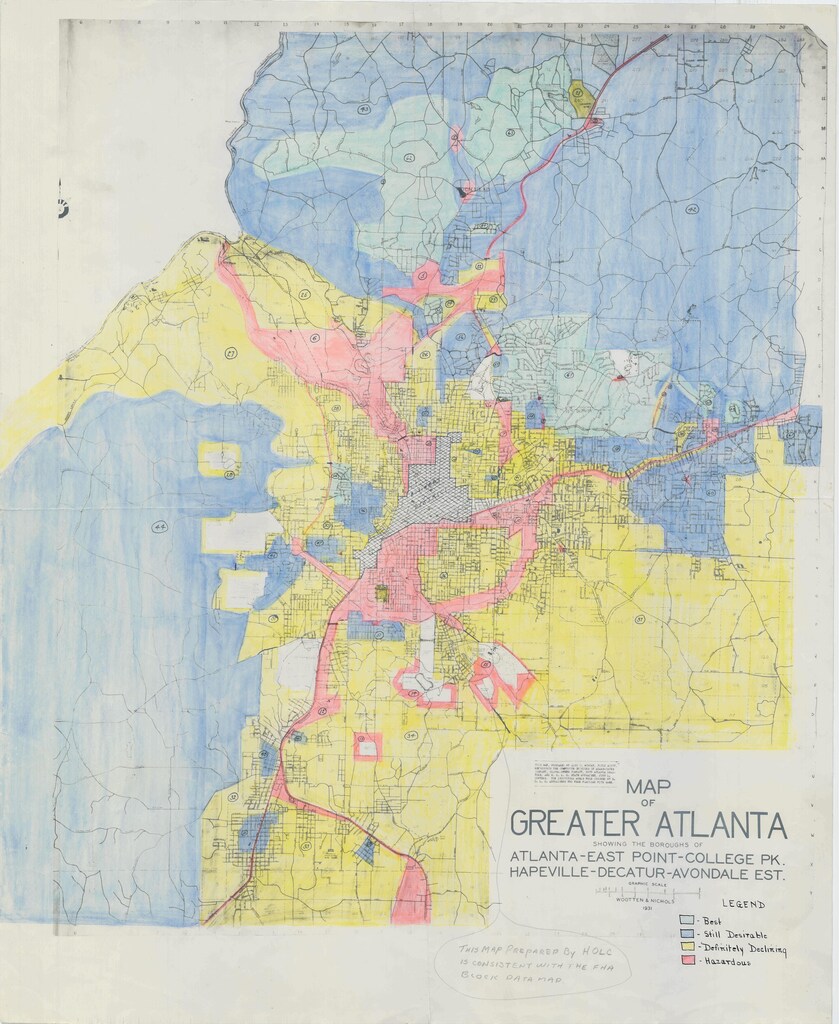
到1935年,美国整片街区都已按其信用特征进行分类。一幅当年的地图以不同颜色标出大亚特兰大地区:蓝色(理想)、黄色(明显衰退)和红色(高风险)。图例让人想起这样一个时代:个人能否获得抵押贷款,取决于其居住地的地理类别。被评为高风险的街区往往较为贫困,或以种族和族裔少数群体为主。这种如今称为“划红线”的评分做法,旨在限制人口流动,并阻止非裔美国家庭迁入以白人为主的街区。
1970年《公平信用报告法》和1974年《平等信贷机会法》旨在纠正这些歧视性做法。如今,至少金融科技领域的说法是,我们拥有详尽且无偏见的评分算法,它们在寻找信用可靠的个人时,对性别、阶级和族裔视而不见。然而,不断涌现的 研究表明,算法分类和作出决策的方式映照出历史上排斥人群的地理格局。研究算法决策的社会、经济和政治影响的学者,如凯茜·奥尼尔和弗兰克·帕斯夸莱,指出一种新兴的“网络划线”做法:算法评分再现了旧有的信贷等级和不平等。由于这些系统从现有数据集中学习,既有偏见往往会影响机器对什么是好、坏、正常或信用可靠的判断。
关于算法如何分类和作出决策的研究不断涌现,这些算法映照出历史上排斥人群的地理格局。此类系统正迅速成为常态。中国政府即将为14亿公民推出自己的算法“社会信用体系”,利用在线数据评定可信度。随着这些系统日益普及,评分逐渐代表个人价值,并决定人们获得金融服务、其他服务和基本自由的机会,一次错误决策所带来的后果也就更加严重。更不用说,首先使用此类算法代理指标是否正当,仍然值得质疑。
要求提高这些系统的透明度似乎显而易见,但在机器学习和海量数据集的背景下,查明偏见极其困难。即便我们能窥探黑箱内部,也可能找不到一条要求系统歧视穷人、有色人种,甚至电子游戏玩得太多的人”的代码指令。比了解这些评分如何计算更重要的,是为用户提供切实有效的机会,让他们能够对算法作出的不利决定提出异议和申诉。
或许这样,我们才能真正看清这些系统是否把信贷给了应得之人。




