人工智能(AI)正遭遇“内存墙”,它会拖慢性能、推高成本,最终限制发展。
面对人工智能的快速发展,内存与处理器彼此分离的传统计算机架构正变得效率低下。
应对人工智能瓶颈的替代方案包括存算一体系统、受大脑启发的脉冲神经网络、事件传感器,以及采用低精度或近似计算。
人工智能(AI)正遭遇一道物理瓶颈。随着模型规模扩大、复杂度提高,越来越多的时间和能量耗费在内存(信息存储之处)与处理器(执行计算之处)之间的数据传输上。
这种负担通常被称为“内存墙”,正成为一项严峻制约。压力迅速上升:语言处理模型在四年间规模扩大了5,000倍。
内存墙问题之所以重要,有两个原因。
首先,大规模人工智能系统的能耗需求正在迅速增长,推高了训练和运行这些系统的成本以及所需基础设施。
其次,许多有价值的人工智能应用依赖边缘设备在本地而非云端快速作出决策;在这些场景中,功耗、尺寸、连接能力和延迟都至关重要。
医疗设备、自动驾驶汽车或救援无人机无法总是依赖将信息发送到遥远的数据中心进行处理并等待响应;相反,它们往往需要能让设备端人工智能更易于实际应用的硬件。
正如我们在《科学前沿》中所述,缓解这一瓶颈主要有三种方式:让计算更靠近数据,借鉴大脑以事件驱动的信息处理方式,以及在不需要精确算术时采用较低精度或随机计算。
这些方法结合起来,有望推动新一代人工智能硬件的发展,使其速度更快、效率更高,也更适用于大型基础设施和边缘应用。
突破人工智能内存墙的三种新方法
1. 让计算靠近内存
大多数计算机仍采用沿用已久的冯·诺依曼架构,其中内存和处理单元在物理上彼此分离。即便执行简单操作,数据也必须先从内存中取出,在独立的计算单元中处理,再写回内存。
这种反复的数据传输对人工智能而言代价高昂,因为人工智能依赖数量庞大的参数和中间值,而这些数据必须反复访问。
一种应对方式是存算一体:在内存阵列内部或其附近执行运算,而不是每次需要计算时都将数据移至独立处理单元。随着人工智能系统规模扩大,减少数据传输有助于降低延迟和能耗。
存算一体并无单一的硬件方案。现有多种方法,各自在速度、精度、密度和能效方面有所取舍。更广泛地说,未来的人工智能硬件需要让存储与计算实现比传统系统设计所能提供的更紧密集成。
2. 借鉴大脑的时序机制
第二种途径是改变信息处理方式。许多人工智能系统依赖人工神经网络,持续处理输入,并在每一步执行大量计算,无论输入信号是否发生变化。
生物大脑的工作方式不同——神经元通常处于静默状态,主要在有信息需要传递时才会放电。
大脑基于时序的策略启发了脉冲神经网络,其中信息通过离散的“脉冲”或事件来表示。这意味着计算可以由输入变化触发;变化很少时,需要处理的内容也可能很少。
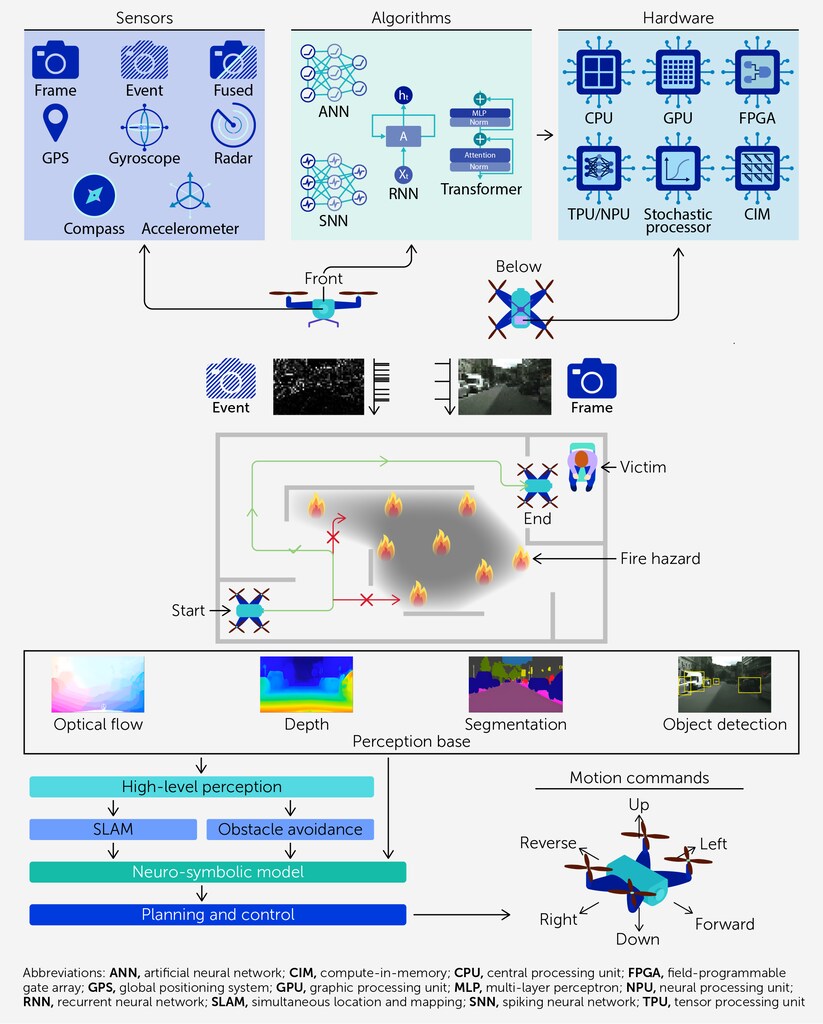
这类神经网络与事件传感器配合使用时尤其有用。传统摄像机会按固定间隔捕捉图像帧,因此会产生大量重复的视觉信息。
相比之下,事件相机只记录像素级变化,例如运动或亮度变化,从而生成精简得多的数据流。这类设备需要能够随着变化发生而进行处理的硬件和算法,而不是反复分析完整图像。
这种组合对边缘人工智能很有吸引力。执行搜索救援任务的无人机在烟雾、碎片或不稳定地形中飞行时,可能需要在电池电量有限的情况下实时检测运动、避开障碍物并调整飞行路线。
将这些信息发送到云端可能会拖慢响应,尤其是在连接不可靠时。在这类场景中,受大脑启发的处理方式可以减少不必要的计算,并让感知和决策留在本地。
3. 在最需要的地方运用精度
第三种策略是认识到,并非每项人工智能计算都需要同等程度的精度。许多模型能够容忍微小的数值误差、近似值或一定程度的硬件噪声,而整体性能不会明显下降。
对微小误差的容忍为随机或近似硬件创造了空间。实际做法可以是采用较低数值精度、允许某些运算存在受控变动,或设计以降低功耗换取算术精确性的电路。
目标是让精度符合需求。经过审慎权衡后,硬件可以减少功耗和芯片资源使用,同时仍满足应用的准确性要求。
随机和近似方法尤其适用于自适应和实时系统,例如自动驾驶汽车、移动机器人或可穿戴设备。在这些系统中,快速响应和高效运行可能比每个阶段都达到最高数值精度更重要。
对整个系统进行协同设计
将这三种途径视为同一个设计问题的组成部分时,它们的效果最为显著。未来的人工智能硬件不能先孤立地设计芯片,再设法将算法适配到芯片上。架构、内存、精度策略、传感器和学习模型都会相互影响。
因此,硬件与算法的协同设计日益重要。有些工作负载可能最适合存算一体;另一些可能受益于脉冲网络和事件感知;还有一些则可能依赖混合精度或随机方法。在许多情况下,最佳方案可能是在同一平台上结合这些方法。
更深远的意义在于,人工智能的未来既取决于硬件设计,也取决于模型设计。更高效的人工智能硬件有助于控制大型系统日益增长的资源需求,同时提升现场设备的安全性和可靠性。
这会影响医疗保健、交通运输、应急响应和工业自动化等领域的成本、基础设施、韧性和普及程度。
如果人工智能要继续扩展至全球经济各领域,同时避免能源和硬件负担同步增加,突破内存墙就至关重要。下一次飞跃或许较少来自构建越来越大的模型,而更多来自打造运行这些模型的更先进机器。




