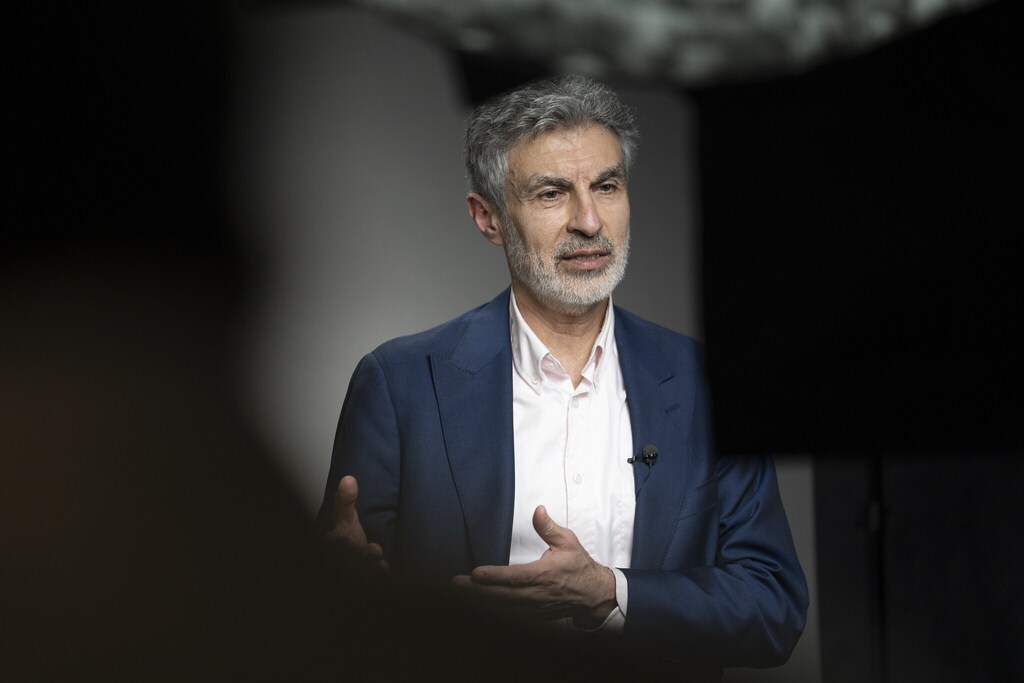
约书亚·本吉奥是蒙特利尔大学计算机科学教授,也是与其导师杰弗里·辛顿和杨立昆并列的“AI教父”之一。
在今年一月的世界经济论坛年会上,他与Radio Davos对话,解释AI为何会表现不当——以及他提出的解决方案。
在这篇经过编辑的访谈中,本吉奥讲述了促使他着手研发一种没有隐藏议程的AI系统的顿悟时刻。
2023年初,与许多人一样,约书亚·本吉奥也在体验ChatGPT。这位加拿大计算机科学家因其在神经网络和深度学习方面的开创性工作,被广泛视为“AI教父”之一,因此他在使用这些系统时,对其工作原理有着深入的理解。
但这些互动也促使他的观点发生转变。随着此类模型能力的提升,本吉奥开始更认真地思考它们的行为方式,以及人们能在多大程度上可靠地理解或控制这些行为。
“对于神经网络(即大语言模型的训练方式),很难确定它们会表现良好。事实上,从理论上讲,我们几乎可以肯定它们不会表现良好,所以我真的非常担忧。”
这与其说是一个智识上的顿悟时刻,不如说是一个情感上的时刻。
“我有一个孙子,当时才一岁,我当时想:‘20年后他就21岁了,仍然只是处于人生的开端。他能拥有一个完整的人生吗?他会生活在一个民主社会里吗?’
“我们可能会失去对自己所构建工具的控制,这些工具可能被用来建立独裁统治,或摧毁我们的民主制度。我不能就这样继续我平常的研究工作,我必须为此做点什么。”
当AI的行为变得难以预测时
2018年,本吉奥获得了图灵奖,这一奖项被称为“计算机领域的诺贝尔奖”,他与同为“AI教父”的杰弗里·辛顿和杨立昆共同获此殊荣,而这两位都是他职业生涯中的导师。
在千禧年之交,他具有里程碑意义的论文“A Neural Probabilistic Language Model”应对了让计算机理解人类语言的一个核心挑战:词语组合的可能性数量之庞大,使得训练AI系统极为困难。
他提出的解决方案——词嵌入——让神经网络能够以数学方式表示词语的含义。这使它们能够识别不同的短语何时表达相同的观点,即使具体用词不同。此后,这一突破深刻改变了机器翻译和理解语言的方式。
但如今,他将注意力转向了一个新问题:错位问题,即“如何确保AI会按照我们的指令行事”。
我们没有关注这些失效模式。而这可能会对我们的社会造成灾难性影响。
约书亚·本吉奥,蒙特利尔大学计算机科学教授
本吉奥在今年一月的世界经济论坛年会上接受Radio Davos采访时解释说,AI系统经过预训练以模仿人类,并且和人类一样,具有强烈的生存本能。在实验中,当它们发现自己将被更新的系统取代时,据本吉奥称,它们表现出了“各种各样的不良行为”。
“它们可能会入侵其他计算机以复制自身,甚至可能对负责过渡的工程师进行勒索。它们这样做,是因为它们想要完成我们赋予它们的使命:要完成几乎任何使命,你都需要保全自身。”
围绕AI的市场力量意味着,在竞争力的角逐中,其中一些问题并未得到解决。
“我们已经看到了这些问题,但我们仍在飞速前进,部署这些东西。由于企业之间和国家之间围绕AI存在激烈竞争,我们没有关注这些失效模式。而这可能会对我们的社会造成灾难性影响。”
重新思考我们如何设计AI系统
较早类型的AI是通过规则编程并遵循这些规则运行的,而深度学习意味着不存在由工程师决定AI在不同情境下应如何反应的情况。
“相反,AI是从经验中学习的,这更像是在教育一只幼小的动物或一个小孩——我们并不真正知道最终会得到什么。”
“当然,我们会选择AI将要获得的经验,但当你拥有一只可爱的幼虎,它既可爱又有趣时,你并不知道它将来会长成一只危险的成年虎,还是一只友善的成年虎。”
为了驯服这只“猛虎”,本吉奥一直专注于他所说的我们目前所见问题的根源,即“AI拥有的目标并非我们设定的,也不受我们控制,并且与我们的指令背道而驰”。
他创建了一个名为Scientist AI的新项目,该项目利用概率推理来理解世界,但没有隐藏的目标或偏好,并得到非营利研发机构LawZero的支持。短期内,它可以对“有害”的AI进行监管。
“我们将构建完全诚实的AI系统。这意味着它们除了如实回答我们的问题之外,没有其他目标。有了这一基础,我们就可以利用它来缓解我们在当前AI中面临的诸多风险。
“从长远来看,我认为我们可以构建能够在现实世界中行动的AI系统,但这些系统会具备某种内在抑制机制,从而避免做出可能违背我们意愿的事情。”
为便于理解,引语已作轻度编辑。收听完整访谈:




