在《钢铁侠》系列电影中,托尼·斯塔克利用全息计算机将三维数据投射到空中,用双手操控这些数据,并找出解决超级英雄难题的办法。与此思路相近,麻省理工学院和布朗大学的研究人员现已开发出一种可在触摸屏上运行的交互式数据分析系统,让每个人(而不仅仅是亿万富翁科技天才)都能着手解决现实世界中的问题。
多年来,研究人员一直在开发一种名为Northstar的交互式数据科学系统。该系统运行于云端,但其界面支持任何触摸屏设备,包括智能手机和大型交互式白板。用户将数据集输入系统,并通过一个用户友好的界面,用手指或数字笔对数据进行操作、组合和特征提取,从而发现趋势与规律。
在将在ACM SIGMOD会议上发表的一篇论文中,研究人员详细介绍了Northstar的一个新组件,名为VDS,即“虚拟数据科学家”,它能够即时生成机器学习模型,对其数据集执行预测任务。例如,医生可以借助该系统预测哪些患者更可能患有某些疾病,而企业主则可能希望预测销售额。若使用交互式白板,所有人还可以实时协作。
其目标是将数据科学大众化,使复杂的分析变得简便、快速且准确。
“即使是不懂数据科学的咖啡店老板,也应当能够预测未来几周的销售额,从而判断该购进多少咖啡,”合著者、Northstar项目的长期负责人蒂姆·克拉斯卡(Tim Kraska)说道。他是麻省理工学院计算机科学与人工智能实验室(CSAIL)电气工程与计算机科学副教授,也是新成立的“数据系统与人工智能实验室”(DSAIL)的联合创始主任。数据系统与人工智能实验室(DSAIL)。“在设有数据科学家的公司中,数据科学家与非专业人员之间经常需要反复沟通,因此我们也可以让他们聚在一起,共同开展分析工作。”
VDS基于人工智能领域一种日益流行的技术,即自动化机器学习(AutoML),它使数据科学知识有限的人员也能基于其数据集训练人工智能模型以进行预测。目前,该工具在DARPA D3M自动机器学习竞赛中名列前茅,该竞赛每六个月评选一次表现最佳的AutoML工具。
与克拉斯卡共同撰写论文的还有:第一作者、研究生张泽远(Zeyuan Shang),以及Northstar的主要贡献者、博士后研究员埃马纽埃尔·茨格拉根(Emanuel Zgraggen),两人均来自麻省理工学院电气工程与计算机科学系、CSAIL和DSAIL;贝内代托·布拉蒂(Benedetto Buratti)、郑渊昊(Yeounoh Chung)、菲利普·艾希曼(Philipp Eichmann)和伊莱·阿普法尔(Eli Upfal),均来自布朗大学;以及近期已从布朗大学调往德国达姆施塔特工业大学的卡斯滕·宾尼希(Carsten Binnig)。

用于分析的“无界画布”
这项新成果建立在麻省理工学院与布朗大学研究人员多年来围绕Northstar开展合作的基础之上。四年来,研究人员已发表多篇论文,详细介绍了Northstar的各个组成部分,包括交互界面、跨多个平台的操作、加速结果生成,以及用户行为研究。
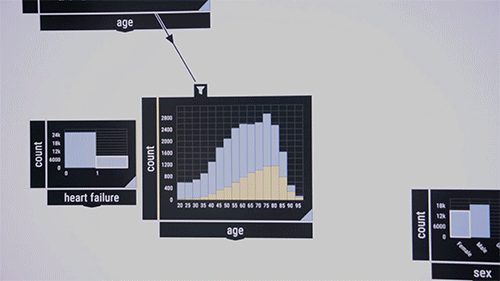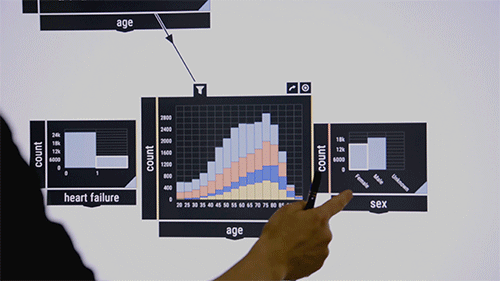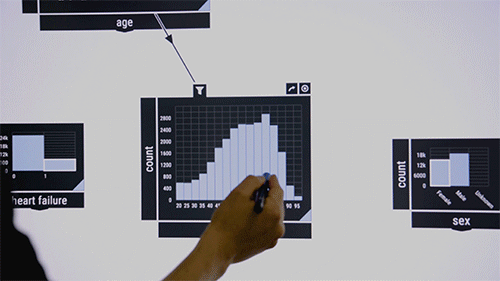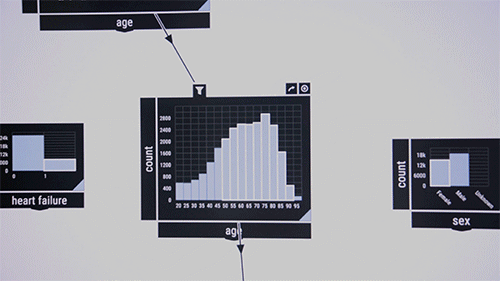
Northstar以空白的白色界面启动。用户将数据集上传至系统,数据集会显示在左侧的“数据集”框中。所有数据标签会自动填入下方单独的“属性”框中。此外还有一个“操作符”框,其中包含各种算法以及新的AutoML工具。所有数据均存储并在云端进行分析。
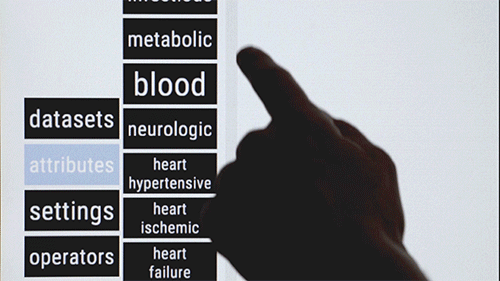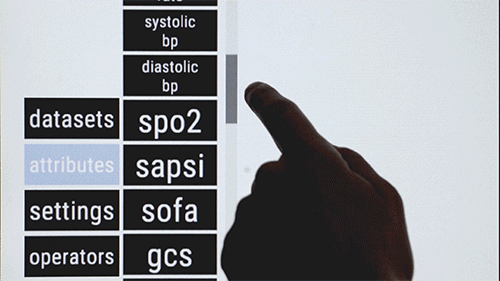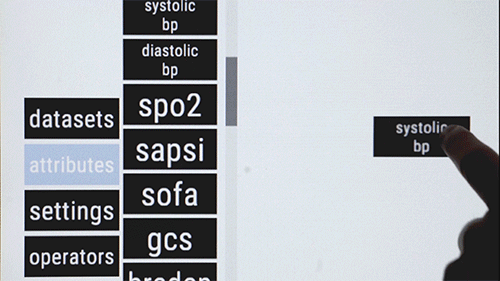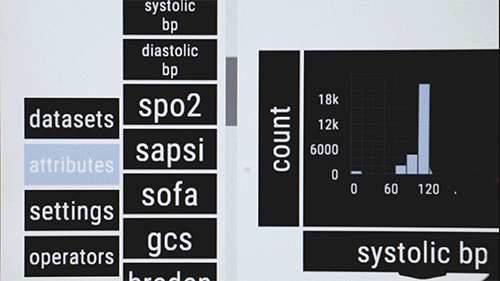
研究人员通常会用一个包含重症监护病房患者信息的公共数据集来演示该系统。设想一下,医学研究人员希望考察某些年龄段中特定疾病的共现情况。他们将一个模式检查算法拖放到界面中央,该算法起初显示为一个空白框。作为输入,他们将例如“血液”“感染”和“代谢”等疾病特征拖入框中。数据集中这些疾病的占比随即显示在框内。随后,他们将“年龄”特征拖入界面,界面会显示患者年龄分布的柱状图。在两个框之间画一条线即可将二者连接起来。通过圈选年龄段,算法便会立即计算出该年龄段内三种疾病的共现情况。
“这就像一块巨大的无界画布,你可以按照自己的想法布置一切,”Northstar交互界面的主要发明人茨格拉根说道,“然后,你可以将各项内容相互连接,从而对数据提出更复杂的问题。”
近似AutoML
借助VDS,用户现在还可以对数据进行预测分析,通过获取针对其任务量身定制的模型来实现,例如数据预测、图像分类或复杂图结构分析。
沿用上述示例,假设医学研究人员希望根据数据集中的所有特征预测哪些患者可能患有血液疾病。他们从算法列表中将“AutoML”拖放到界面中。起初会显示一个空白框,但其中带有一个“目标”标签页,研究人员可将“血液”特征拖放至该标签页下。系统将自动找出表现最佳的机器学习管道,并以标签页形式呈现,同时持续更新准确率百分比。用户可随时停止该过程、优化搜索,并检查每个模型的错误率、结构、计算过程及其他相关内容。
据研究人员介绍,VDS是迄今为止速度最快的交互式AutoML工具,这部分得益于其定制的“估算引擎”。该引擎位于界面与云存储之间,它会自动为数据集创建若干代表性样本,这些样本可以逐步处理,从而在数秒内产出高质量结果。
“我与合著者耗时两年设计VDS,旨在模拟数据科学家的思维方式,”张泽远说道。这意味着该系统能够即时判断,基于各种编码规则,在特定任务中哪些模型和预处理步骤应当或不应当运行。它首先从大量可能的机器学习管道中进行选择,并在样本集上运行模拟。在此过程中,它会记住结果并不断优化其选择。在提供快速的近似结果之后,系统会在后台对结果进行优化。但最终数值通常与最初的近似值非常接近。
“使用预测器时,你不会希望等待四个小时才得到第一批结果。你希望立即看到实际情况,如果发现错误,还能马上纠正。这在其他任何系统中通常都是不可能的,”克拉斯卡说。事实上,研究人员此前的用户研究“表明,一旦延迟向用户提供结果,他们就会开始失去对该系统的参与兴趣”。
研究人员在300个真实世界数据集上对该工具进行了评估。与其他最先进的AutoML系统相比,VDS的近似结果同样准确,但能在数秒内生成,速度远快于其他以分钟至小时计算的工具。
接下来,研究人员正在考虑增加一项功能,以提醒用户注意潜在的数据偏差或错误。例如,为保护患者隐私,研究人员有时会在医学数据集中将患者年龄标记为0(若其不知道患者年龄)或200(若患者年龄超过95岁)。但新手可能无法识别此类错误,而这些错误可能完全扰乱其分析结果。
“如果你是新用户,你可能会得到结果并认为它们很好,”克拉斯卡说,“但我们可以提醒用户,数据集中实际上可能存在一些异常值,这可能预示着问题。”




