最新一段蒙面伊斯兰国圣战分子的视频显示,此人似乎带有英国口音,这使他被 初步确定为 来自伦敦东区的穆斯林皈依者 Siddhartha Dhar。据报道,语音识别专家正运用语音分析技术与英国情报部门合作。但这项技术如何运作,又有哪些能力?
我们大多数人在听到熟悉的声音时,只需几个词便能辨认出说话者,而不太熟悉的声音则可能需要稍长一点的时间。如果所说话语的语境和内容也较为熟悉,辨认就会更加容易。一般而言,机器在比对录音、寻找匹配时也面临同样的制约。
旨在通过声音判断说话人身份的计算系统—— 说话人识别 ——主要区别在于其目标:是检测单一已知说话人是否在场;是将语音与若干已知说话人之一进行匹配;是从未知录音中检测可识别的内容;或是核实某段语音录音确实来自预期的说话人。
现代系统大多采用大数据方法,即利用大量已知录音训练机器学习算法,使其能够识别个体说话人的声音特征。其理念是,区分不同说话人的关键特征由系统自动学习获得。相比之下,较早的方法需预先规定哪些类型的语言与语音特征被认为重要,以便在说话人之间进行比较。
虽然我们并不真正清楚哪种特征组合最适用于声纹识别,但可以将其分为声学特征或语言特征两类。
声学特征与语言特征
声学特征是人类发声方式的特征。说话时,气流从肺部呼出,经过气管向上,穿过喉部,从口腔和鼻腔排出。气流经过时使声带振动;声带放松或收缩时,振动频率随之改变,从而改变我们声音的音高。
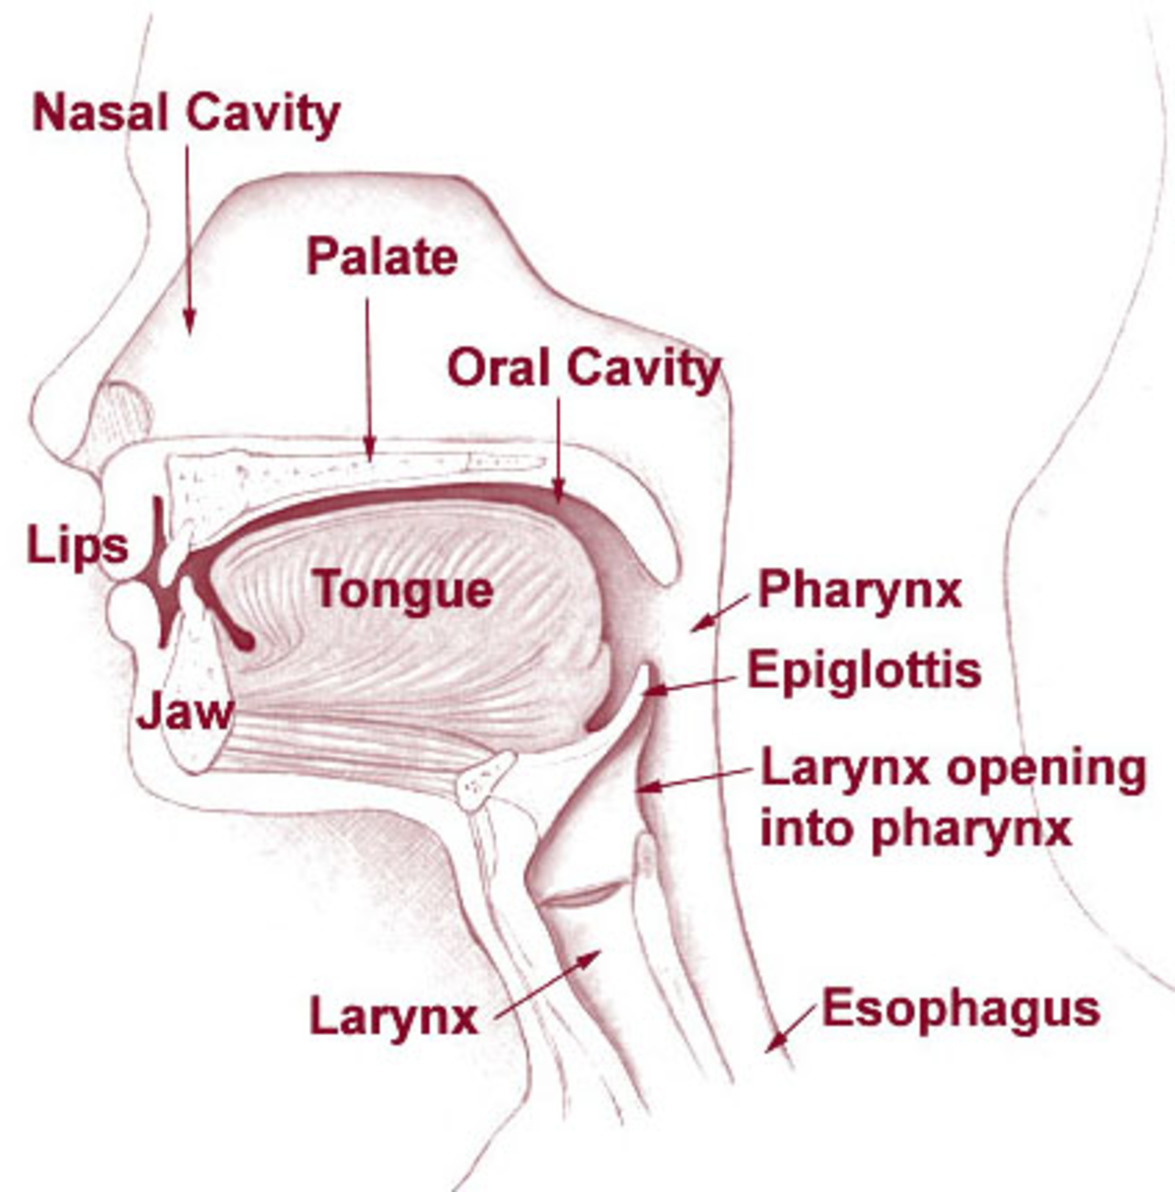
来源:美国国家癌症研究所
声道和鼻腔内的若干部位,如舌头、牙齿和嘴唇(被称为发音器官),会对声音进行调节,产生不同的共鸣(称为共振峰),从而形成语音的其他可变特征。我们听到的语音,正是气流穿过这些腔体、并在这些身体部位之上和之间流动时所产生的各种相互作用的综合结果。
每个人的说话特征都是独特的:肺部呼气的方式、声带的共鸣方式、发音器官的运作方式,都会产生独特的声音。一个人发出的“a”可能与另一个人的截然不同,而这仅是英语中44个音素(构成词语的最小声音单位)之一。语音将各音素连接在一起、并从一个音素过渡到另一个音素的方式也各不相同,这一过程的速度同样存在差异。试比较英格兰乡村口音那种平稳的节奏、圆润的元音,与大城市中常见的更快、更急促的语速之间的差别。
语言特征涉及我们选用哪些音素以及以何种顺序排列,而非这些音素是如何发出的。如果我说“tomahto”,而你说“tomayto”,那么我们说的是同一个词,只是音素选择不同。基于熟悉程度,且往往还受地域和代际差异影响,存在大量不同的发音方式。词语的选择、不同的词汇、语法模式、特有的停顿、重音、句式或短语,同样可以用来辨别不同的说话人。
更高层面上,则是词语本身的含义。我们在选用说话内容以及表达方式上往往各有偏好,我们的说话方式是直接、对抗、回避,还是偏于学究气,都会有所不同。如果你曾遇到某人,觉得他说话像律师、教师或艺术家,那么你所识别出的这些模式,计算机同样也能识别。

短语“I owe you”的时频语谱图。 Jonas.kluk
理解这一切
从计算角度看,首先需要分离出语言特征和声学特征,将海量数据压缩为便于处理的特征集,简要捕捉其中的重要细微差别。随后,通过模式匹配将这些特征与另一段录音的特征进行比较。
可自动提取的语音特征包括音高、共振峰频率、声道长度,以及音节的发音速率。一些现代方法更适用于较低层级的特征,这些特征处理所需的运算较少,对人耳而言内在含义也较少。这些特征通常是时间与频率的二维图谱,例如语谱图。
一旦复杂的语音被简化为一组更具代表性的特征,便会应用一套通用的模式匹配流程,以确定最佳比较方式以及模式的吻合程度。只要有足够优质的语音可供分析,我们便能令人信服地将说话人与一小群嫌疑人中的某一人进行匹配。双方可供比较的语音越多,匹配结果就越可靠。在本案中,专家已掌握Dhar身在英国期间 接受采访的多段录音 。
若无嫌疑人可供比对,这项任务几乎不可能完成,无异于大海捞针。但我们能从录音中了解和推断关于说话人的信息,这本身就能将这片“大海”缩小到更易处理的范围。例如,专业听辨人员可以判断说话人的家乡所在地区、年龄、性别、情绪状态,或许还能推断其受教育程度。在某些情况下,语音专家还能判断说话人的出生地、其父母是否使用其他语言,以及其近期是否曾居住于他处。甚至或许还能推断出其离开英国的时间。
科幻还是现实?
尽管大部分内容属于机密,但据信,语音识别技术被英国的GCHQ、美国国家安全局(NSA)以及中国的公安局(Public Security Bureau)等国家安全机构使用,诸如此类。人们还普遍认为,在一些国家的机场入境柜台处会采集声纹,这或许可以解释,为何你在办理手续时可能会被问到一两个毫无意义的问题。毕竟,机场的面部识别技术已相当普及,为何不对声音也如法炮制呢?
GoVivace、iFlytek、IBM和Nuance等公司提供的商用声纹匹配技术,可能至少落后于各国政府所使用的技术一代。目前该技术的实用性如何仍有争议,但金融机构每天都在将其用作 说话人验证 的手段,用以证明对方确为其所声称的身份。
声纹分析自20世纪70年代起便被用于刑事案件,成效参差不齐,通常用于较为简单的任务,即证明某段录音中的语音属于特定说话人。从庞大的可能人选中匹配某一说话人,且其中甚至可能不包括正确答案,则要困难得多。但这并非不可能,而且相关系统正在不断改进。
发表本文并不意味着世界经济论坛认同其中的观点。
如需紧跟 Agenda 订阅我们的每周简报。
作者:Ian McLoughlin是肯特大学计算机学教授,同时担任梅德韦学院负责人。
图片:一名伊斯兰国武装人员在土耳其军车于叙利亚城镇科巴尼附近就位时,从伊斯兰国的一面黑旗旁走过。REUTERS/Umit Bektas。