公共政策的影响在一定程度上取决于其选择目标对象的效果。机器学习可以利用日益丰富的信息来提供帮助。本文使用意大利的数据,举例说明如何运用机器学习,将政策对象锁定为可能从政策中获益更多的群体。文章展示了与基于少数任意选定特征制定粗略政策分配规则的常规做法相比,利用机器学习选择政策对象的优势。
为制定政策提供依据,我们需要回答因果问题和预测问题。Kleinberg 等人(2015)提供了一个例子,帮助我们区分二者。采取抗旱行动的政策制定者可能需要知道,祈雨舞是否会产生预期效果。这纯粹是一个因果问题。但其他与降雨有关的决策,例如是否发放雨伞,只需要准确预测恶劣天气发生的可能性,因为持伞的收益是已知的,至少可以在一定程度上近似估计。Kleinberg 等人(2015)将此称为“预测型政策问题”。
大多数政策评估文献都聚焦于因果问题。计量经济学中的“可信度革命”(Angrist 和 Pischke,2010)为我们提供了事后估计公共项目因果效应的工具。尽管如此,政策的影响也取决于其选择目标对象的效果。在资源有限时,预测哪些对象可能带来更高回报至关重要。这正是机器学习发挥作用之处。统计学和计算机科学领域开发的机器学习算法(Hastie 等人,2009)已被证明在预测任务中尤其强大(Mullainathan 和 Spiess,2017)。1
我们举例说明如何运用机器学习,将政策对象锁定为可能从政策中获益更多的群体。2 与基于任意选定的可观测特征实施粗略分配规则的常规做法相比,这些例子展示了机器学习对象选择的优势。不过,最终只有事后评估方法才能告诉我们,基于预测选择对象是否带来了预期收益。本文还讨论了在公共政策中使用机器学习算法所引发的一些问题,例如透明度、操纵等。
机器学习对象选择示例
在 Andini 等人(2018a)的研究中,我们考察了意大利于2014年推出的一项退税计划,旨在提振家庭消费。意大利政府选择了粗略的对象选择规则,仅向年收入在8,145欧元至26,000欧元之间的雇员提供退税。鉴于政策目标,另一种做法可以是将消费受限家庭作为对象,因为预计他们会将更多奖金用于消费。
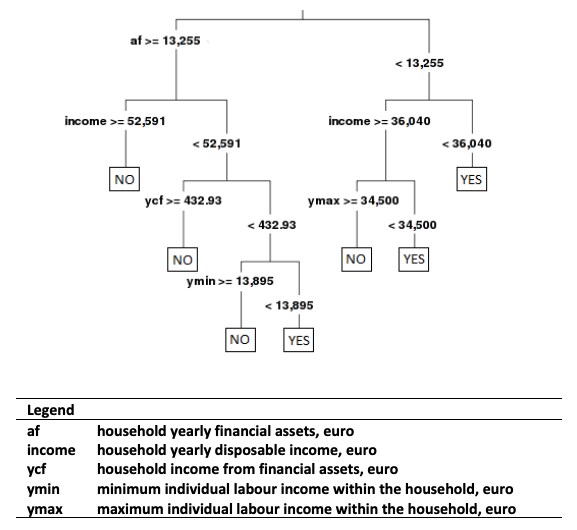
调查往往包含自我报告的指标,可用作消费受限状况的代理变量。我们使用意大利银行《家庭收入与财富调查》(SHIW)2010年和2012年的数据,该调查询问家庭能否维持收支平衡。我们采用现成的机器学习方法,根据一大批可能用于选择对象的变量预测这种状况。我们首选的算法是决策树,由此得出图1所示的分配机制。该机制只选择少数几个变量,主要涉及家庭收入和财富。例如,金融资产低于13,255欧元且家庭可支配收入低于36,040欧元的家庭,会被预测为消费受限。查看图表即可轻松了解被预测为消费受限的其他群体。
图1。消费受限状况的决策树预测模型
即使我们有理由相信,被预测为消费受限的家庭更有可能将退税用于消费,也没有任何保证表明情况确实如此(Athey,2017)。为减轻这些疑虑,我们利用2014年SHIW数据,分别估计奖金对被预测为消费受限和未被预测为消费受限家庭的影响。为此,我们回到标准计量经济学方法,假设选择取决于可观测因素,并进行回归分析。
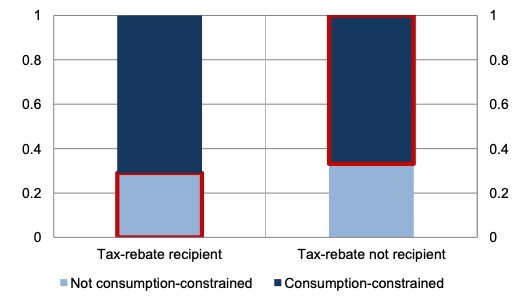
估计结果显示,只有对被预测为消费受限的家庭,影响才是正向且显著的。退税受益者的分布表明,使用机器学习选择对象可能带来巨大收益(图2,红框标出):实际受益者中约三分之一被预测为非消费受限,而未获得退税者中约三分之二被预测为消费受限。
图2。按退税受益者身份划分的预测消费受限者占比
在第二项应用研究(Andini 等人,2018b)中,我们聚焦于向企业提供公共信贷担保这一“预测型政策问题”。此类计划通过提供公共资金支持的抵押品,旨在帮助企业获得银行信贷。原则上,担保计划应面向既有偿付能力(以确保计划的财务可持续性)、又受到信贷配给的企业(因为其他企业无论如何很可能都能获得信贷)(世界银行,2015)。在实践中,现有担保计划通常依据简单的规则,排除偿付能力较低的借款人。我们提出一种基于机器学习预测的替代分配机制,同时明确考虑偿付能力和信贷配给。
这项研究以意大利为对象,当地公共担保基金自2000年起运行。我们利用信贷登记系统的微观数据,其中包括信贷配给3和不良贷款发生情况的指标,据此识别假设中的目标企业,并估算机器学习模型以预测其是否符合条件。在这一案例中,我们首选的机器学习算法是随机森林,本质上是多棵决策树的平均结果。
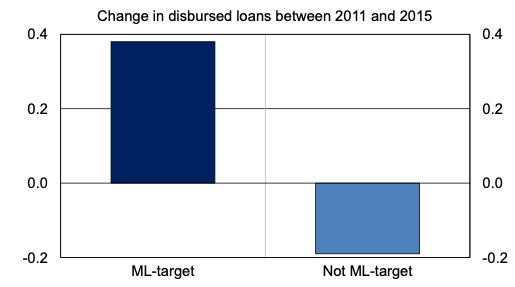
为了评估将这些企业作为对象是否会提高该计划对信贷可得性的影响,我们首先考察获得担保的企业,并根据机器学习是否将其预测为目标对象,将它们分为两组。简单比较担保提供后几年银行贷款发放额的增长率可以看出,机器学习选定的对象组表现更好(图3)。采用更严谨的回归不连续设计(如 de Blasio 等人,2018)也得出了相同结果:担保对机器学习目标组信贷可得性的影响更大。
图3。按机器学习目标对象身份划分的担保基金受益企业表现
机器学习对象选择面临的问题
将机器学习方法用于政策对象选择,需要处理一些有争议的问题。一个顾虑涉及决策规则的可解释性,而提高可解释性可能会以牺牲精度为代价。在某些应用中,简单算法已经足够准确,例如退税案例中的决策树。在其他情况下,更合适的机器学习对象选择规则就像一个“黑箱”,例如上述公共担保计划所用的随机森林。黑箱规则缺乏可解释性,可能被视为对透明度的威胁,因为被排除在外的主体可能难以理解自己为何没有被选中(Athey,2017)。精度与透明度之间的权衡取决于具体应用。
不过,透明度还有一个维度,可称为实质性透明度,关乎政策制定者是否有责任完成使命,即有效使用公共资金。在这方面,机器学习对象选择显然胜过粗略的分配规则。
另一个顾虑是,基于机器学习的对象选择规则是围绕特定收益目标建立的(例如改善企业获得信贷的渠道)。为实现这一目标,规则会选择某些群体(目标对象),而不选择其他群体。这种选择可能损害其他政策目标(“遗漏的收益”;见 Kleinberg 等人,2018)。例如,回到担保基金的案例,公共担保也曾被大力倡导为应对经济衰退的措施。有人可能会担心,我们基于机器学习的对象选择规则最终会排除位于南部地区的企业,而这些地区受危机冲击更大。事实并非如此:基于机器学习的规则优先选择南部地区,而担保基金的实际规则更倾向于北部地区。
最后一个顾虑是,当对象选择规则为人所知时,相关主体可能会操纵自己的可观测特征,以从政策中获益。不过,任何类型的对象选择都存在这一问题。例如,对比退税的决策树规则和实际规则可以发现,为了获得奖金,潜在受益者需要操纵多个变量(最简单的情况是同时操纵金融资产和收入);而实际措施只依据收入。




