我们的身心健康受到诸多环境、社会和经济因素的影响。
我们的健康数据通常不包含这些因素,因此更难发现差异或确定医疗优先事项。
世卫组织健康不平等数据库旨在解决这一问题。
该数据库汇集了多个公共来源的数据,按多项不平等指标进行细分,可帮助决策者更好地理解其中的动态变化。
我们在何处出生、成长环境如何,以及生活和工作条件怎样,都会导致身心健康的差异。已知这些社会、环境和经济因素会造成既具有系统性又可以避免的健康结果不平等。
了解这些差异及其产生的原因,是解决健康不平等问题的关键。因此,世界卫生组织(世卫组织)创建了健康不平等数据库,这是全球最大的关于健康及健康决定因素的不平等数据集合。
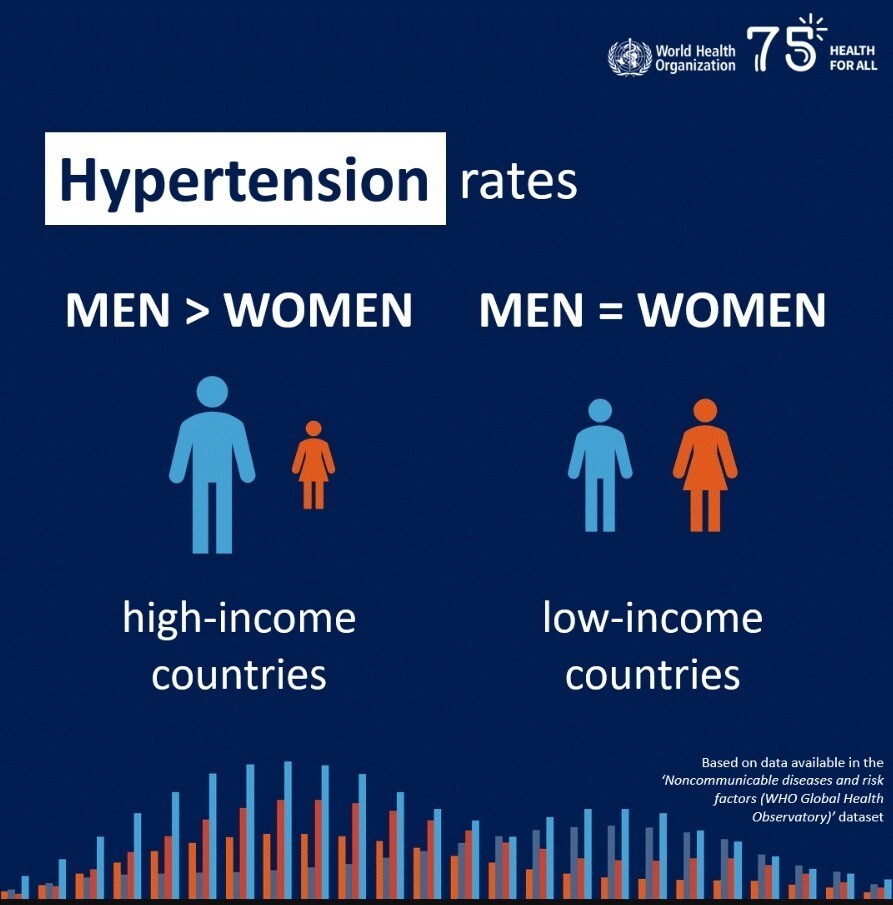
什么是健康不平等数据库?
设立该数据库是为了解决分类健康数据匮乏的问题,即已按性别、教育水平或地点等子类别进行细分的数据。
这些分类数据可能揭示出被汇总数据掩盖的健康或健康结果差异。
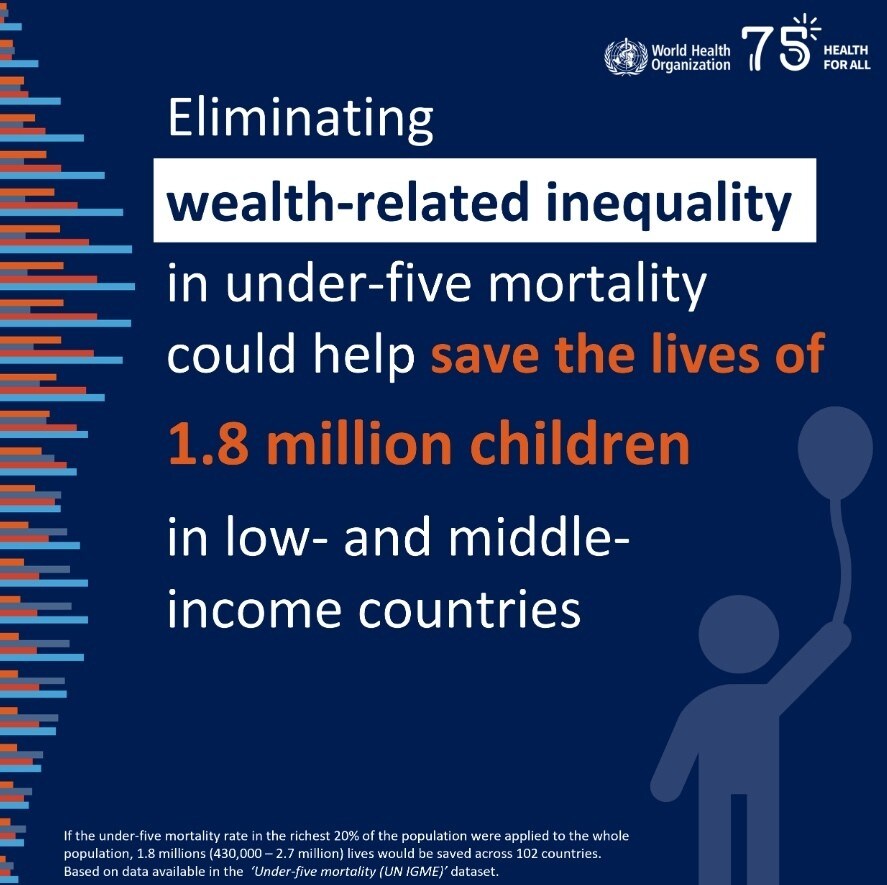
世卫组织表示,符合条件的可持续发展目标(SDG)指标中,只有一半拥有分类数据。在与良好健康与福祉相关的可持续发展目标3的指标中,不到一半拥有分类数据。
数据最常见的细分方式是按性别或年龄划分,而教育、经济状况或残疾等其他因素往往未被单独区分,世卫组织表示。
该数据库中约有1100万个数据点,涵盖59个数据集。这些数据按22个不同的不平等维度进行细分,来源于多种公共渠道。
特定软件可帮助用户探索、分析和报告数据,这些数据可用于为旨在应对健康不平等的政策和项目提供依据。
世界经济论坛如何推动数据驱动的医疗保健落地?
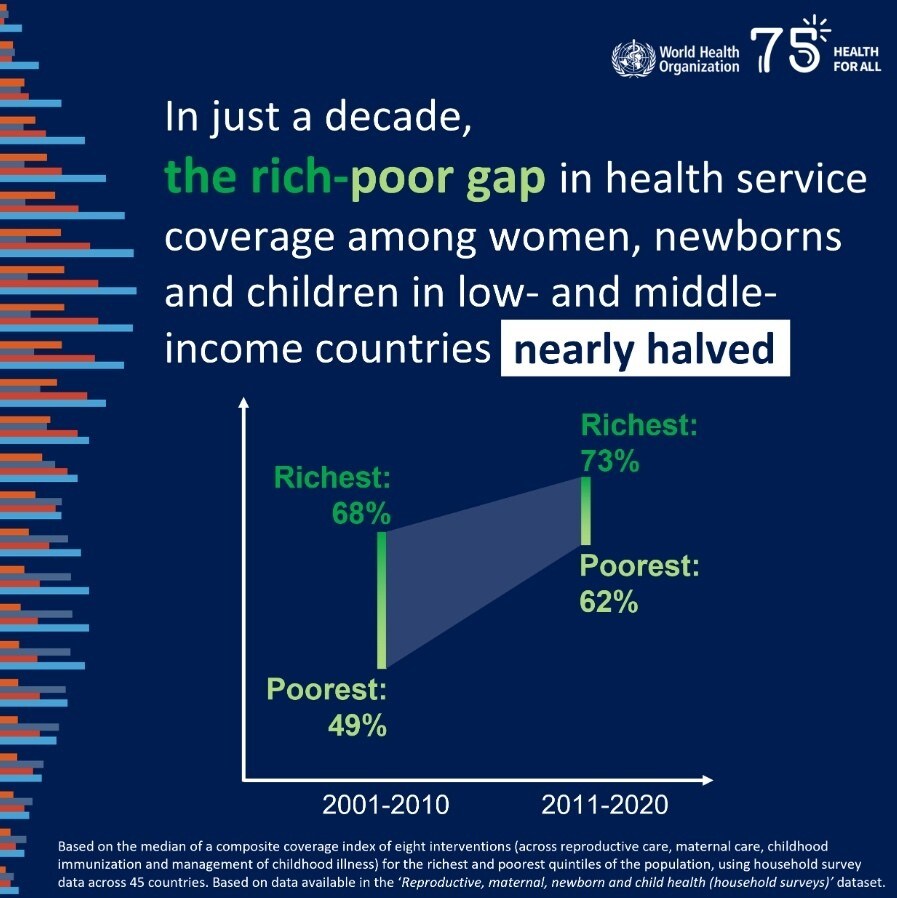
健康数据的更广泛问题
围绕健康的数据零散或有限,这是一个普遍存在的问题。临床试验的大部分数据存在偏差,例如,女性通常代表性不足。此外,涉及非白人群体的研究数量太少。
这意味着,我们用于指导大部分药物和治疗方案的数据,可能并不针对接受治疗的人群量身定制。这也使得确定需要优先投入资金的领域和提高对相关问题的认识变得更加困难。
世界经济论坛的《全球健康与医疗保健报告》强调了理解并应对医疗保健人群的多样性的重要性。报告呼吁制定明确的指导方针,以提高包容性,帮助各国建立更具韧性和公平性的医疗保健体系。





