决策者正依靠冠状病毒预测来制定政策,因此他们必须询问这些预测是如何得出的,两位科学家写道。
从模型为何创建,到使用了哪些数据,以下是四个关键问题。
4月8日,纽约州州长安德鲁·科莫宣布该州的新冠肺炎疫情“曲线正在趋平”。但就在两周前,各种模型预测,纽约州住院人数峰值可能是后来实际人数的数倍。科莫将新冠肺炎实际住院人数与这些预测并列比较后问道:“专家预测的曲线与实际情况相差这么大,这是怎么得出的?”
科莫的问题概括了决策者在应对预测模型时面临的挑战。当事关重大、基于模型的预测又是主要指引时,政策制定者应当如何行动?
这不仅是疫情期间相关的问题。2008年金融危机凸显了经济和金融模型的力量(及其风险),而在大数据和强大计算能力的时代,人们只会越来越依赖这类工具。作为经常构建模型用于政策分析的科学家,我们提出决策者在使用此类模型的结果时应当提出的四个问题。
首先,创建这个模型的目的是什么?
每个模型都会简化现实。模型创建者决定简化什么(以及如何简化)、纳入什么、舍弃什么,主要取决于模型旨在探究的问题。模型的具体用途决定了所采用的数学方程和方法。
如果将模型改用于探究它原本并非为之设计的问题,那么结果的可靠程度就取决于问题与模型设计的契合程度。例如,用于估算病床使用情况的模型,可能与旨在理解疾病传播动态及其政策影响的模型大不相同。
其次,模型的关键假设是什么?这些假设是否都适用于当前情况?
重要的不只是模型最初为解决什么问题而设计。例如,一些传染病流行病学模型假设人口固定。这对某些地区或许成立,但对每天有大量人员(无论感染与否)进出的大城市则未必适用。
其他假设可能涉及过去的哪些方面会在未来保持不变。许多模型只是呈现一种可能的未来情景,前提是事情会沿着过去的轨迹发展。这类分析很有用,因为它们展示了如果我们不作调整,可能会发生什么。这些信息有助于推动行动,避免不理想的未来,创造更美好的未来。
我们的社会处于动态变化之中,大多数人都会不断对新信息作出反应,只是反应延迟程度各不相同。因此,仅仅将预测公之于众,就可能改变未来的发展轨迹。政策制定者因此需要了解,模型将现实世界中的哪些方面视为固定不变。他们还必须询问,如果某些关键假设在具体情况下并不完全成立,模型结果会如何变化。
第三,输入模型的数据来自哪里?这些数据在当前情境下有多适用?
模型利用数据计算具体结果,因此了解数据来源及其准确性至关重要。理想情况下,数据应来自可靠来源,涵盖正在考虑相关政策的地区,并尽可能及时更新。实际上,数据可能有限、颗粒度不足,或来自不同的情境。若是如此,模型研究者应明确说明。
例如,美国早期一些关于新冠肺炎患者所需病床数量和重症监护能力的估算,是基于中国的数据。但如果美国医生收治患者住院时采用的标准与武汉同行不同,那么中国的数据适用性就会有限。
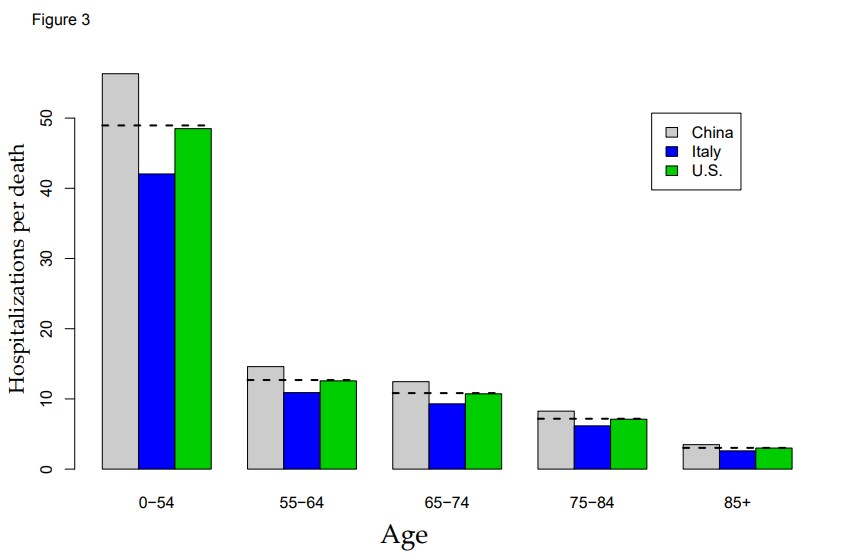
政策制定者往往必须尽可能利用现有数据,即使这些数据存在缺陷。适当指出这些缺陷或不足,能为决策提供重要背景,也凸显了尽快获取更好数据的紧迫性。
最后,结果有多大的不确定性?
如果只盯着单一预测,却没有充分重视其不确定性,可能会造成危险和高昂代价。模型研究者以及援引模型的新闻报道,应清楚说明任何不确定性的来源和程度。同时,政策制定者必须设法了解模型的误差范围,并在作出决策时牢记这一点。
随着决策者越来越依赖关于新冠肺炎及其他重要议题的大量预测,他们询问预测是如何得出的,比以往任何时候都更加重要。模型永远无法完美预测未来。但如果构建得当,并以谦逊的态度使用,它们就像雨中船上的望远镜——提供模糊的影像,帮助我们辨认前方可能出现的情况,从而决定是否要驶向一条不同而更好的航线。




