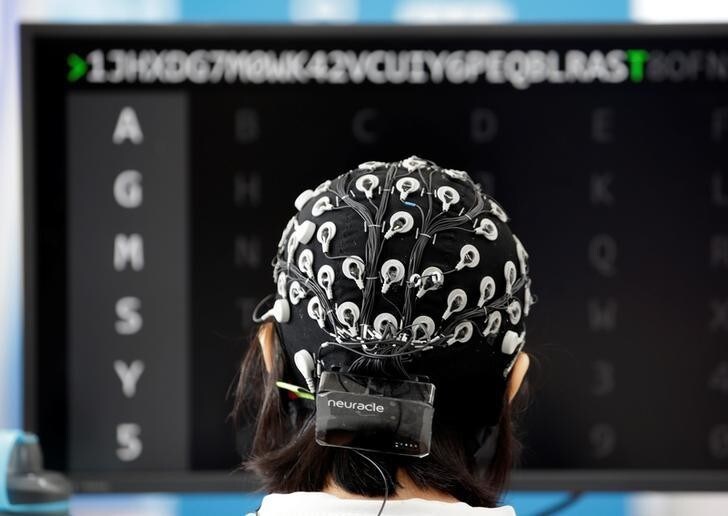
一项新研究发现,我们的大脑具有“自动纠正”功能,在重新解读模糊声音时会启动这一功能。
“一个人以为自己听到的内容,并不总是与传入耳朵的实际信号相符……”
这项研究揭示了大脑如何利用初始声音被检测后收集到的信息来帮助理解语音。研究结果发表于《神经科学杂志》,指出我们利用信息和语境帮助理解语音的新方式。
“一个人以为自己听到的内容,并不总是与传入耳朵的实际信号相符,”论文第一作者劳拉·威廉姆斯解释道。她是纽约大学心理学系博士生,也是纽约大学阿布扎比分校语言神经科学实验室的研究员。
“我们的研究结果表明,这是因为每当听到后续语音时,大脑都会重新评估对语音的解读,并在必要时更新理解,”威廉姆斯说。
“值得注意的是,听觉会受到最多晚一秒出现的语境影响,而听者始终不会意识到自己的感知已经改变。”
“例如,像‘b’和‘p’这样模糊的起始音,会因出现在‘parakeet’(长尾小鹦鹉)还是‘barricade’(路障)一词中而被听成不同的音,”首席研究员亚历克·马兰茨补充道。他是语言学系和心理学系教授,也是语言神经科学实验室的联合主任,研究人员在该实验室开展了这项研究。
“这一过程发生时,人们并未有意识地察觉到这种歧义,尽管要到第三个音节的中间部分才会出现消除歧义的信息。”
研究人员制作了这些刺激音的示例,你可以在这里收听。
语境是关键
人们早已知道,语音的感知取决于其周围语境,包括词语、句子和其他语音。在许多情况下,这些语境信息出现得比最初的感官输入更晚。
“有趣的是,这种语境可能出现在所解读的声音之后,却仍然能够改变我们对声音的感知……”
这种情况在日常生活中随处可见——交谈时,我们说出的实际语音往往含糊不清。例如,朋友说她的车上有个“dent”(凹痕)时,你可能听成“tent”(帐篷)。尽管这种歧义经常出现,但作为听者,我们几乎不会察觉。
“这是因为大脑会自动替我们消除歧义——它选定一种解释,而我们感知到的就是这种解释,”威廉姆斯解释道。“大脑通过利用周围语境来缩小说话者可能表达的意思范围。”
在这项研究中,研究人员试图了解大脑如何利用后续信息,改变我们对最初所听内容的感知。
听听看
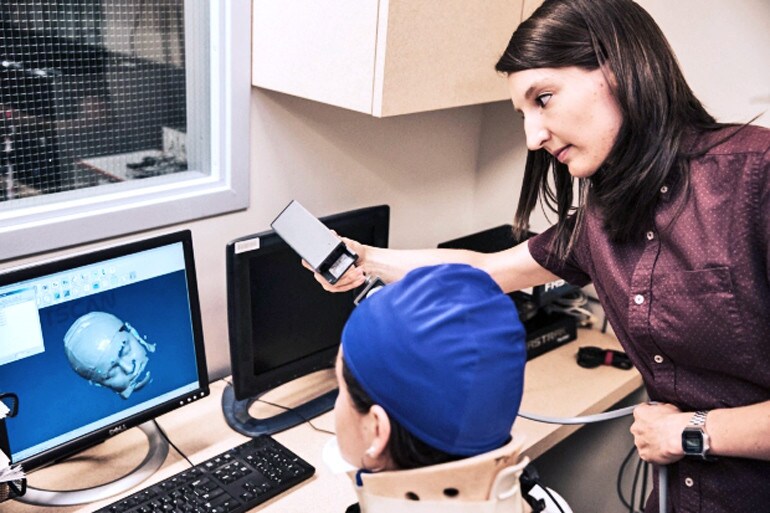
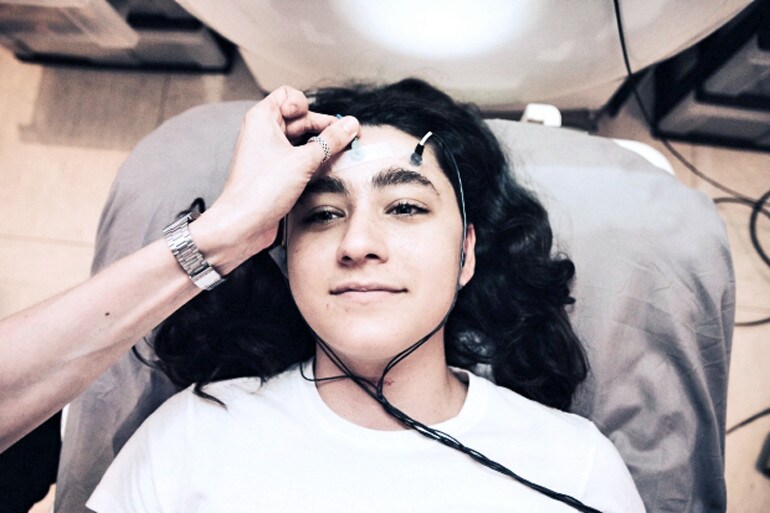
为此,他们开展了一系列实验,让受试者聆听单独的音节以及发音相似的词语(例如 barricade、parakeet)。为了测量受试者的大脑活动,科学家采用了脑磁图(MEG)技术。该技术通过记录大脑产生的电流所形成的磁场,描绘神经活动。
电磁体连接在参与者头部,用于确定头部在机器内的位置。(图片来源:Kate Lord/纽约大学)
研究得出了三项主要发现:
声音开始后仅50毫秒,大脑初级听觉皮层就会对语音的模糊程度作出反应。大脑在解读后续声音时会“重放”先前听到的语音,这表明随着词语其余部分逐渐展开,大脑会重新评估解读结果。大约半秒后,大脑会确定对信号的“最佳猜测”并据此作出判断。
“有趣的是,这种语境可能出现在所解读的声音之后,却仍然能够改变我们对声音的感知,”威廉姆斯补充道。
例如,同一个声音在“kiss”一词开头会被听成“k”,在“gift”一词开头则会被听成“g”,尽管两个词的差别(“ss”与“ft”)出现在这个模糊声音之后。
“具体来说,我们发现,听觉系统会在听觉皮层中主动保留声学信号,同时猜测所听词语的身份,”威廉姆斯说。“这种处理策略既能让人迅速获取信息内容,也允许重新分析声学信号,从而减少听错。”
这项研究由纽约大学阿布扎比分校研究所、欧洲研究委员会、法国国家研究署和美国国立卫生研究院资助。
纽约大学和约翰斯·霍普金斯大学的其他研究人员也参与了这项工作。




