全世界都熟悉新冠感染和死亡模型以及“拉平曲线”的概念,但很难判断哪些模型值得信赖。
模型极大地改变了卫生官员、政策制定者和公民的行为。
因此,行为的改变减少了死亡人数,使最初模型中的估计看起来并不准确。
在人类历史上,或许没有哪种数据模型比新冠感染和死亡曲线更为人熟知。从印度的农民到美国疾病控制与预防中心(CDC)的主任,几乎每个人如今都对其十分熟悉。
但这些模型也因前后不一致而受到批评。伦敦帝国学院早期开发的一个模型预测,美国死亡人数将超过220万,但随后的模型(例如华盛顿大学的IHME——健康指标与评估研究所)预测的死亡人数则显著更低。我们应该相信哪些模型?
新冠病毒仍在全球以令人恐惧和凶猛的速度蔓延,并常常伴随错误信息的传播。各国政府、组织和民众都在迫切寻求关于防护措施、如何有效应对,以及这场噩梦将持续多久的真相。要获得这些答案,我们需要准确、全面的模型。而要构建这些模型,我们就需要细究模型究竟是如何运作的。
“所有模型都是错误的,但有些是有用的。”
这一说法被归于英国统计学家乔治·博克斯名下,他后来写道:“所有模型都是近似的。”
因此,我们需要问的问题不是“这个模型是否正确?”(它从来都不是正确的。)我们需要问的是:“这个模型对于这一特定应用是否足够好?”
模型从其定义上看,就是对某一系统的表征,它突出某些组成部分而忽略其他部分。因此,模型永远无法反映现实的所有方面。
不过,了解模型何时以及为何出错,仍然具有启发意义。
模型基于假设,即对现实中应当纳入和排除哪些内容所作的假设。模型还基于对模型各组成部分之间如何相互作用的假设。例如,存在一类流行病学模型,它们纳入了疾病的某些方面而忽略了其他方面。SIR模型考察个体的易感性(Susceptibility)、感染(Infection)和康复(Recovery);SIS模型考察易感性(Susceptibility)、感染(Infection)以及再次易感(Susceptibility),如同普通感冒的反复发作。SIRD模型在SIR模型的基础上加入了“死亡”(Deceased);而SEIR模型则在传染病存在潜伏期时考虑了“暴露”(Exposure)。SEIR和SIRD是目前新冠疫情中普遍使用的两种模型类型。
数据对于构建模型和验证其准确性至关重要——向模型输入不准确的数据,必然产生不准确的结果。就新冠疫情而言,我们需要向模型输入国家、州和/或县一级的新冠病毒病例数、住院人数和死亡人数。我们可能拥有不完整的数据(例如,偏远地区可能难以收集和共享数据),也可能拥有不准确的数据(例如,在疫情初期,死亡病例可能与其他继发性疾病有关,并可能被错误归类)。
最后,尽管我们已竭尽全力,但仍存在不确定性——即模型中我们不知道、也可能永远无法确定的方面。新冠病毒的感染率、潜伏期和康复率仍存在诸多不确定性,而这些因素都会影响传播率。此外,我们仍不清楚病毒对人口不同群体的影响。除疾病本身的不确定性外,我们还面临政策和行为方面的不确定性。我们无法断言各国政府和机构将如何应对这场危机,也无法断言公民和员工在这些紧张情况下将如何行事。
那么,既然模型可能出错,为何还要构建它们?它们有何用途?
模型传统上是基于以下用途而构建的:
解释。 许多模型的构建旨在解释某一现象,从现实世界的“杂乱”中抽象出来,或得出可用于未来情境的见解。例如,构建模型以了解埃博拉和禽流感等传染病过去暴发时的传播率,有助于制定干预措施。了解2003年严重急性呼吸综合征冠状病毒(SARS-CoV)如何在多个国家传播,可为新冠病毒(SARS-CoV-2)提供有益线索。
预测。 当拥有充足的历史数据且所处环境相对稳定时,模型可用于预测未来。然而,当不确定性较高时,模型通常用于预测一系列反映内在不确定性的结果。随着我们对病毒及其应对反应的了解不断增多,我们可以降低这种不确定性。目前的新冠模型通常会给出病例数、住院人数和死亡人数的区间范围。
行为改变。 模型可用于改变人们的行为。我们都熟悉那些就应阅读哪些书籍、应购买哪些产品提出建议的模型。同样,新冠模型已经改变了卫生官员、政策制定者、政府机构和公民的态度与行为。
因此,尽管我们可以认为新冠模型“存在错误”,但它们仍被证明是有用的。
有些模型是有用的,少数模型还能改变行为。
仅仅三个月内,社会各阶层的行为都发生了巨大变化,尤其是政府官员、政策制定者以及公民。
卫生官员和政策制定者 对新冠模型的预测做出了回应,尽管这些预测存在不确定性,他们仍采取了补救措施。新冠政府应对追踪器发布了严格指数,该指数考察了针对病毒的13项措施,包括学校和工作场所关闭、取消公共活动以及旅行限制——在其他任何情况下,这些措施都会被视为严苛至极。
针对政府干预措施,公民大体上遵守了限制措施并改变了行为。他们减少出行、居家隔离、保持社交距离,并更加注重消毒。他们的消费行为也发生了变化:更多地在网上购物而非前往实体店,并且随着社交活动和娱乐大量转移到线上,他们的网络带宽消耗也有所增加。
这些行为变化自然影响了新冠病毒的关键参数,从而改变了数据。
当行为发生变化时,新数据将胜过模型。
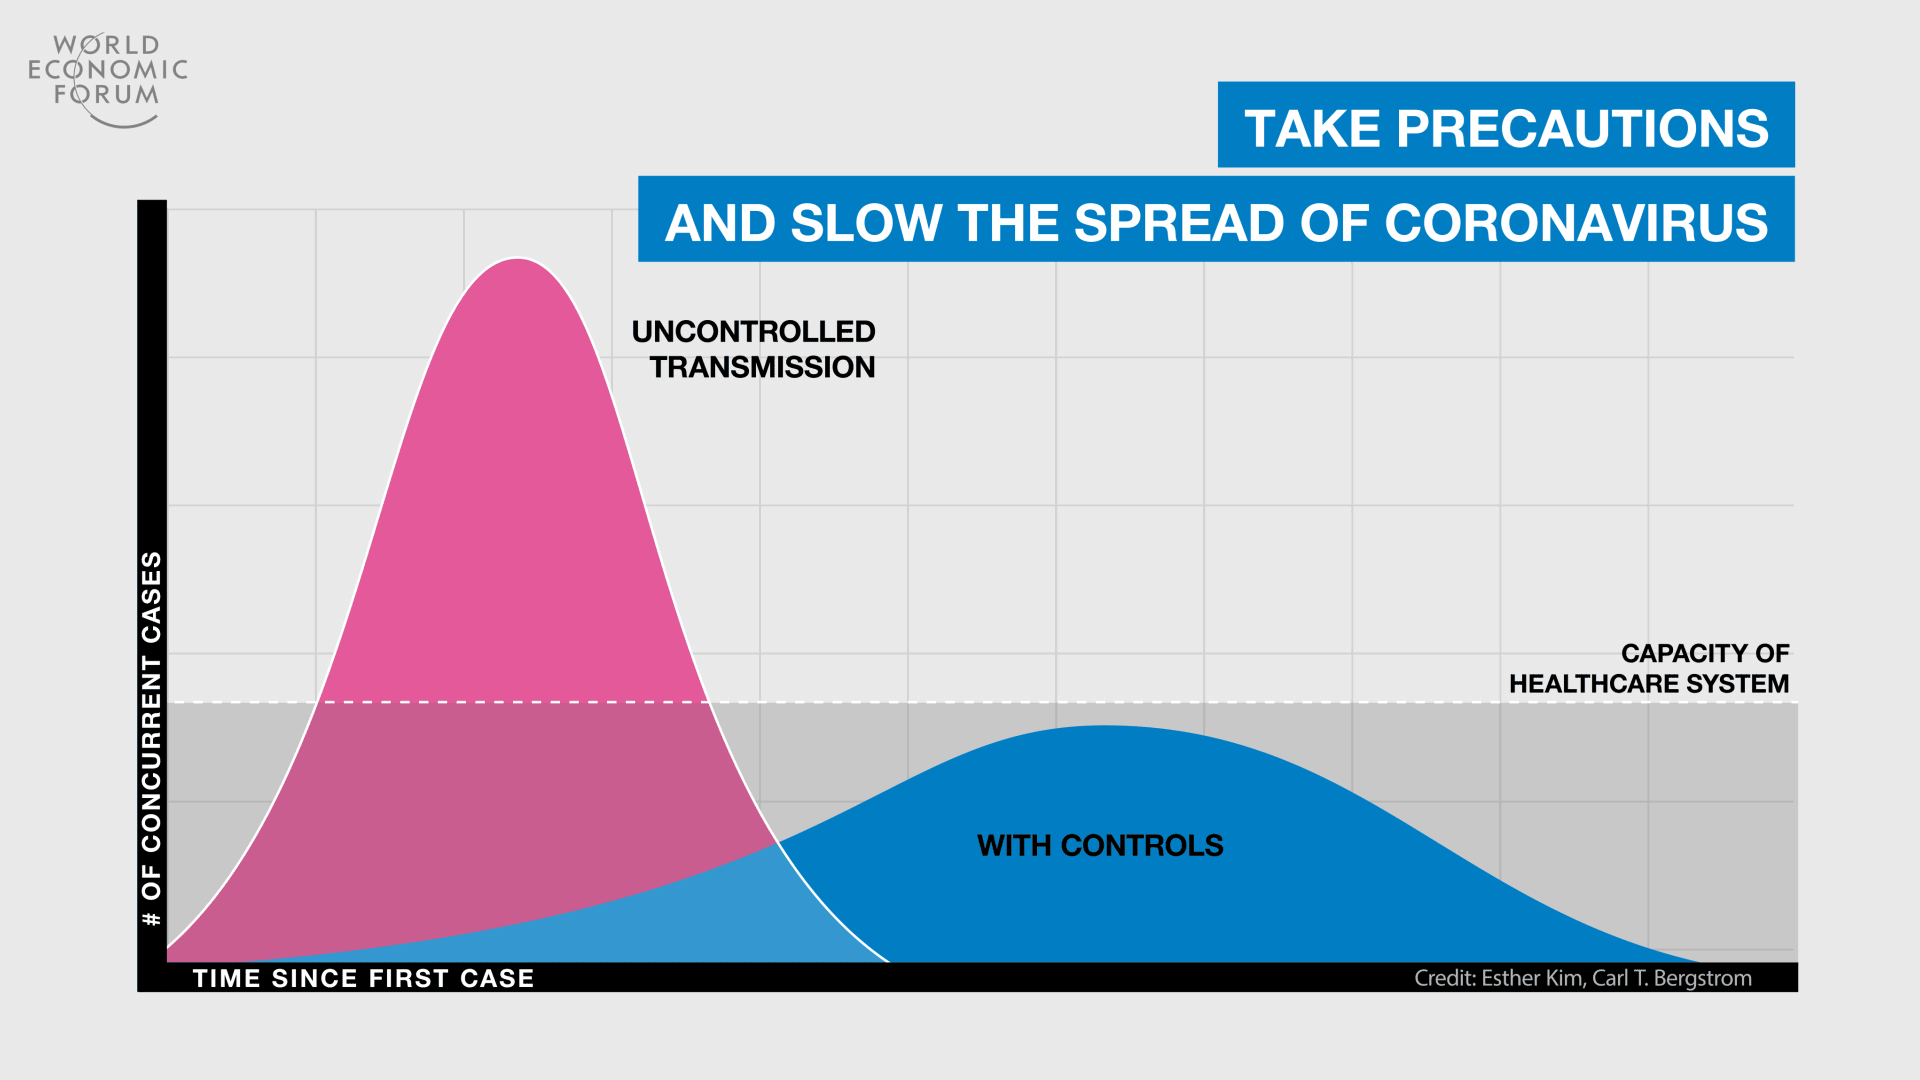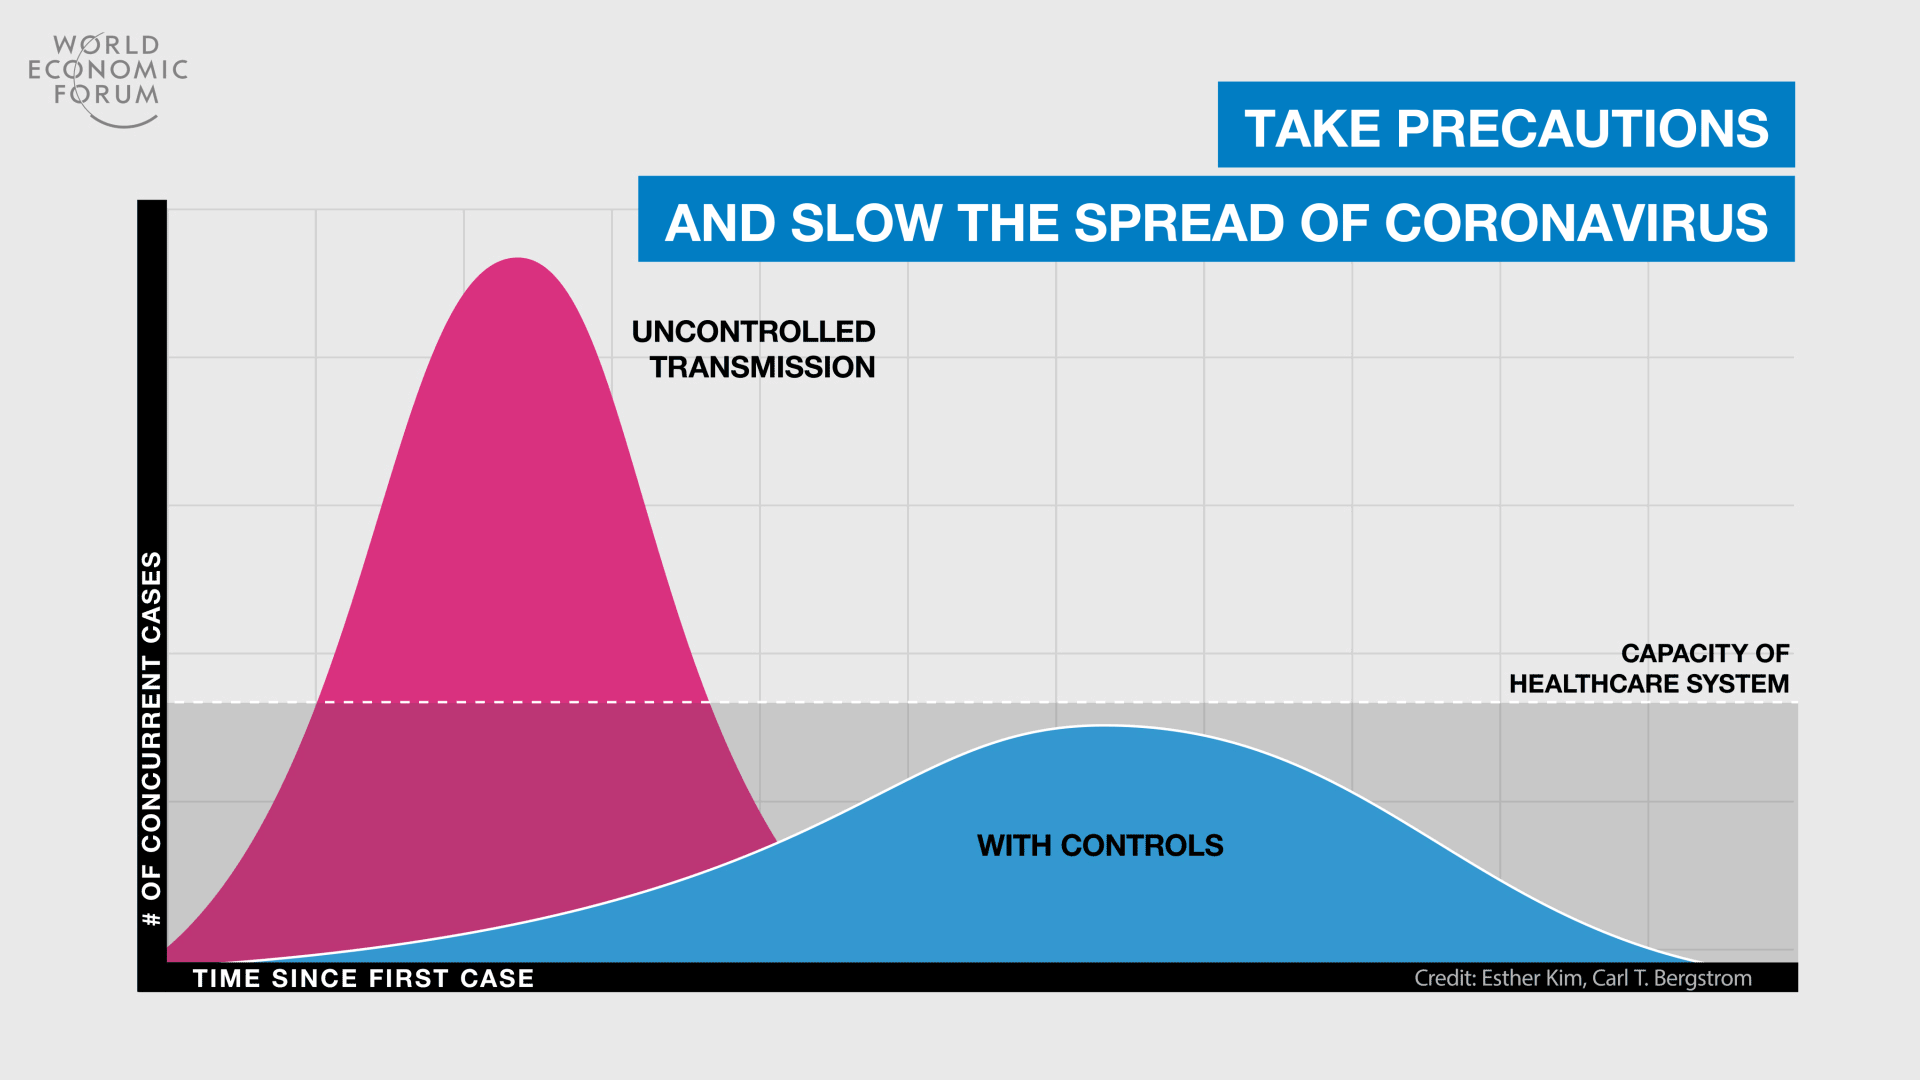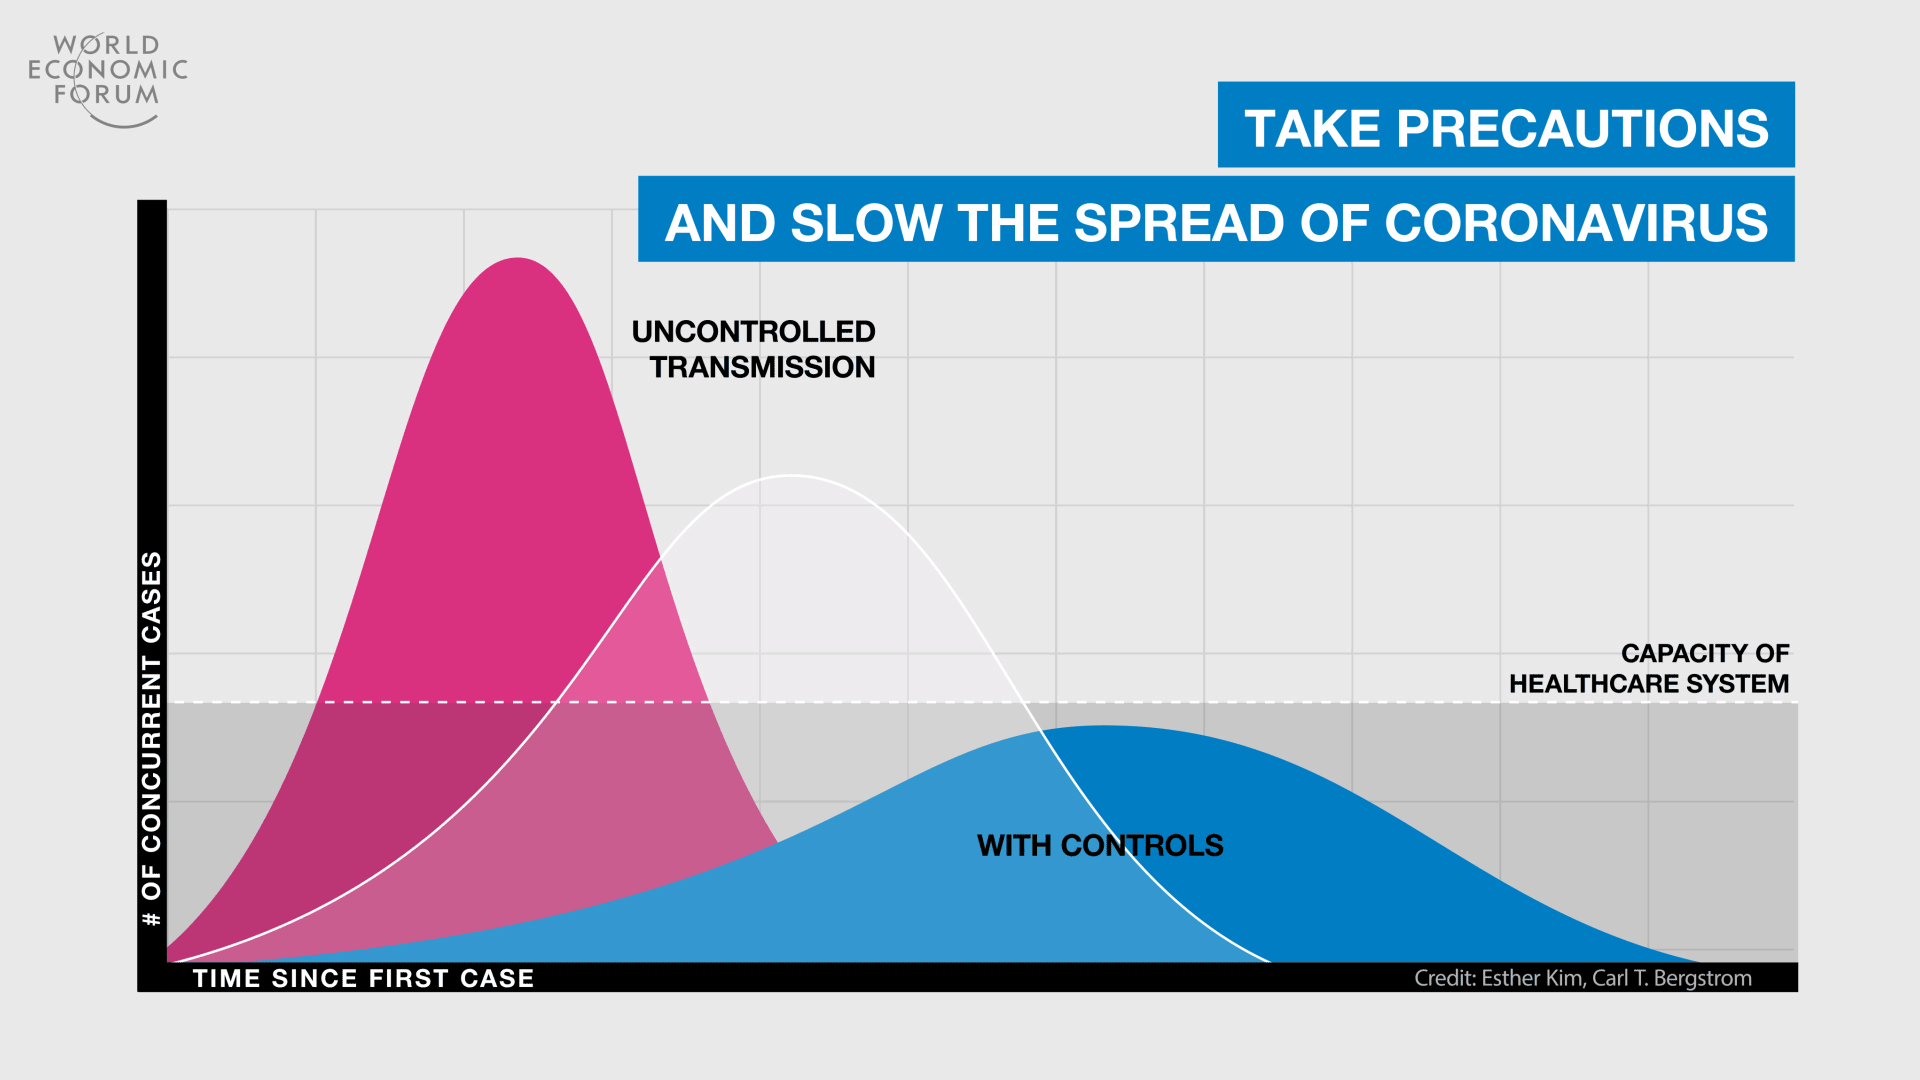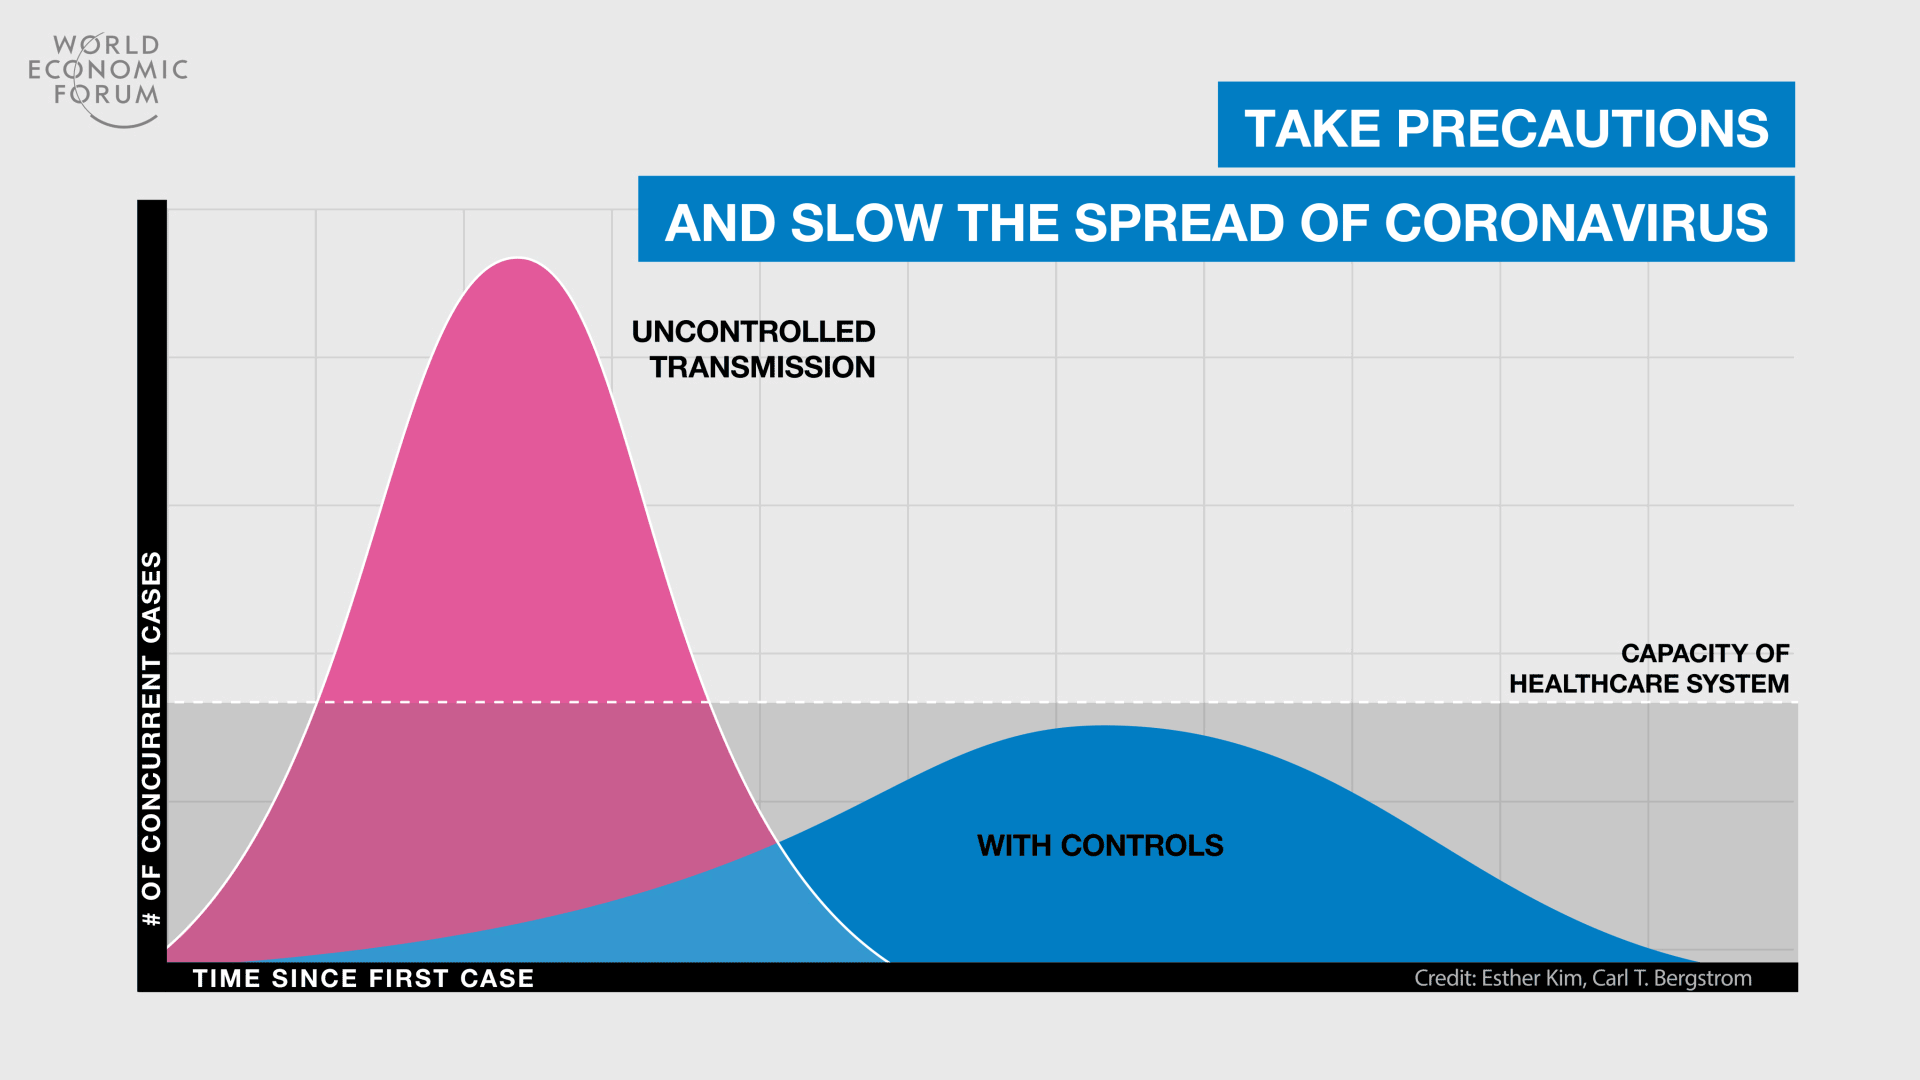
在所有受影响国家,新冠感染、住院和死亡曲线在媒体的放大下广为人知,民众被敦促“居家避难”和“拉平曲线”。由于行为的变化,两组数据也随之改变。
病例数据。随着越来越多的人了解病毒并接收到保持社交距离的信息,他们或部分或完全地无视或听从了安全警告。个人选择取决于多种因素,包括年龄、社会价值观(服从权威或自由主义),以及工作的经济必要性等。随着各国和美国各州新增病例与住院人数开始下降,这虽达到了减少死亡的预期效果,但也反过来使最初的预测显得不切实际地悲观(即错误),从而使模型开发者面临批评。
失业数据。 关闭企业和学校等干预措施使经济活动陷入停滞,导致大量商品和服务的需求大幅减少。这也使美国和其他国家的失业率升至创纪录水平——达到自1929年大萧条以来从未见过的数字。这进而引发了要求重启经济的呼声。虽然经济活动确实需要重新启动,但我们重启的方式很可能对此次疫情造成的死亡总人数产生重大影响。
正是这些干预措施的影响,促使国家过敏与传染病研究所所长安东尼·福奇博士发表评论称:“当真实数据出现时,在我看来,数据始终胜过任何模型。”
世界经济论坛在应对冠状病毒疫情方面采取了哪些行动?
新冠模型最初是基于现有的全部数据,并结合关于疾病进展的假设而构建的。这些模型突出了各种可能结果的范围,促使政策制定者和公民改变行为——从而使实际死亡人数显著低于最初的估计。
模型通过减少死亡人数实现了其目的,因此应被视为成功。
反事实问题——“如果我们不采取任何行动,这些模型会有多准确?”——理论上是可以回答的。但就人命代价而言,这一答案过于昂贵,不值得去追寻。




