新技术使近乎实时地收集冠状病毒数据成为可能。
快速生成数据会增加数据准确性和可靠性方面的风险。
决策者将在新数据出现时调整政策,以维护信任。
在人们的有生之年,世界从未经历过像我们如今面对的 COVID-19 这样规模的疫情。世界也从未能够获取有关 SARS-CoV-2 病毒本身的数据和分析,其中许多数据和分析都是快速生成并免费传播的。要走出这场危机,就必须将这些数据有效地纳入决策。
即使在最好的时候,这也不是一项容易的任务。如今更是难上加难,因为导致这场疫情的 SARS-CoV-2 病毒对人类而言是新出现的,它跨越物种屏障,从蝙蝠传来。就在四个月前,我们甚至无法回答有关这种病毒及其所致疾病的最基本问题——它的传染性有多强?这种疾病对人体的致病性(危害性)有多大?我们能否产生有效的免疫反应?我们正在边走边学。
我们以前也经历过类似情况,最近一次是导致 2012 年中东呼吸综合征(MERS)的冠状病毒;再往前,则是 2002 年的 SARS。当这些疾病首次在人类中出现时,我们对它们的了解和现在一样少。当年与现在的区别在于,我们如今能以多快的速度了解病毒及其所致疾病的基本生物学特征,以及我们如何在此过程中应对不确定性。
用于快速生成和传播数据的新技术,使近乎实时地收集和分析病毒数据成为可能。我们从未见过如此海量的数据以如此快的速度生成和共享,有时这也带来了超出我们所希望的不确定性。但这种病毒传播和演变的速度与规模意味着,从未有这么多人如此迫切地需要这些数据。
回想 1 月疫情开始时,病毒从中国武汉的起源地开始向世界各地传播。当时还没有疫苗,唯一可用的公共卫生干预手段是遏制疫情,而有效遏制需要知道病毒在哪里,以及它在人与人之间传播得有多快。在区域层面开展快速诊断和大规模检测,以发现病例并追踪其接触者,至关重要;台湾、新加坡和韩国等地早期项目的成效台湾、新加坡和韩国便证明了这一点。
哪怕只延误几天,也可能酿成灾难,意大利最先领教了这一点。展望未来,新的即时诊断工具能够在不到一小时内从采集拭子样本到给出检测结果,对于扩大检测的规模和覆盖范围将不可或缺。
准确掌握数字确实是一项挑战。目前,最佳估计是:每一例 SARS-CoV-2 感染平均会导致另外 2.5 人感染。但疾病传播动态存在不确定性,这意味着该数字可能大幅波动,预期死亡总人数也会随之变化。流行病学模型的预测质量取决于我们输入的数据。政策制定者必须愿意接受预测中的不确定性,并据此调整建议。
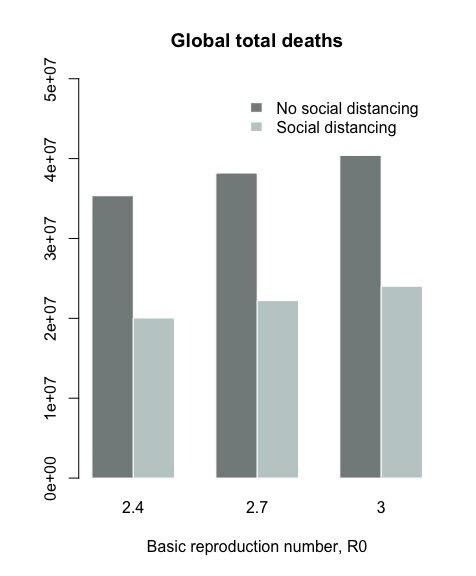
洗手、保持社交距离和隔离等公共卫生措施,旨在尽可能降低新发感染的平均人数,理想情况下将其降至 1 以下。在这一水平,病毒将得到遏制。事实上,在疫情最严峻的当下,所有决策都应以此为出发点。展望未来,将不得不作出艰难抉择,在权衡公共卫生与对经济、个人自由和公众信任的影响时尤须如此。
快速变化的形势给决策者带来了另一项挑战。随着更多证据浮现,一天看似成立的结论,第二天可能就不再成立。COVID-19 初期死亡率估算就是一个例子。病例病死率(CFR;确诊感染者中死亡者所占比例)最初于 1 月被报告为最高达 15%,但随着信息增多且质量提高,这一数字已持续下调至约 1%。决策者需要准备好根据新信息修订建议,并准备好向公众公开、坦诚地解释这些变化。
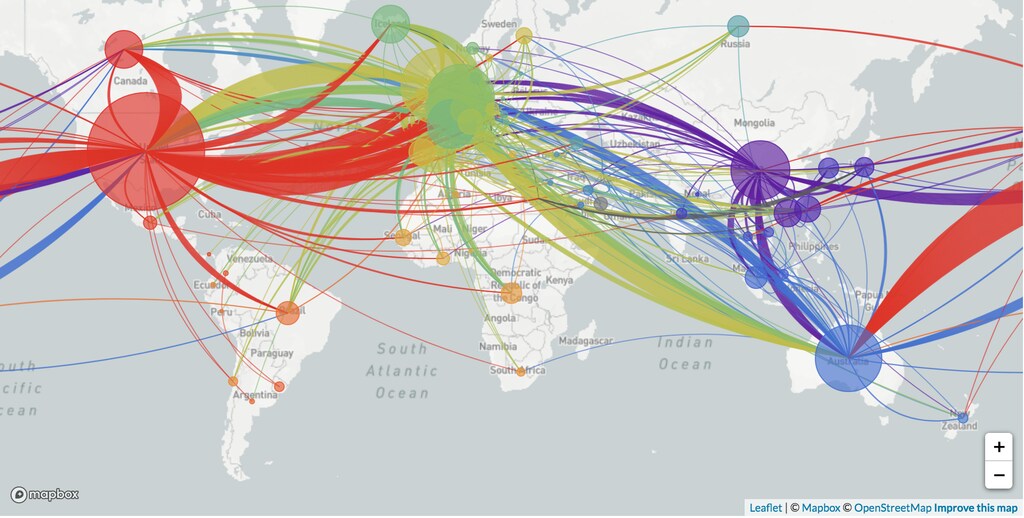
数据生成的惊人速度带来了独特机遇。以基因组数据的增长为例。武汉原始毒株的基因序列于 2019 年 12 月中旬上传。截至本文撰写时,可供分析的 SARS-CoV-2 毒株已接近 4,000 种。数据增长的速度简直令人震惊。病毒演变迅速,大约每两周就会累积一次突变。GISAID.org 等公共数据库有助于管理和理解这些数据;而 nextstrain.org 等分析平台则可实现近乎GISAID.org;而nextstrain.org,可实现近乎实时追踪病毒的演变和传播。
在这种数据快速生成、广泛共享的环境下,数据的准确性和可靠性也面临额外风险。通常缓慢而审慎的结果评估流程已经加快,增加了出错的可能性。与 medRxiv、bioRxiv 和 virological.org 等预印本服务器(汇集尚未经过正式同行评审和发表的学术论文)相关的线上论坛正在开展更非正式、开放的同行评审,在一定程度上降低了这些风险,甚至 Twitter 上也有此类讨论。
多个团队研究同一个问题也有帮助。如果他们独立工作、采用略有不同的方法,却都得出相同答案,我们就可以相当确信这个结果是可靠的。政策制定者不妨谨记已故生物学家理查德·莱文斯关于使用数学模型的建议:我们的真相是彼此独立的谎言的交集。面对浩瀚的科学文献时,道理也一样。
SARS-CoV-2 跨越物种界限进入人类,并沿着我们编织的错综复杂的全球联系网络,从一个国家迅速传播到另一个国家。这是由我们自己造成的问题。幸运的是,我们如今有了更有效的手段来加以控制。快速收集和分析数据的新工具,让决策者更容易获得合适的证据。
这还不够。建立协调一致的全球应对方式,需要一个战略论坛;此外,也应将流行病学家纳入他们过去通常不会任职的政策部门,例如城市的城市规划部门。最重要的是,决策者需要维护公众信任。首先要倾听科学意见,在新数据出现时调整政策,并向公众清楚地解释这些变化。




