它被称为“隐私悖论”:人们表示希望在网上保护自己的数据隐私,但往往很少采取措施确保其安全。
为什么?
我们提出,认为这是因为人们觉得数据难以拥有——而我们不拥有的东西,往往不会去保护。这是一个心理层面而非法律层面的所有权问题,而在解释我们为何会珍视那些被我们称为“我的”的事物方面,心理所有权更具解释力。
拥有数据与拥有汽车不同。如果有人使用你的汽车、把车租给他人或将其偷走,你会察觉到,也会在意。但我们的数据可能在未经许可的情况下被使用、转售或窃取,而我们往往从未真正察觉,也不太担心。
我们很难主张并评估数据点的价值。由于数据无形、不可见且复杂,我们对其掌控较少,了解不深,投入也少,因此很难拥有它们。
难以主张所有权
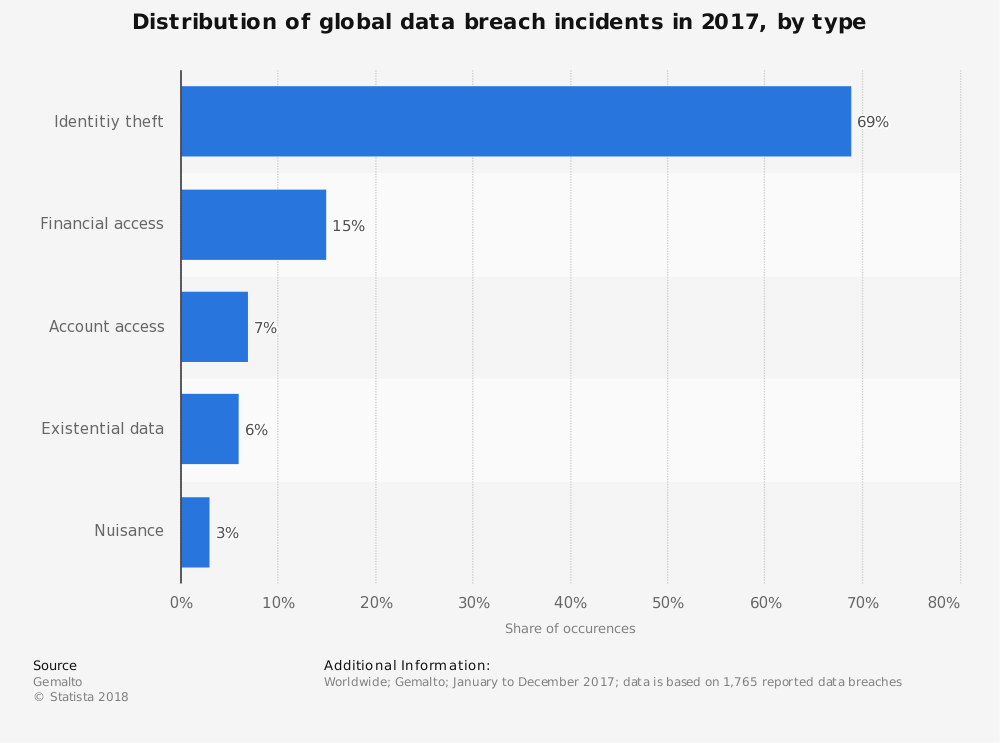
数据的无形性使我们难以主张所有权。
与物品不同,数据可以被多人同时使用。我们很难知道当前是否只有自己在主张对该数据的权利,也很难排除他人这样做。而且与物品不同,反复使用不会损耗或在数据上留下痕迹。由于数据可以轻易复制,我们并不会因此失去什么实物。我们甚至无法察觉数据是否正在被收集。这削弱了我们主张数据所有权、阻止数据被夺走的能力。
难以估值
通常,我们只拥有和保护有价值或有意义的东西。然而,消费者并不知道自己的个人数据点实际有多大价值。部分原因在于,所谓海量的数据往往被认为价值较低。除姓名或出生日期等少数信息外,单个数据点本身几乎没有价值。只有与其他数据(无论是同一人还是其他人的数据)结合后,它们才会产生价值。这种情况可能通过用户画像分析。
这种价值的掩盖因应用权限而加剧,这些权限往往会请求打包的数据,例如“所有联系人”,而不是特定且有意义的联系人,例如“你母亲的电话号码”。由于消费者往往对具体数据点与打包数据赋予相似的价值,因此并不认为交出数百位联系人的详细信息有何价值。
难以界定所有权归属
归属认定是所有权形成的过程中的关键。我们越是认为某人通过劳动使数据得以产生,就越会将所有权归于此人。
即使是明确界定的信息,消费者对于数据点在多大程度上真正属于自己。但大多数数据并未得到明确界定。与任何原材料一样,原始数据点(例如你的年龄)本质上具有可塑性。在我们不知情的情况下,它们可能被转换、组合和加工,通过他人的劳动产生有价值的东西。这使得很难确定数据究竟属于谁。
还有一些个人数据是共同拥有的。例如,网购数据由您和零售商共同拥有。
数据的这些特性也削弱了我们在感知自身拥有某物时所需经历的过程,即:控制、深入了解和自我投入。
缺乏控制
我们很难控制自身的数据点,因为它们不可见、无形,且日益多样化。例如,身体指标、位置信息、照片和联系人都是伴随我们生活而产生的数据点。若不改变生活方式,我们就无法控制这些数据点。
个人数据极为复杂,规模庞大,超出了我们的理解能力。这是阻碍人们获得掌控体验的另一个根本性障碍。
缺乏深入了解
个人数据既与我们息息相关,我们理应对其有所了解,这看似显而易见,实则不然。个人数据来自许多不引人注意的来源,例如联网设备,并且是被动收集的。数据在很大程度上是不可见的,也不会大张旗鼓地提醒我们它们的存在。这使我们无法对其形成深入了解。更糟糕的是,超过90%的人未能完全理解旨在解释数据收集情况并增进我们认知的权限。
缺乏自我投入
数据作为我们存在的副产品,还有一个后果:我们几乎无需投入精力就能产生数据。例如,无论我们是否愿意,都会产生位置数据。只有照片可能需要我们投入一些精力,但它们在我们的数据中只占很小一部分。
隐私悖论之所以存在,是因为个人数据是难以拥有和保护的财产。
通过实体下载,正如Facebook近期所做的那样,或通过支付为数据付费,赋予数据价值并界定所有权,可以让我们获得更多控制力、认知和投入。




