当电力公司想要建设一座新的风电场时,通常会聘请顾问在拟选站点进行为期8至12个月的风速测量。这些测量数据会与历史数据进行关联,并用于评估该站点的发电能力。
在本月晚些时候举行的国际人工智能联合会议上,MIT研究人员将展示一种新的统计技术,即使仅使用三个月的数据,其风速预测效果也优于现有技术。这有助于电力公司节省时间和成本,尤其是在评估海上风电场选址方面,因为维护测量站在海上尤为高昂。
“我们与风电行业的人士交流后发现,他们在估算站点风能资源时采用的是一种非常非常简单化的机制,”麻省理工学院计算机科学与人工智能实验室(CSAIL)的研究科学家、本文第一作者Kalyan Veeramachaneni说。具体而言,Veeramachaneni表示,行业的标准做法是使用所谓的高斯分布(即基础统计学中熟悉的“钟形曲线”)来对风速数据的相关性进行建模。
“这里的数据并非高斯分布,这一点我们都清楚,”Veeramachaneni说,“你可以用钟形曲线去拟合它,但那并不能准确反映数据。”
通常,风能咨询人员会找出拟建站点的风速测量数据与同一时期在附近气象站所做测量数据之间的相关性,而该气象站拥有可追溯数十年的记录。基于这些相关性,咨询人员会调整该气象站的历史数据,以近似推算新站点的风速。
这一相关模型在统计学中被称为联合分布。这意味着它表示的不仅是某一站点出现某一特定测量值的概率,还包括该测量值与另一站点某一特定测量值同时出现的概率。Veeramachaneni表示,风电行业的咨询人员通常将这种联合分布刻画为高斯分布。
不同的曲线
Veeramachaneni与同事Una-May O’Reilly(CSAIL首席研究科学家)以及Universidad Rey Juan Carlos(马德里)的Alfredo Cuesta-Infante共同开发的模型,其首要创新之处在于能够纳入多个气象站的数据。在部分分析中,研究人员使用了来自15个或更多其他站点的数据。
但其主要优势在于,它并不局限于高斯概率分布。此外,它可以使用不同类型的分布来刻画不同站点的数据,并以多种方式将其组合。它甚至可以使用所谓的非参数分布,即数据不是由数学函数描述,而是由一组样本描述,这与数字音乐文件由连续声波的离散样本构成颇为相似。
标准 回归分析,这是风电行业常用的一类方法,依据某种距离度量,找出最能近似一组散点数据的直线。但通常,弯曲的曲线能提供更好的近似。研究人员的模型允许这种可能性。
验证
研究人员首先将其技术应用于MIT博物馆屋顶上一台风速计所收集的数据,该博物馆当时希望在屋顶安装风力涡轮机。一旦有证据表明其模型的准确性,他们便将其应用于一家风电行业大型咨询公司提供给他们的数据。
借助该公司某一风电场站点三个月的历史数据,Veeramachaneni及其同事能够将未来两年的风速预测准确度提高到现有模型使用八个月数据时的三倍。此后,研究人员通过评估计算联合分布的替代方法改进了模型。根据本文新论文中报告的、对科学博物馆数据的额外分析,其修订后的方法可将预测准确度提高一倍。
南洋理工大学电气工程助理教授Justin Dauwels是“Copula”(连接函数)方面的专家,这是麻省理工研究人员用于耦合不同类型概率分布的统计技术。Dauwels说:“Veeramachaneni的团队提出了一种非常适合重要现实应用的模型。”他continued说道:“通过准确描述非高斯统计特征,基于Copula的模型明显优于经典高斯模型,能够利用少得多的测量数据,在测试地点提供准确的边际分布。这种方法具有很强的实用价值,我确信它将适用于许多其他现实问题。”
本文与 MIT News合作发表。发表本文并不意味着世界经济论坛认可其中的观点。
如需及时了解《Agenda》动态,请 订阅我们的每周简报。
作者:Larry Hardesty是MIT News的特约撰稿人。
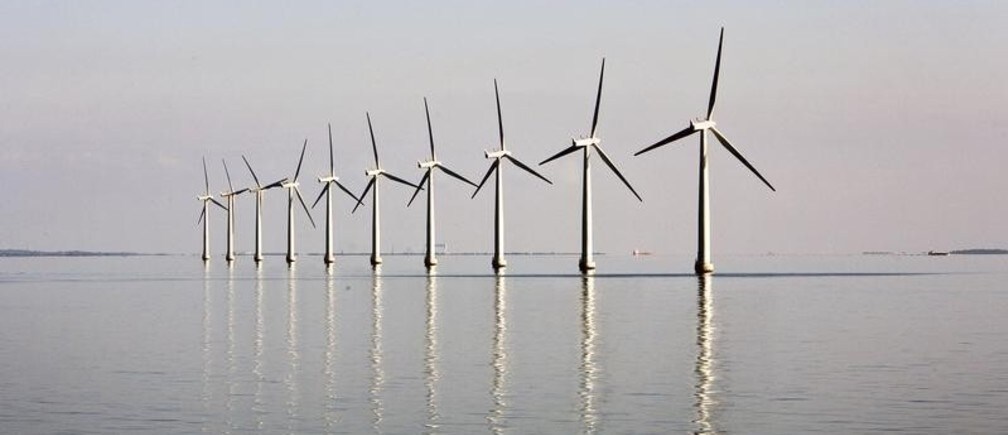
图片:2008年5月19日,一座海上风电场矗立在丹麦萨姆瑟岛附近的海水中。REUTERS/Bob Strong。


