作为全球社会的一员,我们面临诸多重大挑战——无论是应对气候变化、寻找新的能源和安全保障来源、治愈癌症,还是让数十亿同胞摆脱贫困。全球各地有数千人投身于解决这些问题,在数十个实验室和研究中心开展工作。他们正在生成大量与相关议题有关的数据;然而,我们正处于一个关口:数据多到造成了瓶颈。我们面临一个典型的“大海捞针”难题——找出最有用的数据。我们努力确定哪些数据可以共享,以及如何共享。我们也在努力理解数据如何为我们开启值得探索的新问题。
这是我们大胆而崭新的世界——一个即将迈入数据驱动的研究、创新与发现时代的世界。在 达沃斯世界经济论坛上,我们将探讨处理大型数据集所面临的挑战,以及大数据为应对不受国界限制的社会问题带来的近乎无限的机遇。我们将探讨如何通过有效筛选海量数据,帮助当今社会保护昨日的文明。我们将探讨解读数据如何帮助科学家分享来自单个难以寻获的标本的信息,从而让新的发现更有可能、更频繁地出现。我们还将探讨理解大数据如何推动人脑研究取得进展,并带来这样的愿景:也许不久的将来,一名曾经瘫痪的孩子能够像其他孩子一样自由、轻松地活动。
数据有件有趣的事:如果你在文献中查找“数据”,它总是带着负面联想——诸如“过载”和“洪流”这样的词。有了这些说法,难怪科学家和学者都会望而却步!但我们应该拥抱大型数据集,而不是抗拒它们。跨国公司正在学习如何处理大型数据集,而且一直在不断进步。但中型和小型企业并不具备这方面的专业能力。然而,如果小型企业也能处理海量数据,规模最大的公司将受益匪浅;这些小企业中有许多对大型公司的供应、生产和劳动力至关重要。轻松处理数据,能够为全球商业往来扫清障碍。
要实现这一愿景,就需要将数据及数据意识融入教育课程。我们需要在高等教育课程乃至中学阶段,教会学生如何使用海量数据。教育重点必须改变,否则我们的孩子将无法做好准备,应对他们每天必然会遇到的海量数据。
数据在传统学科之间架起桥梁,推动从人文学科到硬科学领域的发现与创新。数据消弭障碍,开辟新的沟通渠道、研究方向和商业机遇。数据将成为引擎,成为创造更美好世界的火花。
布朗大学应用数学教授扬·赫斯特哈芬。
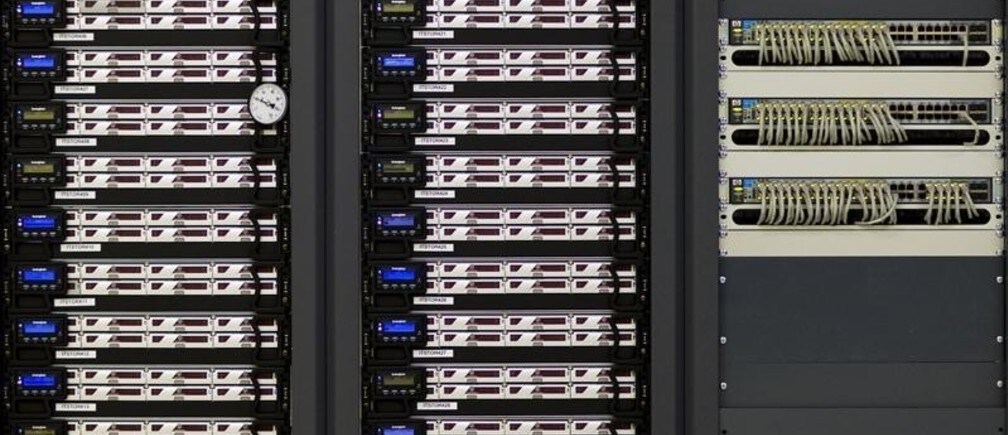
图示:2008年10月3日,日内瓦欧洲核子研究中心(CERN)大型强子对撞机(LHC)计算网格中心的一台服务器。该中心是参与网格计算项目的140个数据处理中心之一,这些中心分布在33个国家。每年应收集由LHC(大型强子对撞机)数亿次亚原子碰撞产生的超过1500万吉字节数据。路透社/Valentin Flauraud


